# Jednom po novom projektu
dir.create("data", showWarnings = FALSE)
dir.create("outputs", showWarnings = FALSE)Dodatak A — R praktikum
Praktikum je radni pratitelj knjige. Poglavlja se mogu čitati bez otvaranja koda, a ovaj dodatak pokazuje kako se iste analize izvode u R-u. Napisan je tako da se može čitati samostalno, od prve naredbe do gotove skripte, i ne pretpostavlja nikakvo prethodno iskustvo s programiranjem.
Kako čitati ovaj dodatak
Knjiga i praktikum imaju različite zadaće i vrijedi ih držati odvojenima. Poglavlja uče čitanje koda, jer je čitanje način na koji tvrdnja postaje provjerljiva. Praktikum uči pisanje, za čitatelja koji želi analizu ponoviti sam. Praktikum je dobrovoljan put za samostalno izvođenje analiza. Za zadatke u knjizi dovoljan je sadržaj poglavlja.
Primjeri idu od malih objekata prema tablicama, zatim prema čišćenju, grupiranju, preoblikovanju i grafovima, i završavaju skriptom koju možete predati zajedno s rezultatima. Gotovo svi rade na simuliranoj anketi anketa_mreze, koju knjiga koristi u poglavljima o opisivanju podataka. Skup ima 300 ispitanika i pet varijabli, a proizveden je kodom uz fiksno sjeme, pa nije nalaz o stvarnoj populaciji.
Male vektore i tablice u nastavku zadajemo ručno kao zasebne ilustracije za čitanje naredbi. Kada primjer koristi anketa_mreze, obrađuje istih 300 generiranih zapisa. Filtriranje izdvaja dio njih, prekodiranje mijenja vrijednost ili oznaku, a sažimanje pretvara više osobnih redaka u jedan skupni rezultat.
Preporučeni način čitanja je uz otvoren R. Prepišite kod i pokrenite ga, a zatim promijenite neki broj ili ime stupca i pogledajte što se dogodi. Razlika između čitanja i pisanja koda upravo je u tome što se pisanje uči jedino kroz pogreške koje sami napravite i popravite.
Za dublji rad s podacima izvan opsega ovog dodatka najkorisniji je slobodno dostupan priručnik R for Data Science, koji cijeli pristup tidyversea razrađuje sustavnije nego što je ovdje moguće (Wickham i sur. 2023.). Čitatelju koji uopće ne želi pisati kod Dodatak B nudi put kroz softver s izbornicima.
Alat i radni prostor
Za rad je potreban R, jezik i sustav za statističko računanje koji izvršava naredbe. Uređivačko okruženje može objediniti uređivanje skripte, konzolu, prikaz grafova i pregled stvorenih objekata, ali nije dio statističkoga postupka.
U ovom praktikumu radni tok opisujemo neovisno o konkretnom sučelju. Kod se piše u skripti i šalje na izvođenje na način koji nudi odabrano okruženje, a rezultat se provjerava u konzoli ili prikazu izlaza. Taj se postupak tijekom analize ponavlja mnogo puta.
Prije prvog koda vrijedi urediti mjesto na kojem će analiza živjeti. Naredbe analize zapisujemo u skriptu koju možemo ponovno pokrenuti, poslati kolegi i priložiti uz rad. Projektna mapa drži podatke, kod i rezultate na predvidljivim mjestima.
Funkcija dir.create() stvara mapu, a argument showWarnings = FALSE sprečava upozorenje ako mapa već postoji.
Mapa u kojoj R traži datoteke naziva se radnim direktorijem i može se provjeriti funkcijom getwd(). Uređivačka okruženja ga postavljaju na mapu projekta kada projekt otvorite kao projekt, a ne kao pojedinačnu datoteku. Odatle slijedi pravilo koje štedi mnogo živaca. Putanje pišite relativno prema mapi projekta, dakle "data/anketa-mreze.csv", a nikada apsolutno, dakle nikada "C:/Users/ime/Dokumenti/faks/data/anketa-mreze.csv". Apsolutna putanja radi samo na vašem računalu, jer na tuđem ne postoji mapa s vašim imenom. Relativna radi svugdje gdje se prenese cijela mapa projekta.
Preostaje učitati alate. Sav kod u ovom dodatku pretpostavlja da je na početku sesije izvršen sljedeći redak, koji učitava zbirku paketa opisanu niže u odjeljku o paketima. Ovo je jedini redak koji morate pokrenuti prije svih ostalih primjera.
Učitavanje knjižnih podataka
Primjeri ne ovise o objektima koji su ostali nakon čitanja nekog poglavlja. Preuzmite anketu o mrežama i sintetičku populaciju medijskih navika zajedno s projektnim mapama, a zatim ih na početku nove sesije učitajte ovim kodom. Oba skupa podataka stvorena su računalnom simulacijom za vježbu. U njihovim tablicama jedan redak predstavlja jednu zamišljenu osobu.
anketa_mreze <- read_csv(
  "data/anketa-mreze.csv",
  show_col_types = FALSE,
  locale = locale(encoding = "UTF-8")
)

populacija_medija <- read_csv(
  "data/populacija-medija.csv",
  show_col_types = FALSE,
  locale = locale(encoding = "UTF-8")
)
Prvi skup ima pitanje „Koliko vremena ljudi provode na mrežama i kako to ide uz povjerenje?”, a drugi „Kako se povjerenje u medije mijenja s dobi i izvorom vijesti?”. To su pitanja zapisana u katalogu podataka, a ne zaključci o stvarnim ljudima. Oba su skupa sintetička. Uvjeti ponovne uporabe stoje uz anketu i populaciju. Provjerite da su se učitali očekivani stupci prije prve analize.
Prve naredbe i objekti
Najjednostavniji način da počnete jest da R tretirate kao kalkulator.
10 + 25[1] 35144 / 12[1] 122^10[1] 1024Redak koji počinje znakom # komentar je i R ga potpuno zanemaruje. Komentari služe vama i vašim čitateljima da objasnite zašto nešto radite, a ne što radite, jer se ovo drugo ionako vidi iz koda.
R poštuje uobičajeni redoslijed računskih operacija, pa se množenje i dijeljenje izvode prije zbrajanja i oduzimanja. Zagrade taj redoslijed mijenjaju i vrijedi ih pisati uvijek kada izraz nije očit na prvi pogled.
5 + 3 * 2[1] 11(5 + 3) * 2[1] 16Nekoliko računskih funkcija pojavljuje se stalno.
Funkcija sqrt() računa drugi korijen, abs() apsolutnu vrijednost, round() zaokružuje na zadani broj decimala, a log() bez drugog argumenta računa prirodni logaritam. Logaritam se u knjizi pojavljuje u poglavlju o sažimanju podataka, gdje raspodjelu s dugim desnim repom pretvara u simetričniju.
Rezultat računa možemo pohraniti i upotrijebiti poslije. Pohranjena vrijednost naziva se objektom, a stvara se operatorom pridruživanja <-, koji se čita kao „spremi desnu stranu pod imenom s lijeve strane”.
n_ispitanika <- 300
prosjek_minuta <- 87.3

ukupno_minuta <- n_ispitanika * prosjek_minuta
ukupno_minuta
[1] 26190Stvaranje objekta ne ispisuje ništa. Da biste vidjeli sadržaj, upišite njegovo ime samo za sebe.
Imena imaju stroga pravila i mekše navike. Ime mora počinjati slovom, ne smije sadržavati razmake ni posebne znakove osim točke i podvlake, a velika i mala slova razlikuju se, pa su prosjek i Prosjek dva različita objekta. Navika koju knjiga slijedi jest da su riječi odvojene podvlakom i sve je malim slovima, kao u prosjek_minuta. Ta je konvencija standard u zajednici oko tidyversea i čini kod čitljivijim od zgusnutih ili miješanih oblika.
Imena birajte opisno. Objekt nazvan x radi jednako dobro kao objekt nazvan prosjek_minuta, ali za dva tjedna nećete znati što je bio. Izbjegavajte i imena koja se poklapaju s postojećim funkcijama, poput mean, sum ili data, jer objekt tada zaklanja funkciju i proizvodi poruke o greškama koje je teško razumjeti. Rezervirane riječi jezika, među kojima su TRUE, FALSE, NULL, NA, if, else i function, uopće se ne mogu upotrijebiti kao imena.
Nova dodjela postojećem imenu zamjenjuje staru vrijednost bez upozorenja.
temperatura <- 22
temperatura <- 35
temperatura
[1] 35R vas neće pitati jeste li sigurni. Zbog toga isti objekt ne treba upotrebljavati za različite svrhe unutar iste analize. Ako trebate temperaturu zraka i temperaturu vode, napravite temp_zraka i temp_vode.
Vektori
U statistici gotovo nikada ne radimo s jednim brojem. Najjednostavnija struktura za više vrijednosti jest vektor, uređeni niz vrijednosti istog tipa, koji se stvara funkcijom c().
minute <- c(95, 22, 112, 45, 78, 8, 135, 55)
minute
[1] 95 22 112 45 78 8 135 55skupine <- c("mlađi", "stariji", "mlađi", "srednji",
"mlađi", "stariji", "mlađi", "srednji")
skupine[1] "mlađi" "stariji" "mlađi" "srednji" "mlađi" "stariji" "mlađi"
[8] "srednji"Tekstualne vrijednosti pišu se u navodnicima, brojčane ne.
Operacija nad vektorom automatski se primjenjuje na svaki njegov element. To se naziva vektorizacijom.
minute / 60[1] 1,5833333 0,3666667 1,8666667 0,7500000 1,3000000 0,1333333 2,2500000
[8] 0,9166667minute * 7[1] 665 154 784 315 546 56 945 385minute - mean(minute)[1] 26,25 -46,75 43,25 -23,75 9,25 -60,75 66,25 -13,75Kada napišete minute / 60, R dijeli svaki element sa šezdeset i vraća novi vektor iste duljine. Zahvaljujući tome jedna naredba preoblikuje tisuće vrijednosti jednako lako kao osam.
Druga skupina funkcija radi obrnuto i cijeli vektor sažima u jedan broj.
length(minute)[1] 8mean(minute)[1] 68,75median(minute)[1] 66,5sd(minute)[1] 44,18064range(minute)[1] 8 135sum(minute)[1] 550Funkcija length() vraća broj elemenata, mean() aritmetičku sredinu, median() medijan, sd() standardnu devijaciju, range() najmanju i najveću vrijednost, a sum() zbroj. Značenje svake od tih mjera razrađuje poglavlje o sažimanju podataka.
Pojedinim elementima pristupa se uglatim zagradama.
minute[3][1] 112minute[2:5][1] 22 112 45 78minute[minute > 100][1] 112 135sum(minute > 100)[1] 2Posljednja dva retka zaslužuju objašnjenje jer se obrazac ponavlja kroz cijeli R. Izraz minute > 100 proizvodi logički vektor, dakle niz vrijednosti TRUE i FALSE. Stavljen u uglate zagrade, taj vektor bira samo elemente za koje vrijedi TRUE. Predan funkciji sum(), on se prebrojava, jer R vrijednost TRUE računa kao jedinicu, a FALSE kao nulu. Zbrajanje logičkog vektora zato je najkraći način da odgovorite na pitanje koliko ih zadovoljava uvjet.
Brojanje počinje od jedinice. Prvi element je minute[1], ne minute[0]. Ako ste ranije radili u jezicima koji broje od nule, ovo je najčešći izvor zabune.
Za stvaranje nizova i ponavljanja korisne su dvije funkcije.
seq(from = 0, to = 100, by = 25)[1] 0 25 50 75 100[1] "A" "B" "A" "B" "A" "B"[1] "A" "A" "A" "B" "B" "B"Argument times ponavlja cijeli vektor, a each svaki element zasebno.
Tipovi podataka
Svaka vrijednost ima tip koji određuje što se s njom smije raditi. Četiri su tipa u praksi važna.
Brojčani tip obuhvaća sve brojeve. Tekstualni tip označava se navodnicima i s njim se ne može računati, pa se tekstovi spajaju funkcijom paste() umjesto zbrajanja. Logički tip ima samo vrijednosti TRUE i FALSE i nastaje usporedbama. Faktorski tip služi za kategorijalne varijable i pamti popis dopuštenih razina.
class(42)[1] "numeric"class("TikTok")[1] "character"class(TRUE)[1] "logical"paste0("n = ", 300)[1] "n = 300"Usporedbe proizvode logičke vrijednosti i koriste vlastite operatore.
10 > 5[1] TRUE10 == 10[1] TRUE10 != 5[1] TRUERazlika između jednog i dva znaka jednakosti izvor je vrlo čestih pogrešaka. Jedan znak = pridružuje vrijednost, dva znaka == provjeravaju jednakost i vraćaju TRUE ili FALSE.
Faktor je način na koji R prikazuje kategorijalne varijable, dakle nominalne i ordinalne mjere iz poglavlja o mjerenju. Uz vrijednosti pamti i popis razina, pa kategorije mogu imati zadani redoslijed koji nije abecedni.
[1] srednja     prvostupnik magistar    srednja     magistar
Levels: srednja < prvostupnik < magistar < doktorlevels(obrazovanje)[1] "srednja" "prvostupnik" "magistar" "doktor" Razina doktor postoji u popisu iako je nitko nema. Zahvaljujući tom svojstvu tablica frekvencija pokazuje i praznu kategoriju.
Tipove je moguće provjeriti i pretvarati.
tekst_broj <- "42"
class(tekst_broj)
[1] "character"pravi_broj <- as.numeric(tekst_broj)
pravi_broj + 10[1] 52Pretvorba je važna pri uvozu podataka. Stupac s brojevima u kojem se negdje pojavljuje riječ umjesto prazne ćelije bit će učitan kao tekst, pa se s njim neće moći računati dok ga ne pretvorite.
Nedostajuće vrijednosti
Stvarni podaci gotovo nikada nisu potpuni. Ispitanik preskoči pitanje, uređaj ne zabilježi mjerenje, datoteka dođe s praznom ćelijom. R za to ima posebnu oznaku NA, koja se ponaša drukčije od svega ostaloga i zaslužuje pažnju od prvog dana.
Uobičajeno zbrajanje i računanje sredine s vrijednošću NA vraćaju NA, jer za traženi rezultat nedostaje jedan podatak.
Rezultat nije broj. R ne pretpostavlja da nedostajuću vrijednost smijete zanemariti, jer ne zna kolika bi bila, a prosjek s njom i bez nje nije isti. Prisiljava vas da odluku donesete svjesno. Najčešća odluka izriče se argumentom na.rm = TRUE, koji nedostajuće vrijednosti izbacuje iz izračuna.
Postojanje nedostajućih vrijednosti provjerava se funkcijom is.na(), nikada usporedbom.
Posljednji redak vraća sam NA, a ne TRUE ili FALSE. Razlog je logičan kada se izrekne riječima. Ako ne znate koliko je netko visok i ne znate koliko je netko drugi visok, ne možete reći jesu li jednako visoki, pa je odgovor „ne znam”, a ne „ne”.
U tablici se nedostajuće vrijednosti prebrojavaju po svim stupcima odjednom, što je prvi korak pri svakom novom skupu podataka.
# A tibble: 1 × 6
  ispitanik   dob dobna_skupina_sifra dobna_skupina minute_dnevno povjerenje
      <int> <int>               <int>         <int>         <int>      <int>
1         0     0                   0             0             0          0
Simulirani skup nema nedostajućih vrijednosti, a stvarni podaci gotovo uvijek imaju. Nikada nemojte pretpostaviti da ih nema, jer i uredna datoteka nakon uvoza zna proizvesti NA na neočekivanim mjestima, primjerice ondje gdje je netko upisao razmak umjesto broja.
Za uklanjanje redaka s nedostajućim vrijednostima služi drop_na(), koja bez argumenata briše svaki redak s bilo kojim NA, a s imenom stupca samo one kojima nedostaje ta vrijednost.
# A tibble: 3 × 3
     id minute povjerenje
  <int>  <dbl>      <dbl>
1     1     60          7
2     3    120         NA
3 4 45 5drop_na(primjer_na)# A tibble: 2 × 3
id minute povjerenje
<int> <dbl> <dbl>
1 1 60 7
2 4 45 5Razlika među ta dva poziva veća je nego što izgleda. Prvi zadržava tri retka, drugi samo dva, jer briše i onaj kojemu nedostaje druga varijabla. Brisanje po cijeloj tablici zato lako odbaci mnogo više podataka nego što ste namjeravali, osobito kada tablica ima mnogo stupaca.
Obrnut postupak pretvara posebne oznake u NA, što treba svaki put kada je nedostatak podatka zapisan kao vrijednost.
sirovo <- c(60, 120, -99, 45, -99)
na_if(sirovo, -99)
[1] 60 120 NA 45 NAOdluka o postupanju s nedostajućim vrijednostima nije tehnička. Izbacivanje ispitanika koji nisu odgovorili mijenja sastav uzorka, a razlozi zbog kojih netko nije odgovorio obično su povezani s onim što se ispituje, kako pokazuje poglavlje o mjerenju i istraživačkom dizajnu. Argument na.rm = TRUE rješava računski problem i ostavlja sadržajni otvorenim, pa uz svaki rezultat vrijedi zabilježiti koliko je opažanja u njega ušlo.
Tablica i cjevovod
Vektor sadrži vrijednosti istog tipa, a stvarni podaci imaju i brojeve i tekst i kategorije za istog ispitanika. Za njih služi tablica, koju u tidyverseu predstavlja tibble. Svaki redak je jedno opažanje, svaki stupac jedna varijabla, a stupci mogu biti različitih tipova.
# A tibble: 6 × 4
     id   dob skupina minute
  <int> <dbl> <chr>    <dbl>
1     1    19 mlađi       95
2     2    52 stariji     22
3     3    21 mlađi      112
4     4    35 srednji     45
5     5    23 mlađi       78
6     6    61 stariji      8
Ispis tibblea odmah pokazuje tip svakog stupca ispod njegova imena, gdje <int> označava cijele brojeve, <dbl> decimalne, a <chr> tekst. Uz to ispisuje samo prvih deset redaka, pa vam velika tablica ne poplavi konzolu.
Pojedinom stupcu pristupa se znakom $.
Operator |>, koji se naziva cjevovodom, uzima rezultat lijeve strane i predaje ga kao prvi argument funkciji s desne strane. Čita se kao „pa onda”.
Zamislite da trebate uzeti tablicu, zadržati ispitanike mlađe od 30 godina i izračunati njihovo prosječno vrijeme. Bez cjevovoda to se piše na dva načina i oba su nezgrapna.
[1] 95[1] 95Cjevovod rješava oboje.
Ovaj se kod čita odozgo prema dolje kao rečenica. Uzmi anketu, pa onda zadrži retke u kojima je dob manja od 30, pa onda izvuci stupac s minutama, pa onda izračunaj prosjek. Redoslijed pisanja odgovara redoslijedu razmišljanja, što je razlog zbog kojeg knjiga taj oblik koristi svugdje.
Funkcija pull() izvlači jedan stupac kao vektor, čime radi isto što i $, ali se uklapa u cjevovod.
Paketi
R sam po sebi dolazi s temeljnim funkcijama, a najveći dio korisnog rada obavlja se pomoću paketa koje je razvila zajednica. Paket je zbirka funkcija, podataka i dokumentacije koju je netko napisao i objavio.
Ovaj se dodatak oslanja na tidyverse, skup paketa sa zajedničkim pristupom radu s podacima. Među njima su ggplot2 za grafove, dplyr za obradu podataka, tidyr za preoblikovanje, readr za uvoz, tibble za tablice, stringr za tekst i forcats za faktore.
Paket se instalira jednom, a učitava pri svakom pokretanju R-a. Instalacija je poput kupnje knjige, a učitavanje poput njezina otvaranja.
# Jednom, u konzoli
install.packages("tidyverse")

# Na početku svake skripte
library(tidyverse)
Naredbu install.packages() pokrećite u konzoli, a ne u skripti, jer ne želite da se paket iznova instalira pri svakom pokretanju analize. Naredba library() pripada vrhu skripte, jer R mora znati koje pakete koristite prije nego što naiđe na njihove funkcije.
Prva instalacija tidyversea traje nekoliko minuta jer povlači mnogo paketa odjednom. To je uobičajeno i ponavlja se samo pri nadogradnji.
Uvoz i prvi pogled
Najčešći format za podatke je CSV, obična tekstualna datoteka u kojoj su vrijednosti odvojene zarezima. Za uvoz služi funkcija read_csv() iz paketa readr.
anketa <- read_csv(
  "data/anketa-mreze.csv",
  show_col_types = FALSE,
  locale = locale(encoding = "UTF-8")
)
Obratite pozornost na podvlaku. Funkcija read_csv() s podvlakom brža je od starije read.csv() s točkom, vraća tibble i informativnije javlja kako je protumačila stupce. Spremanje ide obrnutim putem funkcijom write_csv(), pri čemu ciljna mapa mora postojati unaprijed.
write_csv(sazetak, "outputs/sazetak.csv")Ostatak dodatka koristi istu datoteku koju ste učitali u odjeljku o učitavanju. Provjera sažetka povezuje objavljenu datoteku sa skriptom koja ju je proizvela i kataloškim zapisom te omogućuje prepoznati odstupanje od dokumentirane inačice.
Kada dobijete nove podatke, prvo ih pogledajte. Utvrdite broj redaka i stupaca, njihove tipove i izgled prvih vrijednosti. Taj je pregled polazište analize.
glimpse(anketa_mreze)Rows: 300
Columns: 6
$ ispitanik <chr> "I001", "I002", "I003", "I004", "I005", "I006", "I…
$ dob <dbl> 22, 22, 24, 22, 22, 18, 23, 20, 20, 24, 24, 21, 19…
$ dobna_skupina_sifra <dbl> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,…
$ dobna_skupina <chr> "18 do 24", "18 do 24", "18 do 24", "18 do 24", "1…
$ minute_dnevno <dbl> 69, 53, 83, 67, 87, 38, 93, 115, 160, 65, 83, 38, …
$ povjerenje <dbl> 6, 8, 10, 7, 5, 7, 7, 4, 7, 7, 9, 7, 5, 6, 4, 5, 1…Funkcija glimpse() na jednom zaslonu pokazuje broj redaka i stupaca, ime i tip svakog stupca te prve vrijednosti. Za druge poglede služe još tri funkcije.
nrow(anketa_mreze)[1] 300names(anketa_mreze)[1] "ispitanik" "dob" "dobna_skupina_sifra"
[4] "dobna_skupina" "minute_dnevno" "povjerenje" head(anketa_mreze, 3)# A tibble: 3 × 6
ispitanik dob dobna_skupina_sifra dobna_skupina minute_dnevno povjerenje
<chr> <dbl> <dbl> <chr> <dbl> <dbl>
1 I001 22 1 18 do 24 69 6
2 I002 22 1 18 do 24 53 8
3 I003 24 1 18 do 24 83 10Za brzi pregled raspodjele brojčane varijable korisna je summary(), a za kategorijalnu count().
summary(anketa_mreze$minute_dnevno) Min. 1st Qu. Median Mean 3rd Qu. Max.
3,00 22,00 39,00 50,06 68,25 248,00 anketa_mreze |>
count(dobna_skupina)# A tibble: 4 × 2
dobna_skupina n
<chr> <int>
1 18 do 24 90
2 25 do 34 84
3 35 do 44 66
4 45 i više 60Funkcija count() prebrojava retke po kategorijama i vraća tibble. Argument sort = TRUE poreda rezultat od najčešće kategorije prema najrjeđoj.
Prosjek dnevnih minuta veći je od medijana, što je uskladivo s desnom asimetrijom, ali samo po sebi ne dokazuje dugi rep ni njegov uzrok. Oblik zato provjeravamo grafom i pregledom krajnjih vrijednosti.
Za vektore izvan tablice korisne su još tri funkcije. Funkcija sort() vraća poredane vrijednosti, unique() različite vrijednosti, a table() tablicu učestalosti.
[1] "TikTok" "Instagram" "YouTube" [1] 3table(platforme_sirovo)platforme_sirovo
Instagram TikTok YouTube
2 3 1 Funkcija count() radi isto što i table(), samo vraća tibble koji se uklapa u cjevovod, pa je u ovom pristupu češći izbor. Funkcija unique() ipak ostaje nezamjenjiva pri provjeri podataka, jer najbrže otkriva neočekivane vrijednosti u kategorijalnom stupcu, poput iste kategorije napisane na tri načina.
Glagoli obrade podataka
Podatke u paketu dplyr obrađujemo s pomoću nekoliko glagola koje povezujemo cjevovodom. Svaki uzima tablicu i vraća tablicu, zbog čega se mogu nizati bez ograničenja.
Glagol filter() bira retke koji zadovoljavaju uvjet.
# A tibble: 3 × 6
  ispitanik   dob dobna_skupina_sifra dobna_skupina minute_dnevno povjerenje
  <chr>     <dbl>               <dbl> <chr>                 <dbl>      <dbl>
1 I001         22                   1 18 do 24                 69          6
2 I002         22                   1 18 do 24                 53          8
3 I003 24 1 18 do 24 83 10Uvjeti se kombiniraju logičkim operatorima. Znak & znači „i”, znak | znači „ili”, a znak ! preokreće uvjet. Zarez među uvjetima unutar filter() radi isto što i &.
[1] 22[1] 53Kada provjeravate pripada li vrijednost jednoj od više kategorija, umjesto niza uvjeta spojenih znakom | upotrijebite operator %in%.
Čest početnički promašaj jest pisanje dobna_skupina == "18 do 24" | "25 do 34". Takav izraz javlja grešku jer znak | očekuje logičke vrijednosti, a drugi je dio samostalni znakovni niz. Cijelu usporedbu moguće je ponoviti s obje strane znaka |, ali operator %in% uklanja tu zamku i uz to je čitljiviji.
Za raspone postoji between().
Glagol select() bira stupce, a znak minus ih uklanja.
anketa_mreze |>
  select(ispitanik, dob, minute_dnevno) |>
  head(3)
# A tibble: 3 × 3
ispitanik dob minute_dnevno
<chr> <dbl> <dbl>
1 I001 22 69
2 I002 22 53
3 I003 24 83anketa_mreze |>
select(-ispitanik) |>
head(3)# A tibble: 3 × 5
dob dobna_skupina_sifra dobna_skupina minute_dnevno povjerenje
<dbl> <dbl> <chr> <dbl> <dbl>
1 22 1 18 do 24 69 6
2 22 1 18 do 24 53 8
3 24 1 18 do 24 83 10Uz imena, stupce je moguće birati pomoćnim funkcijama poput starts_with(), ends_with(), contains() i where().
anketa_mreze |>
  select(where(is.numeric)) |>
  head(3)
# A tibble: 3 × 4
dob dobna_skupina_sifra minute_dnevno povjerenje
<dbl> <dbl> <dbl> <dbl>
1 22 1 69 6
2 22 1 53 8
3 24 1 83 10Glagol rename() mijenja imena bez odbacivanja stupaca, a relocate() mijenja njihov redoslijed.
anketa_mreze |>
  rename(minute = minute_dnevno) |>
  names()
[1] "ispitanik" "dob" "dobna_skupina_sifra"
[4] "dobna_skupina" "minute" "povjerenje" Glagol mutate() stvara nove stupce ili mijenja postojeće.
anketa_mreze |>
  mutate(sati_dnevno = minute_dnevno / 60) |>
  select(ispitanik, minute_dnevno, sati_dnevno) |>
  head(3)
# A tibble: 3 × 3
ispitanik minute_dnevno sati_dnevno
<chr> <dbl> <dbl>
1 I001 69 1.15
2 I002 53 0.883
3 I003 83 1.38 Za rekodiranje u kategorije služe dvije funkcije. Kada su ishodi dva, dovoljan je if_else(). Kada ih je više, koristi se case_when(), koji uvjete provjerava redom i prvi istiniti određuje rezultat.
anketa_mreze |>
  mutate(
    intenzitet = case_when(
      minute_dnevno < 30 ~ "rijetko",
      minute_dnevno < 90 ~ "umjereno",
      .default = "često"
    ),
    visoko_povjerenje = if_else(povjerenje >= 7, "da", "ne")
  ) |>
  count(intenzitet, visoko_povjerenje)
# A tibble: 6 × 3
intenzitet visoko_povjerenje n
<chr> <chr> <int>
1 rijetko da 20
2 rijetko ne 96
3 umjereno da 52
4 umjereno ne 96
5 često da 15
6 često ne 21Redoslijed uvjeta u case_when() je bitan. Drugi uvjet hvata samo one koji nisu uhvaćeni prvim, pa se granice ne moraju pisati dvostruko. Grana .default pokriva sve preostale slučajeve, uključujući nedostajuće vrijednosti, pa je vrijedi napisati čak i kada mislite da je nemoguća.
Glagol arrange() sortira retke, a desc() obrće smjer.
anketa_mreze |>
  arrange(desc(minute_dnevno)) |>
  select(ispitanik, dobna_skupina, minute_dnevno) |>
  head(3)
# A tibble: 3 × 3
ispitanik dobna_skupina minute_dnevno
<chr> <chr> <dbl>
1 I053 18 do 24 248
2 I048 18 do 24 203
3 I019 18 do 24 190Nedostajuće vrijednosti pri sortiranju uvijek završavaju na kraju tablice, bez obzira na smjer. To je namjerno, jer se za njih ne zna kamo pripadaju.
Grupiranje i sažimanje
Za sažimanje po skupinama povezujemo dvije funkcije. Funkcija group_by() dijeli tablicu u skupine, a summarise() za svaku skupinu računa sažetak.
# A tibble: 4 × 5
  dobna_skupina     n prosjek medijan    sd
  <chr>         <int>   <dbl>   <dbl> <dbl>
1 18 do 24         90    81.5    68.5 44.6
2 25 do 34         84    54.4    46   29.0
3 35 do 44         66    32.4    26   20.3
4 45 i više        60    16.2    15    9.47
Funkcija n() unutar summarise() vraća broj opažanja u skupini. Vrijedi je uključiti u svaki sažetak, jer prosjek izračunat na pet ispitanika i prosjek izračunat na petsto izgledaju jednako, a nisu jednako pouzdani. Argument .groups = "drop" uklanja grupiranje nakon sažimanja, čime sprečava da se ono tiho prenese u sljedeći korak.
Grupirati se može po više varijabli odjednom, čime nastaje redak za svaku kombinaciju.
# A tibble: 4 × 4
  dobna_skupina visoko     n prosjek
  <chr>         <chr>  <int>   <dbl>
1 18 do 24      nisko     45    80.9
2 18 do 24      visoko    45    82.2
3 25 do 34      nisko     58    56.9
4 25 do 34      visoko    26    48.8
Kada trebate samo prebrojavanje, count() je kratica za group_by() i summarise(n = n()) zajedno.
Grupiranje se može spojiti i s mutate(), čime se dobiva stupac izračunat unutar skupine, a broj redaka ostaje nepromijenjen. Time se, primjerice, svaka vrijednost može usporediti s prosjekom vlastite skupine umjesto s ukupnim prosjekom.
# A tibble: 4 × 4
  ispitanik dobna_skupina minute_dnevno odstupanje
  <chr>     <chr>                 <dbl>      <dbl>
1 I001      18 do 24                 69     -12.5
2 I002      18 do 24                 53     -28.5
3 I003      18 do 24                 83       1.46
4 I004      18 do 24                 67     -14.5
Funkcija ungroup() uklanja grupiranje. Zaboravljeno grupiranje jedan je od najčešćih uzroka rezultata koji izgledaju neobjašnjivo, jer se svaki sljedeći korak tiho izvodi po skupinama.
Kada istu operaciju treba primijeniti na više stupaca, umjesto ponavljanja služi across().
anketa_mreze |>
  group_by(dobna_skupina) |>
  summarise(
    across(c(minute_dnevno, povjerenje), mean),
    .groups = "drop"
  )
# A tibble: 4 × 3
dobna_skupina minute_dnevno povjerenje
<chr> <dbl> <dbl>
1 18 do 24 81.5 6.38
2 25 do 34 54.4 5.56
3 35 do 44 32.4 4.89
4 45 i više 16.2 4.5 Prvi argument bira stupce, a drugi zadaje funkciju. Za više funkcija odjednom predaje se imenovani popis, a imena novih stupaca nastaju spajanjem imena stupca i imena funkcije.
Preoblikovanje tablica
Ista se tablica može zapisati u širem ili užem obliku, a analize i grafovi najčešće traže uži. Načelo urednih podataka traži da svaka varijabla bude stupac, svako opažanje redak, a svaka vrijednost jedna ćelija.
Funkcija pivot_longer() pretvara više stupaca u dva, jedan s imenom nekadašnjeg stupca i jedan s vrijednošću.
# A tibble: 4 × 3
  dobna_skupina minute povjerenje
  <chr>          <dbl>      <dbl>
1 18 do 24        81.5       6.38
2 25 do 34        54.4       5.56
3 35 do 44        32.4       4.89
4 45 i više       16.2       4.5
sazetak_dug <- sazetak_sirok |>
pivot_longer(
cols = c(minute, povjerenje),
names_to = "mjera",
values_to = "vrijednost"
)
sazetak_dug# A tibble: 8 × 3
dobna_skupina mjera vrijednost
<chr> <chr> <dbl>
1 18 do 24 minute 81.5
2 18 do 24 povjerenje 6.38
3 25 do 34 minute 54.4
4 25 do 34 povjerenje 5.56
5 35 do 44 minute 32.4
6 35 do 44 povjerenje 4.89
7 45 i više minute 16.2
8 45 i više povjerenje 4.5 Argument cols bira stupce koji se preoblikuju, names_to imenuje novi stupac s njihovim imenima, a values_to novi stupac s vrijednostima. Ovaj oblik traže gotovo svi grafovi u kojima se više mjera prikazuje jedna do druge.
Funkcija pivot_wider() radi obrnuto.
sazetak_dug |>
  pivot_wider(names_from = mjera, values_from = vrijednost)
# A tibble: 4 × 3
dobna_skupina minute povjerenje
<chr> <dbl> <dbl>
1 18 do 24 81.5 6.38
2 25 do 34 54.4 5.56
3 35 do 44 32.4 4.89
4 45 i više 16.2 4.5 Široki oblik lakše se čita u ispisu, uski se lakše obrađuje. Uobičajen tijek rada podatke drži uskima tijekom analize i širi ih tek za konačnu tablicu.
Spajanje tablica
Podaci često dolaze u više tablica koje treba povezati. Funkcija left_join() zadržava sve retke lijeve tablice i dodaje im stupce iz desne, ondje gdje se ključ podudara.
opisi <- tibble(
  dobna_skupina = factor(
    c("18 do 24", "25 do 34", "35 do 44", "45 i više"),
    levels = levels(anketa_mreze$dobna_skupina)
  ),
  naraštaj = c("najmlađi", "mlađi", "srednji", "stariji")
)

anketa_mreze |>
  left_join(opisi, by = "dobna_skupina") |>
  select(ispitanik, dobna_skupina, naraštaj) |>
  head(3)
# A tibble: 3 × 3
ispitanik dobna_skupina naraštaj
<chr> <chr> <chr>
1 I001 18 do 24 <NA>
2 I002 18 do 24 <NA>
3 I003 18 do 24 <NA> Argument by imenuje stupac po kojem se tablice povezuju. Postoje i druge vrste spajanja, među kojima inner_join() zadržava samo retke koji postoje u objema tablicama, a full_join() sve retke iz obiju.
Nakon svakog spajanja provjerite broj redaka. Ako se povećao, ključ u desnoj tablici nije jedinstven, pa se svaki lijevi redak umnožio. To je najčešća i najtiša pogreška pri spajanju, jer tablica i dalje izgleda ispravno.
Rad s tekstom
Anketni podaci često sadrže slobodan tekst koji treba očistiti prije analize. Paket stringr nudi funkcije s dosljednim imenima, koje sve počinju s str_.
platforme <- c("Instagram, TikTok", "TikTok", "YouTube, Instagram",
               "Facebook", "TikTok, YouTube, Instagram")

str_detect(platforme, "TikTok")
[1] TRUE TRUE FALSE FALSE TRUEsum(str_detect(platforme, "TikTok"))[1] 3str_count(platforme, ",") + 1[1] 2 1 2 1 3Funkcija str_detect() provjerava sadrži li tekst zadani niz i vraća logički vektor, str_count() broji pojavljivanja. Broj navedenih platformi ovdje se dobiva brojanjem zareza uvećanim za jedan, što je jednostavan i pouzdan postupak za uredno unesene odgovore.
Za čišćenje služe str_to_lower(), koja sve pretvara u mala slova, i str_replace_all(), koja zamjenjuje dijelove teksta.
spol_sirovo <- c("Ženski", "muški", "ŽENSKI", "M", "ž")

spol_malim <- str_to_lower(spol_sirovo)
spol_malim
[1] "ženski" "muški" "ženski" "m" "ž" [1] "ženski" "muški" "ženski" "muški" "ženski"Ujednačavanje velikih i malih slova prvi je korak pri svakom čišćenju kategorijalnog stupca, jer se Ženski i ženski inače broje kao dvije kategorije. Nakon toga preostale se inačice svode na zajedničke oznake funkcijama if_else() ili case_when().
Faktori i redoslijed kategorija
Kategorijalne varijable po zadanom se poredaju abecedno, što gotovo nikada nije redoslijed koji želite. Dobne skupine, razine obrazovanja i ljestvice slaganja imaju vlastiti poredak koji abeceda ne poznaje. Paket forcats nudi funkcije s prefiksom fct_ koje taj poredak namještaju.
[1] "niska" "srednja" "visoka" ocjene_uredene <- fct_relevel(ocjene, "niska", "srednja", "visoka")
levels(ocjene_uredene)[1] "niska" "srednja" "visoka" Funkcija fct_relevel() postavlja razine u zadani redoslijed. Kada kategorije treba poredati prema nekoj brojčanoj veličini, a ne prema unaprijed poznatom poretku, posao obavlja fct_reorder().
anketa_mreze |>
  mutate(skupina_po_minutama = fct_reorder(dobna_skupina, minute_dnevno)) |>
  pull(skupina_po_minutama) |>
  levels()
[1] "45 i više" "35 do 44" "25 do 34" "18 do 24" Ovaj poredak nastaje iz podataka, prema medijanu minuta u svakoj skupini, i najčešće se koristi neposredno prije crtanja, jer graf s poredanim kategorijama gotovo se uvijek čita lakše od grafa s abecednim.
Kada kategorija ima previše, rijetke se mogu spojiti u zajedničku.
Instagram    TikTok     Other
        2         3         3
Funkcija fct_lump_n() zadržava najčešće kategorije i sve ostale spaja u kategoriju Other. Spajanje je odluka o prikazu, a ne o podacima, pa je vrijedi zabilježiti u tekstu uz tablicu ili graf, jer čitatelj inače ne zna što je u toj zajedničkoj kategoriji završilo.
Čišćenje neurednih podataka
Podaci iz stvarnih anketa rijetko dolaze spremni za analizu. Imena stupaca sadrže razmake i zagrade, kategorije su upisane na nekoliko načina, a brojčani stupci sadrže riječi. Ovaj odjeljak prolazi kroz tipične probleme redom kojim se obično pojavljuju.
Za sljedeća četiri retka namjerno smo unijeli nekoliko tipičnih nepravilnosti. To je zasebna ilustracija, bez veze s izvornim zapisima ankete. Primjerice, redak 2 prije čišćenja nosi tekst ne gledam, a poslije broj 0. Redak 4 ima prazan odgovor i ostaje nedostajući. Prosjek triju poznatih vremena zato bi bio \((90+0+45)/3 = 45\) minuta, uz jedan nedostajući odgovor.
Prvo uređujemo imena stupaca. Ime s razmakom ili zagradom mora se u kodu pisati unutar obrnutih navodnika, što je nezgodno, pa se imena obično odmah srede.
[1] "ID ispitanika" "TV (min/dan)" "Grad stanovanja" "Spol" cista <- sirova |>
rename(
id = `ID ispitanika`,
tv_min = `TV (min/dan)`,
grad = `Grad stanovanja`,
spol = `Spol`
)
names(cista)[1] "id" "tv_min" "grad" "spol" Drugi je problem brojčani stupac koji je pri uvozu postao tekstualni, jer sadrži riječ ili praznu vrijednost. Takav stupac treba pretvoriti svjesno, tako da se odluči što znači svaka nebrojčana vrijednost.
cista <- cista |>
  mutate(
    tv_min = case_when(
      tv_min == "ne gledam" ~ "0",
      tv_min == "" ~ NA_character_,
      .default = tv_min
    ),
    tv_min = as.numeric(tv_min)
  )

cista$tv_min
[1] 90 0 45 NAOdluka da „ne gledam” znači nulu, a prazna vrijednost nedostajući podatak sadržajna je, a ne tehnička. Netko tko ne gleda televiziju doista je gledao nula minuta, dok netko tko nije odgovorio možda gleda mnogo. Pretvorba bez te odluke, dakle izravan poziv as.numeric(), obje bi vrijednosti pretvorila u NA i uz put ispisala upozorenje.
Treći je problem ista kategorija napisana na više načina. Ujednačavanje počinje svođenjem na mala slova, a zatim se preostale inačice svode na zajedničku oznaku.
# A tibble: 4 × 4
     id tv_min grad   spol
  <int>  <dbl> <chr>  <chr>
1     1     90 Zagreb ženski
2     2      0 Zagreb muški
3     3     45 Split  muški
4     4     NA Zagreb ženski
Funkcija str_to_title() postavlja prvo slovo svake riječi na veliko, čime se ZAGREB i zagreb svode na isti Zagreb. Grana .default ovdje namjerno vraća NA, jer je bolje da neprepoznata vrijednost postane vidljivo nedostajuća nego da se tiho svrsta u jednu od kategorija.
Provjera nakon čišćenja obavezna je i sastoji se od dva koraka.
count(cista, grad)# A tibble: 2 × 2
grad n
<chr> <int>
1 Split 1
2 Zagreb 3count(cista, spol)# A tibble: 2 × 2
spol n
<chr> <int>
1 muški 2
2 ženski 2Ako se u ispisu pojavi kategorija koju niste očekivali ili NA ondje gdje ne biste smjeli imati nedostajuću vrijednost, čišćenje nije gotovo. Ovaj kratki ispis otkriva više problema od svakog drugog pojedinačnog postupka.
Cijelo čišćenje na kraju pripada jednom cjevovodu, koji od sirove tablice do uporabljive vodi bez međuobjekata i može se pročitati kao popis odluka.
cista_odjednom <- sirova |>
  rename(
    id = `ID ispitanika`,
    tv_min = `TV (min/dan)`,
    grad = `Grad stanovanja`,
    spol = `Spol`
  ) |>
  mutate(
    tv_min = case_when(
      tv_min == "ne gledam" ~ "0",
      tv_min == "" ~ NA_character_,
      .default = tv_min
    ),
    tv_min = as.numeric(tv_min),
    grad = str_to_title(str_to_lower(grad)),
    spol = str_to_lower(spol),
    spol = case_when(
      spol %in% c("ženski", "ž", "z") ~ "ženski",
      spol %in% c("muški", "m") ~ "muški",
      .default = NA_character_
    )
  )

identical(cista, cista_odjednom)
[1] TRUEFunkcija identical() potvrđuje da postupak po koracima i postupak u jednom cjevovodu daju isti rezultat. Takva provjera vrijedi kad god analizu preoblikujete, jer je najlakše pogriješiti upravo pri sređivanju koda koji je dotad radio.
Ovaj cjevovod nikada ne prepisuje sirova. Izvorna tablica ostaje netaknuta, pa se svaki korak može ponoviti i preispitati. Čišćenje koje prepisuje izvor briše dokaz o tome što je zapravo bilo u podacima.
Grafovi
Poglavlje o vizualizaciji razrađuje odluke kojima oblikujemo graf prema istraživačkom pitanju. Ovaj odjeljak uči kako se te odluke zapisuju u paketu ggplot2. Redoslijed izlaganja slijedi redoslijed odluka, pa se najprije gradi kostur, a zatim se dodaju geometrija, polja, ljestvice i oznake.
Svaki graf ima tri obavezna dijela. Funkcija ggplot() prima tablicu, aes() pridružuje varijable svojstvima grafa, a sloj geom_ određuje oblik prikaza. Slojevi se spajaju znakom +, a ne cjevovodom, i to je razlika koju vrijedi zapamtiti odmah, jer je zamjena tih dvaju znakova najčešća pogreška početnika.
ggplot(anketa_mreze, aes(x = minute_dnevno))
Poziv bez geometrije nacrta samo osi. Time pokazuje dosad zadane dijelove grafa, podatke i pridruživanje varijabli. Oblik oznaka dodat ćemo odabirom geometrije.
Geometrija prema vrsti podataka
Sljedeća četiri izbora pokrivaju gotovo sve što opisna analiza treba. Redoslijed prati tablicu iz poglavlja o vizualizaciji, dakle jednu brojčanu varijablu, jednu kategorijalnu, brojčanu po skupinama i dvije brojčane.
Jedna brojčana varijabla
Histogram dijeli raspon varijable na jednako široke razrede i broji opažanja u svakom.
ggplot(anketa_mreze, aes(x = minute_dnevno)) +
  geom_histogram(bins = 30) +
  labs(x = "Minute dnevno", y = "Broj ispitanika")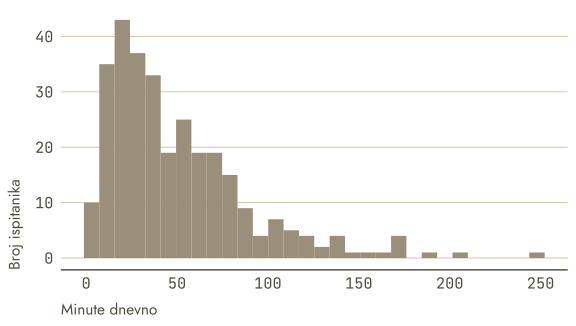
Argument bins zadaje broj razreda, a binwidth njihovu širinu, i navodi se jedan ili drugi. Zadanih trideset razreda gotovo nikada nije pravi izbor, pa vrijedi isprobati nekoliko vrijednosti i vidjeti mijenja li se oblik. Ako se mijenja jako, oblik nije svojstvo podataka nego izbora razreda.
Krivulja gustoće daje zaglađen prikaz raspodjele. Ne ovisi o granicama razreda, ali njezin oblik ovisi o odabranoj širini pojasa zaglađivanja.
ggplot(anketa_mreze, aes(x = minute_dnevno)) +
  geom_density(fill = "grey70", alpha = 0.4) +
  labs(x = "Minute dnevno", y = "Gustoća")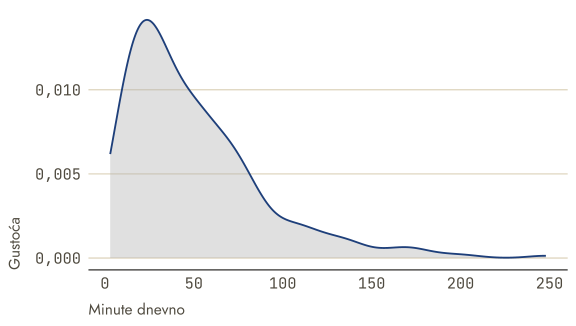
Argument alpha zadaje prozirnost, gdje nula znači posve prozirno, a jedinica posve neprozirno. Prozirnost je nužna kada se prikazi preklapaju, jer bez nje gornji sloj skriva donji.
Jedna kategorijalna varijabla
Za kategorije postoje dva sloja i razlika među njima je u tome tko broji. Funkcija geom_bar() prebrojava retke sama, dok geom_col() crta vrijednosti koje ste već izračunali.
ggplot(anketa_mreze, aes(x = dobna_skupina)) +
  geom_bar() +
  labs(x = NULL, y = "Broj ispitanika")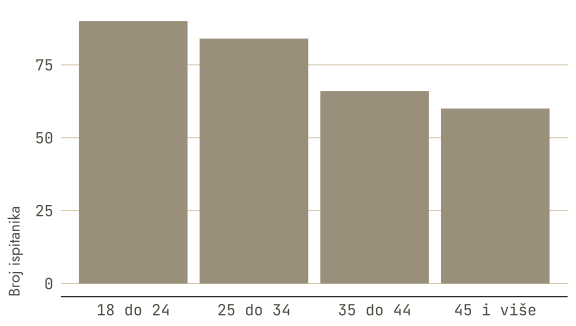
anketa_mreze |>
  group_by(dobna_skupina) |>
  summarise(prosjek = mean(minute_dnevno), .groups = "drop") |>
  mutate(dobna_skupina = fct_reorder(dobna_skupina, prosjek)) |>
  ggplot(aes(x = prosjek, y = dobna_skupina)) +
  geom_col() +
  labs(x = "Prosječne minute dnevno", y = NULL)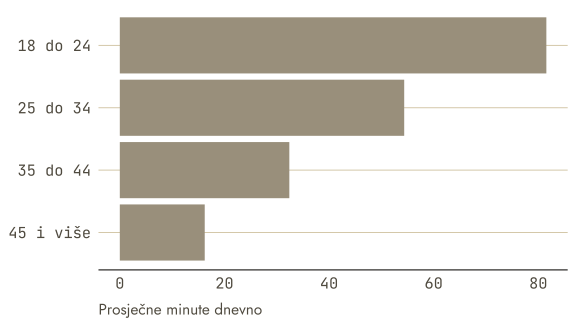
Drugi primjer pokazuje tri navike odjednom. Cjevovod vodi do ggplot(), gdje se prelazi na znak +. Funkcija fct_reorder() iz odjeljka o faktorima poreda kategorije po brojčanoj veličini umjesto po abecedi. I kategorijalna varijabla stavljena je na okomitu os, čime se dobiva vodoravni prikaz, koji duga imena kategorija podnosi bez zakretanja teksta.
Kada prikazujemo dvije kategorijalne varijable, drugu pridružujemo ispuni.
anketa_mreze |>
  mutate(razina = if_else(povjerenje >= 7, "visoko", "nisko")) |>
  ggplot(aes(x = dobna_skupina, fill = razina)) +
  geom_bar(position = "dodge") +
  labs(x = NULL, y = "Broj ispitanika", fill = NULL)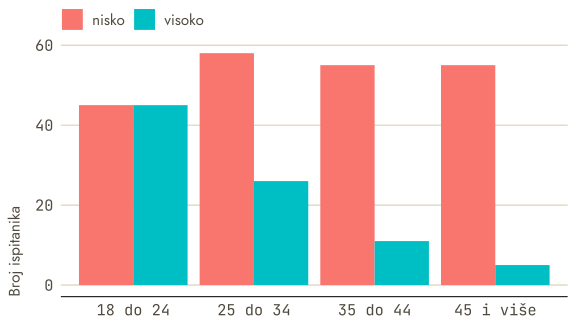
Argument position određuje raspored stupaca. Vrijednost "dodge" stavlja ih jedan uz drugi i čuva apsolutne brojeve, "stack" ih slaže jedan na drugi, a "fill" svaki stupac rastegne na punu visinu i time prikazuje udjele umjesto brojeva. Izbor među njima je izbor pitanja, jer prvi prikazuje koliko ih ima, a treći kako su raspoređeni.
Brojčana varijabla po skupinama
Kutijasti dijagram prije crtanja izračunava medijan i kvartile.
ggplot(anketa_mreze, aes(x = dobna_skupina, y = minute_dnevno)) +
  geom_boxplot() +
  labs(x = NULL, y = "Minute dnevno")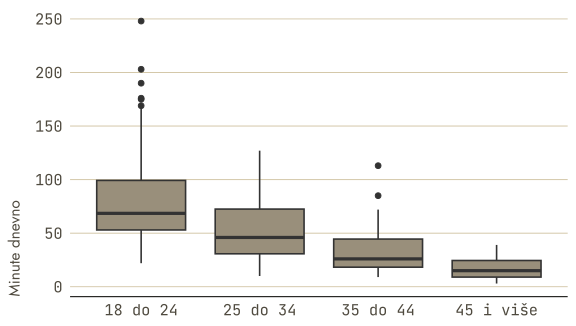
Izbor između tog prikaza i histograma mijenja informacije koje čitatelj može vidjeti. Histogram prebrojava opažanja u razredima i tako pokazuje oblik raspodjele uz odabranu širinu razreda. Kutijasti dijagram oblik unutar kutije više ne pokazuje, ali skupine uspoređuje bez napora. Svaki prikaz nešto čuva i nešto odbacuje, što je argument koji poglavlje o vizualizaciji razrađuje.
Ono što je kutija odbacila može se vratiti dodavanjem sloja s opažanjima.
ggplot(anketa_mreze, aes(x = dobna_skupina, y = minute_dnevno)) +
  geom_jitter(width = 0.15, alpha = 0.25) +
  geom_boxplot(fill = NA, outlier.shape = NA) +
  labs(x = NULL, y = "Minute dnevno")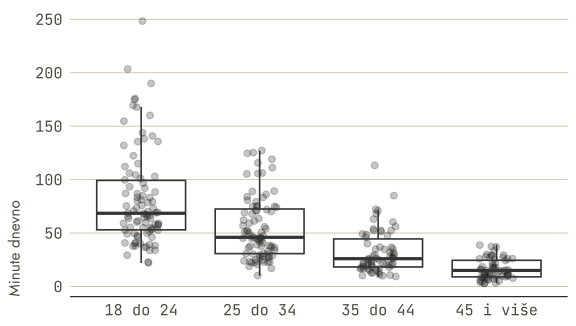
Funkcija geom_jitter() točkama dodaje mali slučajni pomak, jer bi inače sva opažanja iste skupine pala na isti okomiti pravac. Argument width zadaje koliko se smije pomaknuti, a vrijednost veća od polovine razmaka među kategorijama počinje miješati skupine. Argument outlier.shape = NA uklanja točke koje kutija sama crta, jer bi se inače udvostručile. Redoslijed slojeva je bitan, jer se svaki sljedeći crta preko prethodnog.
Violinski prikaz radi obrnuto od kutije i pokazuje oblik umjesto kvartila.
ggplot(anketa_mreze, aes(x = dobna_skupina, y = minute_dnevno)) +
  geom_violin() +
  labs(x = NULL, y = "Minute dnevno")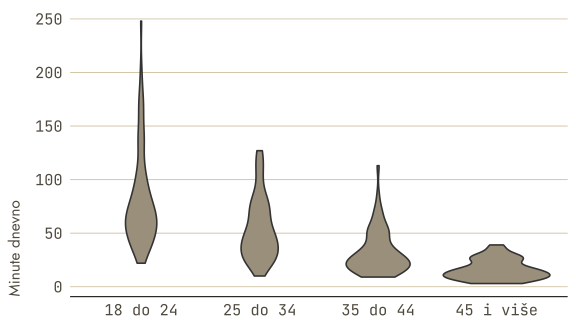
Dvije brojčane varijable
Raspršeni dijagram prikazuje parove vrijednosti bez prethodnog sažimanja.
ggplot(anketa_mreze, aes(x = dob, y = minute_dnevno)) +
  geom_point(alpha = 0.3) +
  labs(x = "Dob", y = "Minute dnevno")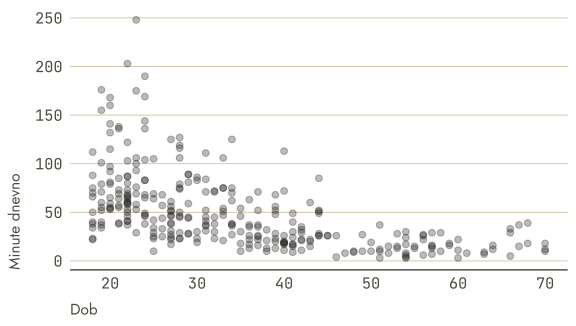
Prozirnost ovdje pomaže očitati gustoću oblaka. Preklopljene točke stvaraju tamnija područja koja razlikujemo od pojedinačnih opažanja.
Sloj geom_smooth() provlači kroz oblak procijenjeni prosječni odnos.
ggplot(anketa_mreze, aes(x = dob, y = minute_dnevno)) +
  geom_point(alpha = 0.3) +
  geom_smooth(method = "lm") +
  labs(x = "Dob", y = "Minute dnevno")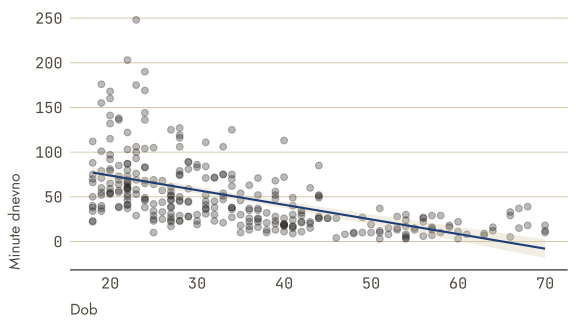
Argument method = "lm" traži pravac najmanjih kvadrata, a bez njega se crta prilagodljiva krivulja koja slijedi oblik podataka. Siva vrpca oko linije je interval pouzdanosti, i uklanja se argumentom se = FALSE. Ta linija nastaje prilagodbom modela, pa je čitamo zajedno s oblakom opažanja iz kojega je izračunata. Poglavlje o regresiji pokazuje kako nastaje.
Pridruživanje, polja i oznake
Pridruživanje unutar i izvan aes()
Pridruživanje varijable treba razlikovati od zadavanja jednake vrijednosti za sve oznake. Unutar aes() ide ime varijable, izvan aes() ide zadana vrijednost.
ggplot(anketa_mreze, aes(x = dob, y = minute_dnevno)) +
  geom_point(colour = "grey40", alpha = 0.4) +
  labs(x = "Dob", y = "Minute dnevno")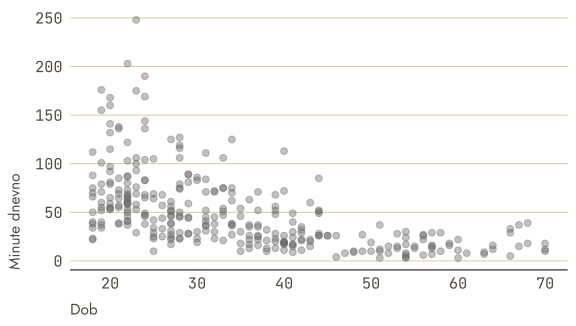
anketa_mreze |>
  mutate(razina = if_else(povjerenje >= 7, "visoko", "nisko")) |>
  ggplot(aes(x = dob, y = minute_dnevno)) +
  geom_point(aes(shape = razina), alpha = 0.5) +
  labs(x = "Dob", y = "Minute dnevno", shape = NULL)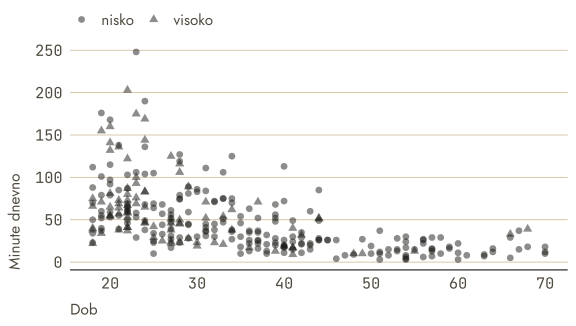
U prvom pozivu boja je zadana vrijednost i vrijedi za sve oznake, pa legende nema. U drugom je oblik pridružen varijabli, pa ggplot2 legendu izradi sam. Kada se ime boje zabunom stavi unutar aes(), paket ga protumači kao jednočlanu kategorijalnu varijablu, sve oznake oboji jednako i doda beskorisnu legendu s jednim unosom. Graf pritom ne javlja nikakvu grešku.
Polja
Funkcija facet_wrap() ponavlja isti graf za svaku razinu varijable. Tilda ispred imena čita se kao „po”.
ggplot(anketa_mreze, aes(x = minute_dnevno)) +
  geom_histogram(bins = 24) +
  facet_wrap(~ dobna_skupina, nrow = 1) +
  labs(x = "Minute dnevno", y = "Broj ispitanika")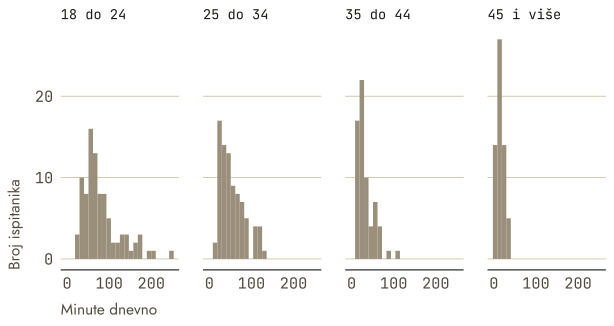
Argument nrow ili ncol određuje raspored polja. Po zadanom sva polja dijele istu os, što je i svrha postupka, jer se položaji smiju uspoređivati između polja. Argument scales = "free_y" to napušta i svakom polju daje vlastiti raspon, čime usporedba razina prestaje biti moguća. Vrijedi ga upotrijebiti samo kada se uspoređuje oblik, i tada to reći u tekstu uz graf.
Za dvije kategorijalne varijable odjednom služi facet_grid(), koja polja slaže u matricu, s varijablom za retke lijevo i varijablom za stupce desno od tilde.
Oznake
Funkcija labs() imenuje sve što se na grafu vidi.
ggplot(anketa_mreze, aes(x = dob, y = minute_dnevno)) +
  geom_point(alpha = 0.3) +
  geom_smooth(method = "lm", se = FALSE) +
  labs(
    title = "Vrijeme korištenja opada s dobi",
    subtitle = "Simulirana anketa, 300 ispitanika",
    x = "Dob",
    y = "Minute dnevno",
    caption = "Izrada autora. Podaci su simulirani i nisu mjerenje."
  )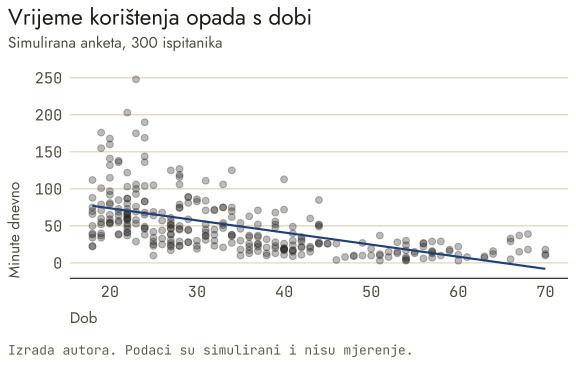
Naslov koji izriče nalaz čitatelju kaže više od naslova koji opisuje sadržaj, pa je „Vrijeme korištenja opada s dobi” korisnije od „Odnos dobi i vremena korištenja”. Potpis nosi izvor podataka i napomenu o postupku, i u ovoj knjizi nikada ne izostaje.
Izgled, ljestvice i spremanje
Teme i ljestvice
Tema određuje sve što nije podatak, dakle pozadinu, mrežu, pisma i položaj legende. Ugrađene teme uključuju theme_minimal(), theme_bw(), theme_classic() i theme_void(), a postavljaju se po grafu ili jednom za cijelu sesiju pozivom theme_set().
ggplot(anketa_mreze, aes(x = dobna_skupina)) +
  geom_bar() +
  labs(x = NULL, y = "Broj ispitanika") +
  theme_minimal() +
  theme(
    panel.grid.minor = element_blank(),
    legend.position = "none"
  )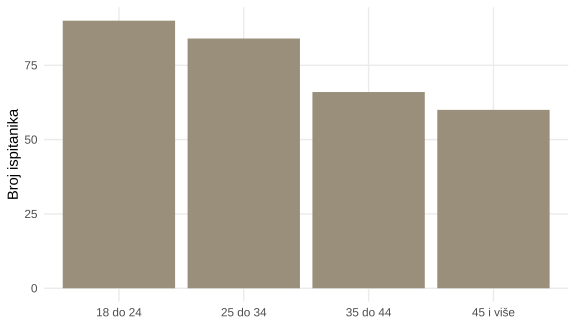
Funkcija theme() mijenja pojedinačne elemente, pri čemu element_blank() element uklanja, a element_text() mu mijenja pismo i veličinu. Poziv theme() dolazi nakon gotove teme, jer bi ga inače gotova tema pregazila.
Boje kategorija zadaju se ljestvicama. Ručni izbor traži scale_fill_manual() uz popis vrijednosti, a gotove skupove nude scale_fill_brewer() i scale_fill_viridis_d(). Skup viridis vrijedi poznavati jer je izrađen tako da jednakim koracima u podacima odgovaraju jednaki koraci u boji, ostaje razlučiv u sivim tonovima i čitljiv osobama koje boje razlikuju drukčije. Nastavak _d označava kategorijalnu varijablu, a _c neprekinutu.
Ova knjiga vlastite boje ne bira u poglavljima nego ih uzima iz svoje palete, pa se u njezinim izvorima ne pojavljuje nijedan zapis boje. Razlog je u tome što paleta mora ostati razlučiva i u crno-bijelom tisku, što se postiže poretkom po svjetlini, a ne po tonu.
Oznake na osima uređuju se funkcijama scale_x_continuous() i scale_y_continuous(), gdje breaks zadaje položaje oznaka, a labels njihov zapis.
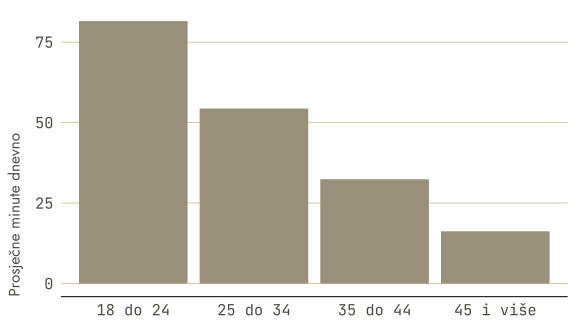
Raspon osi možemo ograničiti na dva načina, s različitim posljedicama za izračun. Argument limits unutar ljestvice odbacuje opažanja izvan raspona prije crtanja, pa se s njima gubi i sve što se iz njih računa, uključujući pravce i prosjeke. Funkcija coord_cartesian() mijenja samo prikazani izrez i sva opažanja zadržava u izračunu.
ggplot(anketa_mreze, aes(x = dob, y = minute_dnevno)) +
  geom_point(alpha = 0.3) +
  geom_smooth(method = "lm", se = FALSE) +
  coord_cartesian(ylim = c(0, 150)) +
  labs(x = "Dob", y = "Minute dnevno")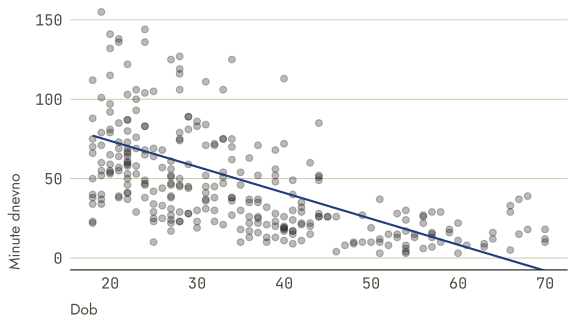
Kada isti raspon zadate preko limits, pravac se promijeni, jer je izračunat bez odbačenih opažanja. To je tiha pogreška koja graf ne ruši, pa za sužavanje pogleda uvijek koristite coord_cartesian().
Spremanje
Gotov se graf sprema funkcijom ggsave().
ggsave("outputs/dob-minute.png", width = 6, height = 3.6, dpi = 300)Bez imenovanog grafa sprema se posljednji nacrtani. Dimenzije se zadaju u inčima, a dpi određuje razlučivost, pri čemu je 300 uobičajeno za tisak, a 150 dovoljno za prezentaciju. Nastavak u imenu datoteke određuje format, gdje .png daje rastersku sliku prikladnu za zaslon, a .pdf i .svg vektorsku, koja se može povećati bez gubitka oštrine.
Četiri česte pogreške
Prva je znak |> umjesto + između slojeva. Cjevovod vodi do ggplot(), a unutar grafa slojevi se zbrajaju.
Druga je brojčana varijabla pridružena ispuni stupčastog prikaza, čime nastaje neprekinuta ljestvica boja ondje gdje su potrebne kategorije. Popravak je pretvoriti varijablu u faktor.
Treća je previše skupina u jednom prikazu. Preko tri ili četiri boje legenda prestaje pomagati, pa je bolje prijeći na polja.
Četvrta je nedostajuća vrijednost koja tiho postane vlastita kategorija ili vlastito polje. Prikaz izgleda ispravno, a sadrži skupinu koja ne postoji. Provjera funkcijom count() prije crtanja to otkriva odmah.
Pisanje funkcija
Kada se isti postupak ponavlja nad različitim varijablama, vrijedi mu dati ime. Funkcija se sastoji od imena, popisa argumenata i tijela, a vraća vrijednost posljednjeg izraza.
# A tibble: 1 × 4
      n sredina medijan    sd
  <int>   <dbl>   <dbl> <dbl>
1 300 50.1 39 39.2opis(anketa_mreze$povjerenje)# A tibble: 1 × 4
n sredina medijan sd
<int> <dbl> <dbl> <dbl>
1 300 5.45 5 1.79Argumenti mogu imati zadane vrijednosti, koje se koriste kada ih pozivatelj ne navede.
# A tibble: 1 × 4
      n sredina medijan    sd
  <int>   <dbl>   <dbl> <dbl>
1 300 50.1 39 39.2opis_zaokruzeno(anketa_mreze$minute_dnevno, decimala = 3)# A tibble: 1 × 4
n sredina medijan sd
<int> <dbl> <dbl> <dbl>
1 300 50.1 39 39.2Zapis \(v) skraćeni je oblik za function(v) i koristan je za kratke funkcije koje se predaju drugim funkcijama.
U funkciju je korisno ugraditi provjeru ulaza, kako bi pogreška bila prijavljena na mjestu gdje je nastala, a ne nekoliko koraka poslije.
udio_iznad <- function(x, granica) {
  if (!is.numeric(x)) {
    stop("Varijabla mora biti brojčana.")
  }
  100 * mean(x > granica, na.rm = TRUE)
}

udio_iznad(anketa_mreze$minute_dnevno, 120)
[1] 6,333333Funkcija stop() prekida izvršavanje i ispisuje poruku. Poruka treba reći što je pošlo po zlu i što se očekivalo, jer ćete je čitati vi sami za nekoliko mjeseci.
Skripta, Quarto i ponovljivost
Analiza se piše u datoteci, a ne u konzoli. Uredna skripta ima zaglavlje s opisom, zatim učitavanje paketa, zatim učitavanje podataka, pa pregled, obradu i tek onda rezultate.
# ============================================
# Analiza korištenja društvenih mreža
# Autor: Ime Prezime
# Datum: 2026-07-30
# ============================================

# 1. Paketi ----
library(tidyverse)

# 2. Podaci ----
anketa <- read_csv("data/anketa-mreze.csv", show_col_types = FALSE)

# 3. Pregled ----
glimpse(anketa)
colSums(is.na(anketa))

# 4. Obrada ----
anketa_cista <- anketa |>
  filter(!is.na(minute_dnevno)) |>
  mutate(sati_dnevno = minute_dnevno / 60)

# 5. Rezultati ----
sazetak <- anketa_cista |>
  group_by(dobna_skupina) |>
  summarise(n = n(), prosjek = mean(minute_dnevno), .groups = "drop")

# 6. Izvoz ----
write_csv(sazetak, "outputs/sazetak.csv")
Komentar koji završava s četiri crtice R-ova okruženja prepoznaju kao naslov odjeljka i prikazuju ga u navigaciji, što u dugoj skripti znatno olakšava snalaženje.
Čišćenje nikada ne prepisuje izvornu datoteku. Stvara novi objekt ili novu datoteku, a svaka promjena ostaje zapisana u skripti. Ručna izmjena ćelije u tablici prekida ponovljivost, jer nakon nje nitko, uključujući vas, ne može rekonstruirati put od sirovih podataka do rezultata.
Kada uz kod treba i tekst, umjesto skripte koristi se Quarto dokument, isti alat kojim je izrađena ova knjiga. Takav dokument ima tri dijela, i to zaglavlje u kojem se zadaju naslov i format, tekst pisan u Markdownu i blokove koda čiji se rezultati ugrađuju u dokument pri izradi. Ponašanje svakog bloka podešava se opcijama, među kojima echo odlučuje hoće li se kod vidjeti, eval hoće li se izvršiti, a warning i message hoće li se poruke prikazati. Izvještaj za naručitelja tako može sakriti kod, a isti izvor za kolegicu analitičarku može ga pokazati.
Quarto uz to omogućuje da broj u rečenici dođe izravno iz izračuna, umjesto da se prepisuje rukom. Takav se umetnuti kod piše unutar obrnutih navodnika s oznakom jezika, u obliku prikazanom niže.
U uzorku je 300 ispitanika, a prosječno dnevno
vrijeme iznosi 50,1 minuta.
Pri izradi dokumenta na mjestu svakog takvog izraza pojavljuje se njegov rezultat, dakle brojevi koje daju sljedeći pozivi.
Broj prepisan rukom može se razići s podacima čim se podaci promijene, a rečenica i dalje izgleda uredno. Broj koji se ponovno izračuna iz istoga objekta smanjuje rizik takve prijepisne pogreške, ali ne jamči da su izvor, objekt ili postupak ispravni. Poglavlja ove knjige zato vežu brojke u prozi uz izračun i zasebno provjeravaju njihov podatkovni trag.
Prije predaje analizu pokrenite iz čiste sesije, dakle nakon što ste obrisali sve objekte i ponovno pokrenuli R. Rezultati moraju nastati iz skripte, a ne iz objekata koji su slučajno ostali u memoriji. Ako analiza uključuje slučajne brojeve, sjeme generatora postavite funkcijom set.seed() na početku, jer bez toga isti kod pri svakom pokretanju daje malo drukčije brojeve.
[1] 53,8[1] 53,8Ista vrijednost pri oba pokretanja pokazuje da je izvlačenje ponovljivo. Uz sjeme, u reprodukcijski zapis pripadaju i verzije paketa te izvor podataka.
Greške i dijagnostika
Greške su uobičajen dio rada s kodom. Poruka o grešci obično upućuje na njezin uzrok, pa najprije pročitajte što javlja.
Poruka object 'x' not found znači da objekt s tim imenom ne postoji. Uzrok je najčešće tipfeler u imenu, nepokrenut raniji redak ili pokretanje koda izvan redoslijeda. Poruka unexpected symbol označava sintaktičku pogrešku, obično zaboravljeni zarez, operator ili zatvorenu zagradu. Poruka does not exist in current working directory znači da R ne nalazi datoteku, pa provjerite ime, veliko i malo slovo te putanju, a getwd() će vam reći gdje R uopće traži. Poruka could not find function znači da paket nije učitan, pa provjerite je li library() na vrhu skripte pokrenut.
Upozorenja se razlikuju od grešaka. Greška zaustavlja izvršavanje, a upozorenje ga ne zaustavlja nego javlja da se dogodilo nešto neobično.
R je prva dva teksta pretvorio u brojeve, treći nije mogao i na njegovo je mjesto stavio NA. Kod se izvršio do kraja, a rezultat je tiho izgubio jednu vrijednost. Upozorenja zato treba čitati jednako pažljivo kao greške, jer najčešće govore o problemu s podacima, a ne s kodom.
Pogrešku u dugačkom cjevovodu tražite postupno. Pokrenite ga korak po korak i nakon svakog koraka pogledajte rezultat.
[1] 139anketa_mreze |>
filter(dob < 30) |>
group_by(dobna_skupina) |>
summarise(n = n(), .groups = "drop")# A tibble: 2 × 2
dobna_skupina n
<chr> <int>
1 18 do 24 90
2 25 do 34 49Prvi korak potvrđuje da filtriranje uopće nešto zadržava, drugi da grupiranje daje očekivane skupine. Postupno građenje cjevovoda uz provjeru nakon svakog koraka najbrži je način da se pronađe mjesto na kojem se nešto raspalo.
Za pomoć oko pojedine funkcije služi upitnik ispred njezina imena. Stranica pomoći opisuje argumente i završava primjerima, koji su gotovo uvijek korisniji od opisa.
?mean
vignette("dplyr")
Ako objašnjenje nije dovoljno, potražite istu poruku ili primjer na internetu. Pretrazi dodajte riječ tidyverse ili ime paketa, jer ćete inače dobiti odgovore u drukčijoj sintaksi od one koju ovdje koristimo.
Neobvezna dopuna o složenim uzorcima
Ova dopuna proširuje odjeljak o nacrtu uzorka iz poglavlja o uzorkovanju. Za obvezne računske zadatke u tom poglavlju dovoljni su ondje prikazani jednostavni uzorci i mala tablica poznatih težina.
Težine se mogu prilagoditi neodazivu i zatim kalibrirati. Kalibracijom usklađujemo ponderirane zbrojeve pomoćnih obilježja, primjerice dobnih skupina, s poznatim populacijskim zbrojevima. To može pomoći ako ta obilježja objašnjavaju relevantne razlike. Ne uklanja neizmjerene razlike između odazvanih i neodazvanih, nepotpun okvir ili loše pitanje.
Pri grupnom uzorkovanju najprije biramo kućanstva, škole ili naselja, a zatim jedinice unutar njih. Time smanjujemo trošak terenskog rada. Ako su osobe iste skupine sličnije, stotinu ljudi iz nekoliko skupina donosi manje neovisne informacije nego stotinu raspršenih po populaciji. Jednostavna formula s korijenom iz \(n\) tada podcjenjuje nesigurnost.
Učinak nacrta omjer je varijance procjene prema stvarnom nacrtu i varijance za jednostavni slučajni uzorak iste veličine. Efektivna veličina uzorka izražava tu preciznost kao veličinu odgovarajućeg jednostavnog slučajnog uzorka. Grupiranje i vrlo različite težine mogu je smanjiti, a dobro raslojavanje povećati. Učinak se odnosi na određenu procjenu i može biti različit za više pokazatelja iste ankete.
Za složeni nacrt račun procjene i nesigurnosti mora uključiti težine, skupine i slojeve. Pri čitanju izvještaja tražimo opis tog računa. Jednostavne formule iz ovog poglavlja ne prenosimo automatski na takav uzorak.
Postupci iz poglavlja
Ovaj odjeljak okuplja postupke na koje poglavlja upućuju kada zadatak traži izračun nad cijelim skupom podataka. Svaki je zaokružen i može se pokrenuti samostalno.
Kategorijalna usporedba iz poglavlja 1
Poglavlje o statističkom mišljenju traži da zbirnu tvrdnju rastavimo po smislenim skupinama. Obvezna kategorijalna vježba zato radi na sintetičkoj populaciji medijskih navika učitanoj u odjeljku o učitavanju. Najprije broji izvore vijesti unutar obrazovnih skupina, a zatim računa udjele unutar svake skupine.
izvori_po_obrazovanju <- populacija_medija |>
  count(obrazovanje, izvor_vijesti, name = "broj") |>
  group_by(obrazovanje) |>
  mutate(udio = broj / sum(broj)) |>
  ungroup()

izvori_po_obrazovanju
# A tibble: 20 × 4
obrazovanje izvor_vijesti broj udio
<chr> <chr> <int> <dbl>
1 diplomska TV 1265 0.224
2 diplomska društvene mreže 1492 0.265
3 diplomska portal 1639 0.291
4 diplomska radio 684 0.121
5 diplomska tisak 557 0.0988
6 osnovna TV 1957 0.219
7 osnovna društvene mreže 2396 0.268
8 osnovna portal 2666 0.299
9 osnovna radio 1022 0.114
10 osnovna tisak 890 0.0997
11 srednja TV 5002 0.212
12 srednja društvene mreže 6293 0.267
13 srednja portal 7267 0.308
14 srednja radio 2747 0.116
15 srednja tisak 2286 0.0969
16 viša TV 2603 0.220
17 viša društvene mreže 3197 0.270
18 viša portal 3529 0.298
19 viša radio 1386 0.117
20 viša tisak 1122 0.0948Zbirni udio svakog izvora i udjeli po skupinama odgovaraju na pitanja različitog obuhvata. Sljedeća usporedba stavlja ih jedan uz drugi, pa se može provjeriti mijenja li se opis kada se sačuva obrazovna skupina.
zbirni_izvori <- populacija_medija |>
  count(izvor_vijesti, name = "broj") |>
  mutate(udio_zbirno = broj / sum(broj)) |>
  select(izvor_vijesti, udio_zbirno)

izvori_po_obrazovanju |>
  left_join(zbirni_izvori, by = "izvor_vijesti") |>
  mutate(razlika = udio - udio_zbirno)
# A tibble: 20 × 6
obrazovanje izvor_vijesti broj udio udio_zbirno razlika
<chr> <chr> <int> <dbl> <dbl> <dbl>
1 diplomska TV 1265 0.224 0.217 0.00787
2 diplomska društvene mreže 1492 0.265 0.268 -0.00288
3 diplomska portal 1639 0.291 0.302 -0.0113
4 diplomska radio 684 0.121 0.117 0.00456
5 diplomska tisak 557 0.0988 0.0971 0.00171
6 osnovna TV 1957 0.219 0.217 0.00258
7 osnovna društvene mreže 2396 0.268 0.268 0.000719
8 osnovna portal 2666 0.299 0.302 -0.00351
9 osnovna radio 1022 0.114 0.117 -0.00235
10 osnovna tisak 890 0.0997 0.0971 0.00255
11 srednja TV 5002 0.212 0.217 -0.00455
12 srednja društvene mreže 6293 0.267 0.268 -0.000851
13 srednja portal 7267 0.308 0.302 0.00597
14 srednja radio 2747 0.116 0.117 -0.000357
15 srednja tisak 2286 0.0969 0.0971 -0.000215
16 viša TV 2603 0.220 0.217 0.00336
17 viša društvene mreže 3197 0.270 0.268 0.00253
18 viša portal 3529 0.298 0.302 -0.00389
19 viša radio 1386 0.117 0.117 0.000310
20 viša tisak 1122 0.0948 0.0971 -0.00231 Ovaj skup smijemo priložiti knjizi i koristiti umjesto vanjskog primjera. Analizu možemo ponoviti iz priloženih datoteka, a rezultat ne podupire tvrdnje o stvarnoj populaciji.
Provjera instrumenta iz poglavlja 2
Poglavlje o mjerenju okreće ljestvicu niječno formulirane tvrdnje i provjerava slaže li se svaka tvrdnja s ostatkom instrumenta. Postupak se lako primjenjuje na bilo koji upitnik. Ovdje koristimo samo prvih šest ručno sastavljenih odgovora iz poglavlja o mjerenju i dizajnu, pa koeficijenti nisu isti kao u njegovu računu svih 12 osoba. Svaki redak predstavlja jednoga zamišljenog ispitanika.
odgovori <- tribble(
  ~ispitanik, ~t1, ~t2, ~t3, ~t4,
  "I01", 4, 5, 4, 2,
  "I02", 5, 4, 5, 1,
  "I03", 3, 3, 3, 3,
  "I04", 2, 1, 2, 5,
  "I05", 1, 2, 1, 4,
  "I06", 3, 4, 3, 3
)

stavke <- c("t1", "t2", "t3", "t4")

# Korelacija svake tvrdnje sa zbrojem preostalih
stavka_ukupno <- function(podaci, stavke) {
  sapply(stavke, function(s) {
    ostatak <- rowSums(podaci[setdiff(stavke, s)])
    cor(podaci[[s]], ostatak)
  })
}

round(stavka_ukupno(odgovori, stavke), 2)
t1 t2 t3 t4
0,86 0,57 0,86 -0,94 Iz sadržaja četvrte tvrdnje znamo da je niječna. Negativna korelacija sama ne bi opravdala okretanje odgovora. Ljestvica se okreće tako da se odgovor oduzme od najveće moguće vrijednosti uvećane za jedan, dakle od šest za ljestvicu od 1 do 5.
okrenuto <- odgovori |>
  mutate(t4 = 6 - t4)

round(stavka_ukupno(okrenuto, stavke), 2)
t1 t2 t3 t4
0,94 0,82 0,94 0,94 okrenuto |>
mutate(povjerenje = rowMeans(pick(all_of(stavke)))) |>
select(ispitanik, povjerenje)# A tibble: 6 × 2
ispitanik povjerenje
<chr> <dbl>
1 I01 4.25
2 I02 4.75
3 I03 3
4 I04 1.5
5 I05 1.5
6 I06 3.25Nakon okretanja sve četiri tvrdnje idu u istu stranu i zbrajanje ima smisla.
Mjere središta i raspršenosti iz poglavlja 4
Poglavlje o sažimanju podataka traži usporedbu mjera središta i raspršenosti te njihovu osjetljivost na ekstremnu vrijednost. Sve se dobiva jednim sažetkom.
# A tibble: 1 × 7
      n sredina medijan skracena10    sd   iqr raspon
  <dbl>   <dbl>   <dbl>      <dbl> <dbl> <dbl>  <dbl>
1   300    50.1      39       44.1  39.2  46.2    245
Osjetljivost se pokazuje tako da se najveća vrijednost zamijeni znatno većom, a zatim se isti sažetak ponovi. Medijan i međukvartilni raspon jedva se pomaknu, dok sredina i standardna devijacija reagiraju snažno.
minute_izmijenjeno <- minute
minute_izmijenjeno[which.max(minute)] <- 10 * max(minute)

tibble(
  verzija = c("izvorno", "s ekstremom"),
  sredina = c(mean(minute), mean(minute_izmijenjeno)),
  medijan = c(median(minute), median(minute_izmijenjeno)),
  sd = c(sd(minute), sd(minute_izmijenjeno)),
  iqr = c(IQR(minute), IQR(minute_izmijenjeno))
) |>
  mutate(across(where(is.numeric), \(v) round(v, 1)))
# A tibble: 2 × 5
verzija sredina medijan sd iqr
<chr> <dbl> <dbl> <dbl> <dbl>
1 izvorno 50.1 39 39.2 46.2
2 s ekstremom 57.5 39 145. 46.2Poglavlje uspoređuje i položaj sredine i medijana na izvornoj te na logaritamskoj ljestvici.
# A tibble: 2 × 4
  ljestvica    sredina medijan razlika
  <chr>          <dbl>   <dbl>   <dbl>
1 izvorna        50.1    39      11.1
2 logaritamska    3.61    3.66   -0.05
Na izvornoj ljestvici sredina znatno nadmašuje medijan, a nakon logaritamske pretvorbe razlika se gotovo gubi, jer pretvorba stišće dugi desni rep.
Izračuni iza četiriju prikaza iz poglavlja 5
Poglavlje o vizualizaciji pita što svaki prikaz čuva i što izračunava prije crtanja. Odgovor se najlakše vidi tako da se isti izračuni naprave izravno.
# A tibble: 4 × 4
  dobna_skupina    q1 medijan    q3
  <chr>         <dbl>   <dbl> <dbl>
1 18 do 24       53      68.5  99.2
2 25 do 34       30.8    46    72.5
3 35 do 44       18.2    26    44.5
4 45 i više       9      15    24.5
# A tibble: 4 × 2
dobna_skupina prosjek
<chr> <dbl>
1 18 do 24 81.5
2 25 do 34 54.4
3 35 do 44 32.4
4 45 i više 16.2Histogram računa broj opažanja u razredima, a raspršeni prikaz čuva pojedinačne parove vrijednosti. Nijedan ne zamjenjuje skupinu njezinom sredinom. Usporedba pokazuje koliko se informacije gubi na putu od svih opažanja do jednog stupca po skupini.
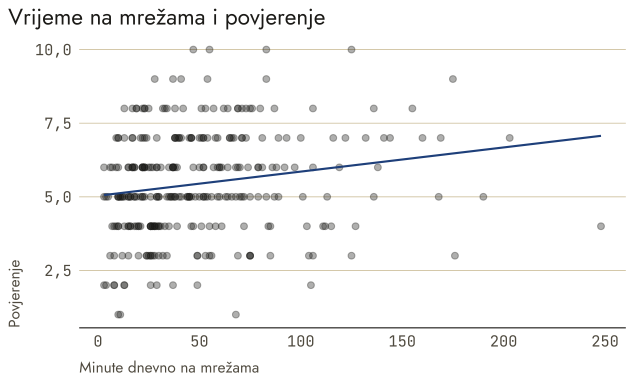
Obvezna vježba vizualizacije i povezanosti ostaje na distribuiranoj anketi. Najprije pogledajte oblik odnosa, a tek zatim izračunajte Pearsonov koeficijent.
ggplot(anketa_mreze, aes(x = minute_dnevno, y = povjerenje)) +
  geom_point(alpha = 0.35) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE) +
  labs(
    x = "Minute dnevno na mrežama",
    y = "Povjerenje",
    title = "Vrijeme na mrežama i povjerenje"
  )
anketa_mreze |>
  summarise(
    n = sum(complete.cases(minute_dnevno, povjerenje)),
    pearson_r = cor(minute_dnevno, povjerenje, use = "complete.obs")
  )
# A tibble: 1 × 2
n pearson_r
<int> <dbl>
1 300 0.180Koeficijent i graf čitamo zajedno. Koeficijent sažima linearnu povezanost, dok graf otkriva oblik, raspršenje i opažanja koja bi sažetak mogao prikriti.
Provjerene rute iz poglavlja 6–16
Samostalna provjerna skripta učitava kanonske datoteke izravno s diska, provjerava njihove sažetke i ponavlja po jedan postupak iz svakog poglavlja od 6 do 16. Ne učitava R/setup.R, ne izvršava kod iz poglavlja i ne ovisi o objektima stvorenima ranije. Nakon koraka učitavanja možete je pokrenuti iz nove R sesije.
Ruta koristi anketa_mreze za povezanost iz poglavlja 6 te populacija_medija za vjerojatnost, uzorkovanje, procjenu, testiranje, veličinu učinka, kategorijalnu analizu, dvije i više grupa te regresiju. Za primjer replikacija čita provjereni dokazni zapis notes/reports/p3-evidence12-rrr-lab-effects.csv. Jedan redak sažima rezultate jednoga laboratorija, a račun povezuje iste laboratorije koje smo razmatrali u poglavlju o krizi i obnovi istraživanja (Wagenmakers i sur. 2016.). Izračunava sirovu i standardiziranu granu te odgovara na pitanje koliko iznosi zajednički učinak laboratorijskih replikacija RRR-a. Imena datoteka, varijabli i istraživačka pitanja zapisana su u izlazu, pa se mogu usporediti s katalogom bez prepisivanja.
Wagenmakers, E.-J., T. Beek, L. Dijkhoff, Q. F. Gronau, i sur. 2016. „Registered Replication Report: Strack, Martin, & Stepper (1988)“. Perspectives on Psychological Science 11 (6): 917–28. https://doi.org/10.1177/1745691616674458.
Sljedeća tablica nastaje pokretanjem iste samostalne skripte tijekom izrade knjige. Stoga je i u tisku vidljiv stvarni provjereni izlaz, a ne ručno prepisana tvrdnja.
| poglavlje | datoteka | provjera | vrijednost |
|---|---|---|---|
| 6 | anketa-mreze.csv | Pearsonov r | 0,179849 |
| 7 | populacija-medija.csv | uvjetni udio mreža | 0,458576 |
| 8 | populacija-medija.csv | standardna pogreška, n = 100 | 0,198410 |
| 9 | populacija-medija.csv | sredina | 4,815000 |
| 9 | populacija-medija.csv | donja granica 95 % | 4,524857 |
| 9 | populacija-medija.csv | gornja granica 95 % | 5,105143 |
| 10 | populacija-medija.csv | razlika portal − tisak | -0,640939 |
| 10 | populacija-medija.csv | dvostrani permutacijski p | 0,011747 |
| 11 | populacija-medija.csv | Cohenov d, portal − tisak | -0,388898 |
| 12 | p3-evidence12-rrr-lab-effects.csv | sirova procjena učinka | 0,026766 |
| 12 | p3-evidence12-rrr-lab-effects.csv | donja sirova granica 95 % | -0,107693 |
| 12 | p3-evidence12-rrr-lab-effects.csv | gornja sirova granica 95 % | 0,161225 |
| 12 | p3-evidence12-rrr-lab-effects.csv | standardizirana procjena | 0,014151 |
| 12 | p3-evidence12-rrr-lab-effects.csv | donja standardizirana granica | -0,076191 |
| 12 | p3-evidence12-rrr-lab-effects.csv | gornja standardizirana granica | 0,104493 |
| 13 | populacija-medija.csv | hi-kvadrat | 6,037092 |
| 13 | populacija-medija.csv | Cramérov V | 0,050154 |
| 14 | populacija-medija.csv | razlika TV − mreže | 1,185714 |
| 14 | populacija-medija.csv | donja Welchova granica | 0,446686 |
| 14 | populacija-medija.csv | gornja Welchova granica | 1,924742 |
| 15 | populacija-medija.csv | F-omjer | 8,381813 |
| 15 | populacija-medija.csv | eta-kvadrat | 0,102053 |
| 16 | populacija-medija.csv | nagib dobi | 0,026885 |
| 16 | populacija-medija.csv | koeficijent mreža | -0,533534 |
| 16 | populacija-medija.csv | prilagođeni R-kvadrat | 0,122190 |
Datoteka outputs/dodatak-a-provjera.csv čuva više znamenki nego tablica provjerenih izlaza. Ako se promijeni ulaz, redak, sjeme ili očekivana vrijednost, skripta prekida rad umjesto da prikaže stari rezultat.
Reprodukcija tekstne tablice
Pripremljena tablica data/parlament_oznake.csv potječe iz hrvatskih zapisa skupa ParlaSent 1.0. Jedan redak pripremljene tablice predstavlja jednu označenu parlamentarnu rečenicu. Sirove datoteke nisu dio knjige. One se preuzimaju od izdavača pod uvjetima koje dokumentira putovnica podataka i spremaju u mapu data/_kandidat/p3-text. Time se ne pretvara vanjski skup u distribuirani knjižni podatak.
Skripta za pripremu zatim bira samo zapise na hrvatskom, provodi opisano razdvajanje na skup za učenje i provjeru te zapisuje tablicu za usporedbu oznaka tona. Ta tablica nema stranačku pripadnost, pa iz nje ne možemo izračunati razlike među strankama. Tu skriptu možete pokrenuti iz R-a sljedećim pozivom. Za ovaj dodatni reprodukcijski korak potreban je i Python.
Skripta za pripremu provjerava nazive i sažetke sirovih datoteka te očekuje 2698 redaka i SHA-256 izlaza 0f5b4221b583c54fa6996efb33e07541896a83219541029f4c677b56fae5f0ef. Samostalna ruta ima i mogućnost --text-candidate. Skriptu za pripremu pokreće tako da ona zapiše izlaz u privremenu datoteku, zatim uspoređuje izlaz i briše datoteku nakon provjere. Tako se provjerava transformacija bez prepisivanja distribuirane tablice.
Kamo dalje
Ovdje prikazano dovoljno je za opisnu analizu, čišćenje podataka i pripremu tablica koje knjiga koristi. Za sve dalje najkorisniji je R for Data Science, koji je slobodno dostupan i pisan u istom pristupu (Wickham i sur. 2023.).
Wickham, Hadley, Mine Çetinkaya-Rundel, i Garrett Grolemund. 2023. R for Data Science. 2. izd. O’Reilly Media. https://r4ds.hadley.nz/.
Pri samostalnom radu oslonite se na tri navike. Podatke pogledajte prije nego što ih obradite. Cjevovod gradite korak po korak i provjeravajte rezultat nakon svakog koraka. Analizu na kraju pokrenite iz čiste sesije. Time se uklanja dio problema s kojima se početnici susreću, a rad ostaje ponovljiv. Ponovljivo izvođenje važan je put provjere, uz ručnu kontrolu ključnih brojnosti, tablica i granica zaključka.