Procjena
Preciznost procjene u rasponu
Zamislimo da otvaramo ljestvicu školskih postignuća i odmah tražimo Hrvatsku. Iznad nje nekoliko poznatih zemalja, ispod nje neke druge. Takav je poredak lako pročitati kao ocjenu škole koju smo pohađali ili u koju ćemo upisati dijete. Svako mjesto izgleda određeno.
U istraživanju PISA 2022. postignuća petnaestogodišnjaka procijenjena su iz uzoraka učenika, pa OECD uz prosječne rezultate objavljuje intervale pouzdanosti i raspone mogućih mjesta na ljestvici (OECD 2023.). Zemlje s bliskim prosjecima tako mogu zauzimati više mogućih mjesta, ovisno o nesigurnosti procjene (OECD 2023.).
Koliko zapravo znamo o nečijem mjestu na ljestvici kad znamo samo njegov procijenjeni prosjek?
U simulacijama uzorkovanja mogli smo iznova odabirati ljude iz poznate populacije i pratiti kako se mijenjaju uzoračke sredine. Istraživač obično nema tu mogućnost. Pred njim je jedan skup odgovora, a treba navesti koliko bi se njegova procjena mogla promijeniti s drugim sudionicima. Standardna pogreška iz prethodnog poglavlja daje nam polazište za takav opis nesigurnosti.
Za razumijevanje intervala poslužit će nam jednostavniji nacrt od PISA-ina. Nastavljamo s nastavnom populacijom populacija_medija. Uzorak od 200 osoba izvlačimo iz nje zasebno od ranijih uzoraka, za procjenu prosječnog povjerenja u medije. Svako opažanje pripada jednoj računalno stvorenoj osobi i sadrži njezinu ocjenu povjerenja na ljestvici od jedan do deset. Zapisi ne opisuju stvarne stanovnike. Pri izgradnji procjene koristit ćemo uzorak, a poznatu populacijsku vrijednost zatim iskoristiti za provjeru postupka.
Oko procjene ćemo konstruirati interval i pratiti što se događa kroz ponovljena uzorkovanja. Pitanje je koliko često tako izrađen raspon obuhvaća ciljnu vrijednost. To će nam omogućiti da pouzdanost vežemo uz postupak, a širinu intervala uz preciznost. Usporedit ćemo što se mijenja kada tražimo višu pouzdanost i što dobivamo prikupljanjem više podataka. Posebno ćemo odvojiti nesigurnost procijenjenog prosjeka od razlika među pojedinačnim odgovorima.
Za procjenu medijana dnevnog praćenja medija poslužit će nam uzorak od 60 osoba, izvučen zasebno iz iste simulirane populacije. Njegove ćemo zapise ponovno izvlačiti, dopuštajući da ista osoba bude odabrana više puta. Taj postupak, bootstrap, omogućit će nam procijeniti promjenjivost i kada ne polazimo od gotove formule za odabranu mjeru. Razmotrit ćemo koliko takva provjera ovisi o uzorku kojim raspolažemo.
Uz procjenu u izvještaju navodimo raspon njezine nesigurnosti i objašnjavamo što bi precizniji odgovor zahtijevao. Interval pritom neće ukloniti ograničenja mjerenja ili odabira ljudi koja smo upoznali ranije.
Od točke prema rasponu
Uzorak od 200 osoba sada koristimo za procjenu povjerenja. Za svaku osobu koristimo povjerenje u medije na ljestvici od jedan do deset. Prosjek uzorka iznosi 4,82. Tu vrijednost zovemo točkasta procjena (point estimate). Ona sažima rezultat, a njegovu nesigurnost opisujemo zasebno. Isti prosjek možemo dobiti na dvadeset i na dvadeset tisuća ljudi, iako bi se pri ponovnom uzorkovanju te procjene mogle znatno različito mijenjati.
Za opis te promjenjivosti služi standardna pogreška, koju smo upoznali u prethodnom poglavlju. Ona procjenjuje koliko bi se rezultat tipično mijenjao kroz ponovljena uzorkovanja. U našem uzorku iznosi 0,148.
Račun intervala možemo pratiti od zbroja ocjena do njegovih granica. Zbroj svih ocjena u uzorku iznosi 963, pa dijeljenjem s 200 dobivamo 4,815. Uzoračka standardna devijacija 2,093 podijeljena korijenom iz 200 daje standardnu pogrešku 0,148. Umnožak te pogreške s 1,96 iznosi 0,290, što oduzimamo od sredine i dodajemo joj. Dobivene granice uspoređujemo s jednom fiksnom populacijskom sredinom, 4,881.
Provjerimo što iz toga možemo zaključiti u simulaciji s poznatom populacijom. Deset tisuća puta izvukli smo po dvjesto različitih osoba bez vraćanja, svaki put iz cijele populacije. Ponovno računamo i sredinu i standardnu pogrešku, pa se obje granice mijenjaju. Oko svake uzoračke sredine označili smo raspon od 1,96 njezinih standardnih pogrešaka na svaku stranu. Populacijska vrijednost nalazi se u 94,9 % raspona. Izvan raspona ostaje u 506 od 10 000 ponavljanja. Vidimo da pojedini raspon može promašiti cilj, ali i da možemo pratiti koliko ga često postupak obuhvaća. U račun uključujemo svih 10 000 intervala. Broj onih čije granice obuhvaćaju cilj dijelimo s 10 000. Dobiveni udio nazivamo obuhvatom intervala.
Središnji granični teorem pomaže objasniti taj rezultat. Pod njegovim uvjetima raspodjela uzoračkih sredina približno je normalna. U normalnoj raspodjeli oko 95 % vrijednosti nalazi se unutar 1,96 standardnih devijacija od središta. Za raspodjelu procjena tu udaljenost mjerimo standardnom pogreškom.
Ako je uzoračka sredina dovoljno blizu populacijskoj vrijednosti, i populacijska vrijednost jednako je blizu uzoračkoj sredini. Zato raspon od 1,96 standardnih pogrešaka na svaku stranu od procjene obuhvaća populacijsku vrijednost u približno 95 % ponavljanja, kada vrijede pretpostavke postupka.
Oznaka \(z^{*}\) govori koliko standardnih pogrešaka odmjeravamo na svaku stranu od procjene. Za razinu pouzdanosti od 95 % ona iznosi 1,96.
Normalne kritične vrijednosti za obostrane intervale iznose 1,645 za 90 %, 1,960 za 95 % i 2,576 za 99 %. Koristimo ih kada je raspodjela procjenitelja približno normalna i standardna pogreška dovoljno dobro poznata. Za ovdje prikazane jednostavne sredine potrebna su neovisna opažanja iz odgovarajuće populacije, konačna varijanca i uzorak bez dominantnih krajnjih vrijednosti. Pri malim uzorcima i procjeni raspršenosti iz istih podataka prikladan t-postupak upoznat ćemo uz usporedbu skupina.
\[ \bar{x} \pm z^{*} \cdot SE_{\bar{x}} \]
U našem uzorku dobivamo raspon od 4,52 do 5,11. Poznata populacijska vrijednost iznosi 4,88 i ovaj je raspon obuhvaća.
Definicija 1 Interval pouzdanosti je raspon oko procjene, izračunat postupkom koji kroz ponovljena uzorkovanja obuhvaća nepoznati parametar u unaprijed određenom udjelu slučajeva.
Razina pouzdanosti opisuje koliko često postupak obuhvaća cilj kada se uzorkovanje ponavlja. Tu razliku trebamo zadržati i kada tumačimo samo jedan izračunati interval.
Ovdje pouzdanost opisuje postupak intervalne procjene. U poglavlju o mjerenju ista se riječ odnosila na dosljednost mjerenja. Obuhvat intervala označuje koliko intervala sadrži cilj, a obuhvat okvira uzorkovanja govori tko je uopće mogao biti odabran.
U simetričnom intervalu udaljenost od procjene do bilo koje granice jest margina pogreške. Ona je polovica ukupne širine i broj uz znak ± koji smo susreli uz anketne rezultate. U ovom postupku iznosi \(z^{*}\cdot SE\). Asimetričan interval može imati različite udaljenosti od procjene do donje i gornje granice, pa ih treba navesti odvojeno. Opisuje promjenjivost zbog uzorkovanja pod pretpostavkama postupka. Ne uključuje pristran okvir uzorkovanja, neodgovor, formulaciju pitanja ni pogrešku mjerenja. Manja margina zato sama po sebi ne znači da je anketa kvalitetnija.
Obećanje razine pouzdanosti
Za provjeru granice postupka vratimo se izrazito asimetričnoj raspodjeli spremnosti na plaćanje iz prethodnog poglavlja. Iz nje smo 10 000 puta izvukli po 20 osoba i svaki put izračunali isti interval za sredinu. Poznatu populacijsku sredinu obuhvatilo je 8 622 intervala, odnosno 86,2 %. U malom uzorku iz takve raspodjele normalno približenje i procjena standardne pogreške nisu dovoljno pouzdani da bi postupak postigao zadanu razinu od 95 %.
U prethodnoj simulaciji povjerenja, s po dvjesto osoba, dobili smo obuhvat blizak zadanoj razini, ali podudaranje nije savršeno. Dobiveni obuhvat približan je iz dvaju razloga. U konačnom broju simulacija udio pogodaka slučajno se mijenja. Osim toga, nepoznatu populacijsku raspršenost procjenjujemo iz uzorka, što donosi dodatnu nesigurnost. Pri dvjesto osoba ona je mala, a pri dvadeset može biti važna. U poglavlju o dvjema grupama uvest ćemo postupak koji zbog toga širi interval u malim uzorcima.
Obuhvat od 94,9 % ne govori koji su pojedinačni intervali pogodili cilj. Svaki izračunati interval ili sadrži populacijsku vrijednost ili je ne sadrži. U frekventističkom postupku parametar je fiksan, a slučajan je uzorak iz kojega računamo granice. Zato razinu pouzdanosti ne tumačimo kao vjerojatnost da fiksni parametar leži unutar upravo opaženih granica.
Možemo to zamisliti kao bacanje obruča na kolac. Kolac stoji na istom mjestu, a obruči padaju na različita mjesta. Razina pouzdanosti opisuje koliko često obruč obuhvati kolac kroz mnogo bacanja. Nakon pojedinoga bacanja pogodak je već određen, čak i ako ga ne možemo vidjeti.
Iz objavljenog intervala možemo čitati koje su vrijednosti uskladive s podacima pod pretpostavkama postupka. Njegova širina pokazuje i jesmo li postigli željenu preciznost, primjerice marginu manju od deset minuta. Za pitanje o razlici ili promjeni trebamo interval za samu razliku. Predviđanje rezultata sljedećeg istraživanja zaseban je zadatak jer će ono imati vlastiti uzorak i vlastiti interval.
Interakcija — Hvatač intervala
Za prikaz intervala prelazimo na zaseban normalni model sa sredinom nula i poznatom standardnom devijacijom jedan. Pojedinačno opažanje sada je umjetno generirani broj, bez jedinice povjerenja. Iz svakog skupa od 40 neovisnih brojeva računamo sredinu i oko nje raspon \(1,96/\sqrt{40}\) na svaku stranu. Tiskani prikaz ponavlja to 50 puta. Ovdje je standardna pogreška poznata iz modela, za razliku od prethodnog računa u kojem smo je procjenjivali iz uzorka.
Na slici su intervali iz ponovljenih uzoraka poredani jedan ispod drugoga. Okomita crta označuje populacijsku vrijednost. Intervali koji je sijeku obuhvaćaju cilj. U tablici zatim uspoređujemo veličinu uzorka i razinu pouzdanosti. Obje utječu na širinu, a razina pouzdanosti određuje i dugoročnu učestalost obuhvata.
Što isprobati.
- Zadržite pedeset intervala i prebrojite one koji ne sijeku okomitu ciljnu crtu.
- Povećajte broj intervala na sto bez promjene veličine uzorka ili razine pouzdanosti.
- Usporedite širinu intervala pri uzorcima veličine dvadeset i sto.
- Promijenite razinu pouzdanosti s devedeset na devedeset i devet posto te opišite odnos širine i obuhvata.
Tiskane postavke za vježbu
Tri prikazane postavke koriste normalnu populaciju sa sredinom nula i standardnom devijacijom jedan. Svaka sadrži pedeset intervala iz istoga zadanog simulacijskog niza. A i B razlikuju se samo po razini pouzdanosti, a A i C samo po veličini uzorka.
| Mjera | A | B | C |
|---|---|---|---|
| Veličina uzorka | 40 | 40 | 160 |
| Razina pouzdanosti | 95 % | 99 % | 95 % |
| Kritična vrijednost z* | 1,960 | 2,576 | 1,960 |
| Broj intervala | 50 | 50 | 50 |
| Širina intervala | 0,620 | 0,815 | 0,310 |
| Broj promašaja | 3 | 0 | 1 |
Za zasebnu računsku provjeru na kraju poglavlja trebat će nam i sažetak cijele poznate sintetičke populacije po glavnom izvoru vijesti. Sljedeća tablica čuva točne cjelobrojne brojnosti i zbroj za portal, dok su udio i prosjek zaokruženi na pet decimala. Iz tih ćemo brojeva provjeriti dva dijeljenja. Provjera ne potvrđuje kako su pojedinačni zapisi zbrojeni. Taj je dodatni korak moguć u dobrovoljnoj mrežnoj vježbi. Podaci služe vježbi i ne opisuju stvarne stanovnike.
| Mjera | Vrijednost |
|---|---|
| Izvor vijesti | portal |
| Broj osoba | 15 101 |
| Ukupno osoba | 50 000 |
| Udio | 0,30202 |
| Zbroj povjerenja | 72 101 |
| Prosjek povjerenja | 4,77458 |
Preciznost nasuprot pouzdanosti
Za sljedeću usporedbu širina vraćamo se ocjenama povjerenja iz medijske populacije. Za svaku veličinu 50, 200 i 800 izvlačimo 400 novih uzoraka, računamo njihove intervale istim postupkom sa standardnom pogreškom iz uzorka i prosječimo 400 širina. Usporedba razina 90 %, 95 % i 99 % potom zadržava jedan isti početni uzorak od 200 osoba i mijenja samo množitelj.
Dvije usporedbe iz prikaza sada možemo razdvojiti i brojčano. Veći uzorak smanjuje standardnu pogrešku i sužava interval pri istoj razini pouzdanosti. Prosječna širina intervala pri pedeset osoba iznosi 1,09 boda, pri dvjesto 0,55, a pri osamsto 0,28. S više podataka dobivamo precizniju procjenu.
Povećanje razine pouzdanosti djeluje drukčije. Na istim podacima tražimo češći obuhvat, pa raspon mora biti širi. U našem uzorku interval od 90 % širok je 0,49 boda, interval od 95 % 0,58, a interval od 99 % 0,76. Viši zahtjev za obuhvat ovdje plaćamo širim rasponom, odnosno manjom preciznošću.
Preciznost opisuje širinu procjene, a pouzdanost odabranu dugoročnu učestalost obuhvata. Za isti postupak i razinu pouzdanosti više podataka obično daje uži interval. Za iste podatke viša razina pouzdanosti daje širi interval. U knjizi najčešće koristimo 95 %, no to je uobičajen izbor koji treba navesti uz rezultat.
Širok interval može biti primjeren opis maloga uzorka ili jako raspršenih podataka. Uzak interval također treba provjeriti. Ako je uzorak pristran, interval može biti uzak oko pogrešne vrijednosti jer ne obuhvaća pristranost postupka odabira.
Na grafu s više skupina intervali pokazuju koliko su njihove procjene precizne. Širina ovisi i o broju opažanja i o njihovoj raspršenosti. Takav graf govori više od prikaza samih prosjeka, ali za tumačenje razlika među skupinama treba još jedan korak.
Nepreklapanje usporedivih intervala može upućivati na razliku, ali preklapanje ne dokazuje jednakost. Tumačenje ovisi i o nacrtu istraživanja te o tome jesu li procjene povezane. Najizravnije je izračunati interval za samu razliku. To ćemo učiniti u poglavlju o dvjema grupama. Ni iz takve usporedbe ne dobivamo vjerojatnost da je razlika „stvarna”.
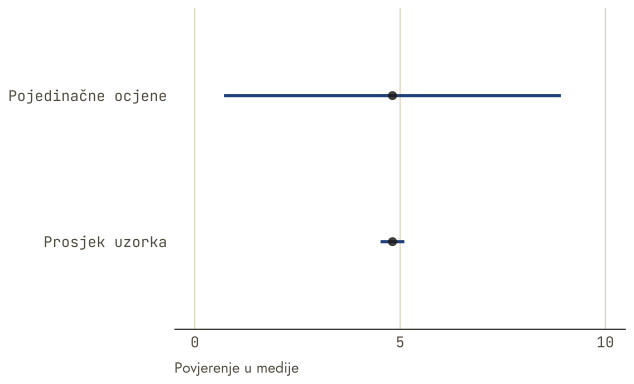
Treba razlikovati i nesigurnost prosjeka od raspršenosti pojedinačnih vrijednosti. Interval za sredinu u uzorku od 200 osoba širok je 0,58 boda. Ako su ocjene približno normalno raspoređene, raspon sredine plus ili minus 1,96 uzoračkih standardnih devijacija opisivao bi oko 95 % pojedinačnih ocjena. Taj je raspon širok približno 8,2 boda. Normalno pravilo ne daje takav obuhvat za izrazito asimetrične, ograničene ili diskretne raspodjele. Taj opisni raspon nije ni interval predviđanja za novu osobu, jer ne uključuje nesigurnost procjene središta i raspršenosti niti određuje populaciju buduće osobe. Veći uzorak sužava interval za sredinu, dok razlike među ljudima ostaju svojstvo populacije.
U PISA-inoj tablici prirodoslovne pismenosti za Hrvatsku je objavljena procjena od 483 boda, uz 95-postotni interval od 478 do 487 bodova i raspon mjesta od osamnaestoga do trideset petoga među sudionicama istraživanja (OECD 2023.). Taj raspon mjesta uzima u obzir nesigurnost procjena i višestruke usporedbe zemalja sličnih rezultata (OECD 2023.). Iz njega možemo vidjeti zašto jedno precizno ispisano mjesto prenosi više sigurnosti nego što je imamo. Raspon se odnosi na položaj procijenjenoga nacionalnog prosjeka. Za iskustvo pojedinoga učenika trebali bismo pogledati i razlike unutar zemlje.
OECD. 2023. PISA 2022 Results (Volume I): The State of Learning and Equity in Education. OECD Publishing. https://doi.org/10.1787/53f23881-en.
Kad bismo pripremali naslov o tim rezultatima, uz procjenu bismo zadržali njezinu nesigurnost i imenovali područje koje je ispitano. PISA pritom koristi složen uzorak škola i učenika te postupke procjene postignuća koje račun nesigurnosti mora uvažiti (OECD 2023.). Ovdje čitamo objavljene rezultate. Jednostavno ponovno izvlačenje pojedinačnih redaka, koje ćemo sada upoznati na našim simuliranim podacima, ne bi sačuvalo taj istraživački nacrt.
Bootstrap kao vlastiti izum
Za sredinu imamo jednostavnu formulu standardne pogreške. Za medijan, razliku percentila ili omjer račun može biti složeniji ili zahtijevati dodatne pretpostavke. Tada nam može pomoći ponovno uzorkovanje opaženih podataka.
Kad bismo mogli uzimati nove uzorke iz populacije, izračunali bismo medijan u svakome i promatrali koliko se mijenja. Budući da imamo samo jedan uzorak, pokušavamo ponoviti taj postupak izvlačenjem iz njegovih vrijednosti. Uzorak pritom mora razumno predstavljati ciljnu populaciju. Jednostavno ponovno uzorkovanje redaka pretpostavlja neovisne i međusobno zamjenjive jedinice na razini uzorkovanja. Ako su podaci upareni, grupirani ili ponovljeni, čuvamo tu strukturu i izvlačimo cijele parove, skupine ili osobe. Pod tim uvjetima novi uzorci iste veličine približno oponašaju promjene koje bi nastale ponovnim uzorkovanjem iz populacije.
Izvlačimo s vraćanjem. Bez vraćanja bismo iz uzorka od šezdeset osoba dobili istih šezdeset osoba u drugom redoslijedu, pa bi medijan uvijek bio jednak. S vraćanjem neke osobe ulaze više puta, a neke izostanu. Zbog promjene sastava mijenja se i procjena. Taj postupak zovemo bootstrap. Uveden je za procjenu nesigurnosti kada teorijski račun nije lako dostupan (Efron 1979.).
Efron, B. 1979. „Bootstrap Methods: Another Look at the Jackknife“. The Annals of Statistics 7 (1): 1–26. https://doi.org/10.1214/aos/1176344552.
Percentilni bootstrap interval uzima odabrane percentile ponovljenih procjena. Njegova je primjena najjednostavnija kada bootstrap raspodjela dobro oponaša raspršenost procjenitelja, bez izražene pristranosti ili asimetrije. Postoje i drugi bootstrap intervali koji korigiraju pomak ili asimetriju. Ovdje učimo samo najjednostavniji percentilni postupak. Ni taj postupak ne jamči točno zadanu razinu obuhvata. Mali ili diskretni uzorci, pristranost procjenitelja i vrlo asimetrične raspodjele mogu oslabiti približenje. Ponavljanje odabira iz postojećih redaka ne dodaje ljude koji su sustavno izostali iz početnog uzorka.
Sada uzimamo novi početni uzorak od 60 osoba iz iste medijske populacije. Izvlačimo ga zasebno od prethodnih 200 osoba, a pratimo dnevne minute umjesto povjerenja. U lijevoj polovici tablice vidimo prvih osam zapisa toga uzorka, a u desnoj prvih osam izvlačenja iz prvoga bootstrap uzorka. Broj retka desno upućuje na zapis u cijelom početnom uzorku od 60 osoba. Svako ponavljanje broja retka upućuje na ponovljen odabir iste osobe.
| Izvorni redak | Minute | Izvučeni redak | Minute |
|---|---|---|---|
| 1 | 83 | 19 | 161 |
| 2 | 82 | 5 | 164 |
| 3 | 134 | 29 | 106 |
| 4 | 139 | 28 | 116 |
| 5 | 164 | 60 | 342 |
| 6 | 133 | 51 | 264 |
| 7 | 256 | 40 | 221 |
| 8 | 288 | 48 | 194 |
Prvo ponovno izvlačenje uzima redak 19, pa prenosi njegovih 161 minuta. Nakon svih 60 izvlačenja imamo 39 različitih osoba, a medijan cijeloga ponovnog uzorka iznosi 176,0 minuta. Taj jedan broj ulazi u sljedeći histogram. Postupak 4 000 puta počinje od istoga početnog uzorka, svaki put s novim izvlačenjem s vraćanjem. Sva su ponavljanja definirana. Poredamo 4 000 medijana i uzmemo percentile 2,5 i 97,5, ostavljajući približno 100 vrijednosti sa svake strane.
U uzorku od 60 osoba medijan dnevnog praćenja medija iznosi 173,5 minuta. Iz četiri tisuće bootstrap uzoraka dobivamo središnji percentilni raspon od 155,0 do 194,0 minuta. On obuhvaća poznati populacijski medijan od 165,0 minuta. Na slici vidimo kako nastaje raspon iz jednoga uzorka. Za provjeru dugoročnog obuhvata trebali bismo ponavljati cijeli postupak s novim početnim uzorcima.
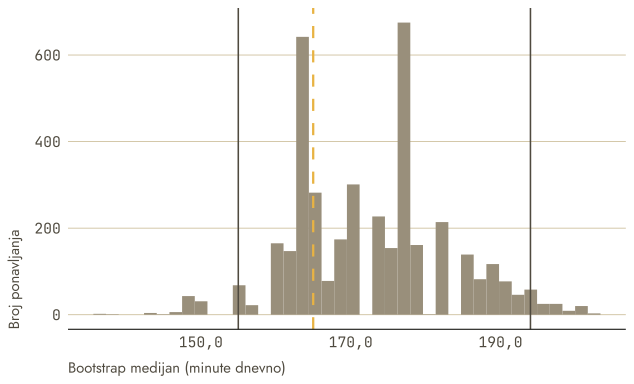
Histogram je stubast jer medijan maloga, zaokruženog uzorka može poprimiti samo ograničen broj vrijednosti. Zato su i granice percentilnog raspona grube. Više bootstrap ponavljanja smanjuje računalno kolebanje percentila, ali ne nadoknađuje vrijednosti koje nedostaju u početnom uzorku.
Bootstrap ne zahtijeva da unaprijed imenujemo oblik populacijske raspodjele, no način izvlačenja mora odgovarati statistici i nacrtu istraživanja. Za korelaciju izvlačimo cijele parove vrijednosti. Za razliku neovisnih skupina uzorkujemo svaku skupinu zasebno. Kod ovisnih podataka izvlačimo cijele neovisne jedinice. Postupak ne može dodati rijetke ili krajnje vrijednosti kojih u uzorku nema. Zato su vrlo visoki percentili posebno osjetljivi na male uzorke i teške repove. Medijan manje ovisi o repovima, ali mnogo jednakih vrijednosti može dati grube granice. Bootstrap također ne uklanja nereprezentativnost početnog uzorka.
Kodirani udio i dvije nesigurnosti
U poglavlju o povezanosti promjena pravila kodiranja promijenila je oznake istih naslova. Ponovno izvlačenje tih naslova ne bi samo po sebi provjerilo to pravilo. Kod udjela dobivenog kodiranjem teksta zato razlikujemo barem dva izvora nesigurnosti. Uzoračka nesigurnost odnosi se na odabir tekstova. Nesigurnost kodiranja odnosi se na pravila razvrstavanja, rubne slučajeve i odluke kodera ili klasifikatora. Ako kodirana kategorija samo približno odgovara istraživačkom pojmu, trebamo razmotriti i nesigurnost mjerenja.
Bootstrap redaka s gotovim oznakama mijenja sastav tekstova, ali zadržava njihove oznake. Uz ispravno odabranu jedinicu ponovnog uzorkovanja opisuje uzoračku nesigurnost. Valjanost kodiranja zahtijeva zasebnu provjeru oznaka i pravila. Drugo opravdano pravilo moglo bi promijeniti oznake rubnih tekstova i pomaknuti procijenjeni udio, čak i kada oba izračuna daju uske intervale. U izvještaju zato navodimo jedinicu teksta, ciljnu populaciju, način odabira i pravilo kodiranja te objašnjavamo koju nesigurnost interval uključuje.
Šest tvrdnji o jednom intervalu. Istraživač može uredno izračunati interval, a ipak pogrešno objasniti što iz njega slijedi. U istraživanju razumijevanja intervala studenti i istraživači prosuđivali su šest tumačenja rezultata iz zamišljenog istraživanja (Hoekstra i sur. 2014.). Sve su tvrdnje bile netočne, ali su ih obje skupine u prosjeku prihvatile više od tri (Hoekstra i sur. 2014.). Pogreška se dogodila pri čitanju rezultata, nakon što je račun već bio zadan.
Hoekstra, Rink, Richard D. Morey, Jeffrey N. Rouder, i Eric-Jan Wagenmakers. 2014. „Robust Misinterpretation of Confidence Intervals“. Psychonomic Bulletin & Review 21 (5): 1157–64. https://doi.org/10.3758/s13423-013-0572-3.
Razmotrimo vlastiti zamišljeni primjer. Studentska anketa treba procijeniti prosječno vrijeme putovanja na fakultet. U izvještaju stoji 95-postotni interval od 30 do 40 minuta. Autor bi mogao napisati da se unutar njega nalazi vrijeme putovanja 95 % studenata. Time bi raspon nesigurnosti procijenjenog prosjeka pretvorio u opis razlika među ljudima. Podaci o pojedinačnim putovanjima mogli bi biti mnogo raspršeniji.
Drugo bi iskušenje bilo napisati da je nakon ovog računa vjerojatnost položaja prave sredine između granica jednaka 95 %. U frekvencijskom postupku koji smo učili razina pouzdanosti pripada postupku ponovljenog uzorkovanja. Ako njegove pretpostavke vrijede, približno taj udio tako dobivenih intervala obuhvaćao bi pravu sredinu. Ne raspoređujemo vjerojatnost nepoznate sredine unutar ovoga već izračunatog intervala.
Za čitatelja studentskog izvještaja ta razlika ima praktičnu posljedicu. Interval prosjeka može pomoći da procijeni tipično opterećenje putovanjem, ali ne govori koliko studenata putuje izrazito dugo. Za odluku o pomoći tim studentima trebala bi raspodjela pojedinačnih vremena i prag koji za tu odluku ima smisla.
Autor zato treba imenovati veličinu koju procjenjuje i objasniti koju nesigurnost interval opisuje. U našem primjeru to je nesigurnost procjene prosječnog vremena pod uvjetima odabranog postupka. Prije pisanja zaključka zato razdvajamo nesigurnost prosjeka od razlika među pojedinačnim putovanjima. Razinu pouzdanosti pritom vežemo uz dugoročni obuhvat postupka, uz fiksnu nepoznatu populacijsku sredinu.
Vraćamo se uzorku od šezdeset osoba iz simuliranoga grada. Želimo procijeniti populacijski medijan dnevnog vremena uz medije. Vektor minute sadrži njihove pojedinačne vrijednosti, a osobe su uzorkovane neovisno. Asistent je vratio račun percentilnog bootstrap intervala.
Izračunani medijan uzorka iznosi 173,5 minuta, a granice intervala 155 i 194 minuta. To su rezultati nastavne simulacije. Uz njih stoji asistentovo objašnjenje.
U svakom ponavljanju uzorkujemo s vraćanjem isti broj osoba i računamo medijan. Granice izdvajaju središnjih 95 % bootstrap medijana. Zato postoji 95 % vjerojatnosti da je fiksni populacijski medijan između upravo dobivenih granica.
Napišite zamjensko objašnjenje za čitatelja izvještaja. Zadržite procjenu, granice i opis ponavljanja, a razinu od 95 % povežite s onim čemu ona pripada. Navedite što bi se mijenjalo kad bismo uzeli novi uzorak iz iste populacije.
Razrađeni primjer
Zamislimo naručitelja koji želi procijeniti koliko vremena dnevno odrasli stanovnici grada provode uz medije i koji traži marginu ne veću od deset minuta. Za vježbu tog zadatka koristimo već uvedeni uzorak od 60 osoba iz simuliranoga grada. Trebamo povezati izbor mjere s njegovim pitanjem, a zatim provjeriti daje li uzorak traženu preciznost.
Najprije biramo mjeru koja odgovara pitanju. Dnevne minute imaju dug rep prema velikim vrijednostima, koji povlači prosjek prema gore. Za opis uobičajene osobe zato biramo medijan. Budući da za njegovu standardnu pogrešku nemamo jednako jednostavan račun kao za sredinu, nesigurnost ćemo procijeniti bootstrapom.
Postupak je sličan simulaciji iz prethodnog poglavlja. Ovaj put izvlačimo iz opaženog uzorka, s vraćanjem, i u svakom ponavljanju računamo medijan.
Prikaži kod
    procjena   donja.2,5% gornja.97,5%
       173,5        155,0        194,0
Poziv sample uz argument replace mijenja sastav ponovnog uzorka tako što dopušta višekratni izbor iste osobe. Nakon računanja medijana u svakom ponavljanju, funkcija quantile određuje granice odsijecanjem zadanog udjela raspodjele sa svake strane. Tako kod povezuje ponovno izvlačenje s trima već prikazanim vrijednostima, medijanom uzorka i granicama njegova bootstrap raspona.
Za odrasle stanovnike simuliranoga grada procjenjujemo medijan dnevnog praćenja medija na 173,5 minuta. Jedinica je jedna osoba. Percentilni bootstrap raspon od 95 % ide od 155,0 do 194,0 minuta i pod navedenim uvjetima opisuje uzoračku promjenjivost medijana. Ukupna širina iznosi 39 minuta. Udaljenost od procjene do donje granice iznosi 18,5, a do gornje 20,5 minuta. Veća od tih udaljenosti prelazi traženih deset minuta. Trebamo izvijestiti o toj nepreciznosti ili prikupiti dodatne informacije. Iz raspona ne zaključujemo o promjeni. Kada uzorak ne bi predstavljao ciljnu populaciju, rezultat bismo ograničili na opis uzorka.
U simulaciji znamo da populacijski medijan iznosi 165,0 minuta i da je unutar dobivenih granica. Jedan pogodak ipak ne provjerava pouzdanost postupka. Ranijih deset tisuća ponavljanja odnosilo se na normalni interval za sredinu. Za provjeru bootstrap raspona medijana morali bismo svaki put izvući novi uzorak od 60 osoba, iz njega izračunati novi bootstrap raspon i prebrojiti obuhvate populacijskog medijana. To ovdje nismo učinili, pa prikaz ne dokazuje zadanu razinu obuhvata.
U izvještaju najprije navodimo procjenu, njezin raspon nesigurnosti i ograničenja. Ovdje trebamo reći da su podaci simulirani, da procjenjujemo medijan i da raspolažemo sa šezdeset osoba. Isti oblik izvještaja koristimo u stvarnom istraživanju, iako ondje obično ne znamo parametar s kojim bismo usporedili rezultat.
Od procjene do tvrdnje
Procjenu i širinu raspona već smo izračunali, ali naručitelju trebamo objasniti i na koga se rezultat odnosi. Šest pitanja u tablici povezuje naš račun s odabirom osoba, mjerenjem minuta i zahtjevom za preciznošću. Tako vidimo koje bi ograničenje moglo promijeniti konačnu rečenicu.
| Revizijsko pitanje | Primjena na bootstrap medijana |
|---|---|
| Koja je jedinica? | jedna zamišljena odrasla osoba s jednim zapisom dnevnih minuta |
| Tko ili što nedostaje? | uzorak je slučajno izvučen iz poznate sintetičke populacije, pa ne predstavlja stvarni grad ni osobe izvan te populacije |
| Koji je cilj tvrdnje? | populacijski medijan dnevnih minuta, opisan procjenom i rasponom uzoračke nesigurnosti |
| Gdje je neizvjesnost? | promjene sastava uzorka. Ne provjerava dugoročni obuhvat, mjerenje minuta ni prijenos na stvarne stanovnike |
| Koje drugo objašnjenje ostaje? | u stvarnoj anketi slab obuhvat, neodgovor ili pogrešno mjerenje mogli bi objasniti pomak procjene. Bootstrap takve izvore pogreške ne uklanja |
| Tko snosi posljedice? | ovdje nema stvarnih sudionika. U stvarnom projektu pretjerana preciznost mogla bi zavesti naručitelja i stanovnike |
Ti odgovori ograničavaju zaključak na ono što smo doista procijenili. Sintetički podaci služe provjeri postupka u zadanom modelu. Uzorački interval opisuje promjenjivost zbog odabira, dok nesigurnost mjerenja ili kodiranja treba zasebno procijeniti. Karta tvrdnji u nastavku pokazuje šest različitih dosega analize.
| Dimenzija tvrdnje | Što ovaj dokaz dopušta |
|---|---|
| opis | opisuje medijan i raspodjelu minuta u opaženom sintetičkom uzorku |
| povezanost | nije poduprta jer primjer ne uspoređuje dvije varijable |
| generalizacija | usmjerena je na poznatu sintetičku populaciju pod postupkom slučajnoga odabira, bez prava prijenosa na stvarni grad |
| predviđanje | nije poduprto jer nije izgrađeno ni provjereno pravilo za nova opažanja |
| uzročnost | nije poduprta jer nema intervencije ni usporedbe mogućih ishoda |
| odluka | poduprta je odluka da raspon ne ispunjava unaprijed zadanu marginu od najviše deset minuta, ali ne tvrdnja o promjeni ni odluka o medijskoj politici |
Na kraju ovoga dijela provjerite možete li odgovoriti na četiri pitanja. Zašto među pedeset simuliranih intervala ne mora biti točno pet posto promašaja? Zašto bootstrap gotovih oznaka ne uključuje nesigurnost kodiranja? Što trebamo navesti uz procjenu i zašto najprije imenujemo populaciju? Zašto povećanje prigodnog uzorka ne uklanja razliku između ljudi koji su u njega mogli ući i ciljne populacije?
Tablica provjere pokazuje što smo tražili od asistenta, što je vratio i kako smo provjerili rezultat. Možemo je pročitati i bez pisanja koda.
| Polje računa | Bootstrap medijana |
|---|---|
| Što je traženo | procijeniti populacijski medijan dnevnih minuta i njegovu uzoračku nesigurnost iz uzorka neovisnih osoba |
| Što je vraćeno | točkasta procjena te donja i gornja granica središnjega percentilnog raspona |
| Što je provjereno | puna veličina ponovnog uzorka, izvlačenje s vraćanjem, ista statistika u svakom ponavljanju i redoslijed izvještavanja |
| Kako je provjereno | čitanjem poziva sample, median, replicate i quantile te usporedbom ispisa s brojkama u prozi |
| Uloga AI-ja | instrument i pogrešiv analitičar |
| Što je ostalo neprovjereno | dugoročni obuhvat percentilnoga postupka za medijan, reprezentativnost u stvarnom istraživanju i valjanost mjerenja minuta |
| Odgovorna osoba | osoba koja odabire procjenjivanu količinu, provjerava račun i potpisuje zaključak |
Sažetak
Točkasta procjena postaje informativnija kada uz nju prikažemo interval i objasnimo koju nesigurnost on obuhvaća. Razina pouzdanosti opisuje dugoročni obuhvat postupka, pa viša razina na istim podacima širi interval, dok ga veći uzorak obično sužava. Kada nemamo jednostavnu formulu, bootstrapom ponovno izvlačimo iz opaženoga uzorka i procjenjujemo uzoračku promjenjivost, čuvajući jedinicu i strukturu nacrta. Time ne popravljamo premalen ili pristran uzorak, a pri ponovnom izvlačenju gotovih oznaka teksta ne uključujemo nesigurnost kodiranja ili mjerenja. U izvještaju zato povezujemo ciljnu populaciju i jedinicu s procjenom, mjernom jedinicom, intervalom i ograničenjima. U poglavlju o testiranju toj procjeni pridružujemo drugo pitanje, koliko bi opaženi rezultat bio neobičan pod određenom pretpostavkom.
Pojmovi
- točkasta procjena
- point estimate
- kritična vrijednost
- critical value
- obuhvat intervala
- coverage
procjena (estimate), interval pouzdanosti (confidence interval), razina pouzdanosti (confidence level), margina pogreške (margin of error), preciznost (precision), bootstrap (bootstrap), percentilni raspon (percentile interval), jedinica ponovnog uzorkovanja (resampling unit), nesigurnost kodiranja (coding uncertainty)
Zadaci
Nakon vlastitog pokušaja otvorite naznake i provjere rješenja.
Konceptualni
Objasnite zašto razina pouzdanosti pripada postupku, a ne nepoznatom parametru nakon izračuna intervala. U objašnjenju navedite što je u postupku slučajno, a što fiksno, zašto ta podjela isključuje rečenicu o vjerojatnosti da parametar leži unutar zadanih granica te zašto bootstrap gotovih oznaka teksta ne obuhvaća nesigurnost pravila kodiranja. Predajte jedan odlomak.
Računski
Najprije razlikujte točkastu procjenu, standardnu pogrešku i marginu pogreške. U ranijem uzorku od 200 osoba prosjek povjerenja iznosi 4,815, a standardna devijacija zaokruženo 2,093 boda. Iz tih vrijednosti izračunajte standardnu pogrešku, marginu \(1,96 \cdot SE\) i obje granice približnoga 95-postotnog intervala. Jednom rečenicom protumačite čemu pripada razina od 95 %.
Za ručnu demonstraciju bootstrapa uzmite prvih pet već prikazanih vrijednosti dnevnih minuta, 83, 82, 134, 139 i 164. Zadajemo ponovno izvlačenje redaka 1, 1, 2, 4 i 5. Zapišite dobivene vrijednosti i usporedite njihov medijan s medijanom početnih pet vrijednosti. Objasnite zašto jedno takvo izvlačenje još ne daje interval pouzdanosti.
U tiskanoj tablici s trima postavkama najprije promotrite samo veličinu uzorka i razinu pouzdanosti. Predvidite poredak širina i dugoročni obuhvat. Izračunajte širine kao \(2z^*/\sqrt{n}\) i usporedite ih s tablicom. Očitajte promašaje i objasnite zašto njihov manji broj u C nego u A ne znači višu razinu pouzdanosti. Iz agregatne tablice podijelite broj korisnika portala ukupnim brojem osoba, a zbroj njihova povjerenja brojem korisnika portala. Predajte predviđanje, usporedbu s rezultatima, tri računa širine i dva dijeljenja uspoređena s objavljenim vrijednostima. Objasnite zašto iz agregata možemo provjeriti račun, ali ne potvrditi kako su pojedinačni zapisi zbrojeni.
Za dobrovoljnu provjeru pojedinačnih zapisa mrežni dodaci A i B pokazuju kako otvoriti data/populacija-medija.csv i usporediti isti podskup s agregatom. Ta provjera nije uvjet tiskanoga zadatka.
Kritički
Vratite se prikazu Istraživač margine pogreške u poglavlju o tome kako brojke zavode. Usporedite stanje s uzorkom od 1000 osoba bez pristranosti i stanje s jednakim uzorkom te pristranošću od šest postotnih bodova. Oba pokazuju procjenu od 52 %. Primijenite karticu za čitanje ankete iz poglavlja o mjerenju i sadašnje znanje o intervalima. Objasnite zašto ista uska margina pogreške ne može obuhvatiti pristranost odabira, navedite koji je izvor nesigurnosti unutar, a koji izvan intervala te napišite ispravljenu tvrdnju za pristrano stanje. Predajte usporedbu dvaju stanja i ispravljenu tvrdnju.
Revizija modela
Pročitajte račun iz okvira o pogrešci. Za svaki od poziva replicate, sample, median i quantile jednom rečenicom povežite redak koda s pojmom koji provodi. Zatim izdvojite jedinu pogrešnu rečenicu i napišite frekventistički ispravnu zamjenu koja zadržava razinu od 95 %, procjenu i granice intervala. Kod ne treba prepisivati ni mijenjati.