| Ispitanik | Dob | Minute dnevno | Povjerenje (1–10) |
|---|---|---|---|
| I001 | 22 | 69 | 6 |
| I002 | 22 | 53 | 8 |
| I003 | 24 | 83 | 10 |
Sažimanje podataka
Što sredina otkriva, a što raspodjela skriva
Zamislimo da pratite temu koja vas zanima i stalno nailazite na objave istih nekoliko portala. Znači li to da se tom temom bavi malen broj izvora ili da nekoliko velikih izvora zaklanja mnoštvo manjih? Za urednika koji želi opisati prisutnost neke teme na internetu ta razlika mijenja priču.
Takvo ćemo pitanje postaviti podacima projekta DigiKat. U odabrani korpus, odnosno skup tekstova za analizu, ulaze praćene objave s najmanje dva različita katolička pojma s projektnog popisa (Šikić i sur. 2026.). Zamišljeni urednik iz njihovih brojnosti želi doznati koliko objava ima tipičan izvor i gdje se objave najviše koncentriraju.
Kad bismo sve objave ravnomjerno podijelili među izvorima, dobili bismo jedan broj. Bi li nam taj broj pomogao zamisliti izvor na koji ćemo naići među mnogim manjima? I što prije računanja moramo znati o tablici koju smo dobili?
Urednikovo pitanje zahtijeva izbor mjere, ali i pripremu podataka iz kojih ćemo je izračunati. Prije usporedbe prosjeka s drugim sažecima provjerit ćemo usporedivost zapisa te razlikovati odsutno mjerenje od izmjerene nule.
Dosadašnja pitanja o jedinici, nazivniku i podrijetlu podataka sada primjenjujemo pri pripremi vlastite analize. Polazimo od stvarnih zbirnih tablica projekta DigiKat Hrvatskoga katoličkog sveučilišta (Šikić i sur. 2026.). U njima redak predstavlja platformu u određenom razdoblju ili internetsku domenu tijekom obuhvata datoteke. Broj objava, doseg i interakcije različite su veličine, a njihova dostupnost nije jednaka. Provjerit ćemo koji se zapisi mogu spojiti, što pritom mora ostati nepromijenjeno i koje vrijednosti možemo uključiti u sažetak.
Da bismo lakše pratili kako se računaju prosjek i druge mjere, poslužit ćemo se skupom podataka anketa_mreze. To je tablica koja izgleda kao rezultat ankete. Svaki redak opisuje zamišljenu osobu, njezinu dob, dnevne minute na društvenim mrežama i povjerenje u tamošnji sadržaj. Podatke smo stvorili računalnom simulacijom, zasebno od populacije medijskih navika iz ranijih poglavlja. Na istim ćemo odgovorima usporediti što nam pojedina mjera govori o tim zamišljenim osobama.
Sredina i medijan opisuju središte raspodjele, a mjere raspršenosti razlike među opažanjima. Njihovu prikladnost provjeravamo prema obliku podataka i reakciji na pomicanje krajnjih vrijednosti. Standardizacijom opisujemo položaj opažanja u odnosu na ostala. Na kraju se vraćamo DigiKatovim domenama i sastavljamo brojčani opis s jasno navedenim značenjem i granicom svake mjere.
Od izvora do sažetka
Za vlastitu analizu trebamo analitičku tablicu. Pri njezinoj izradi određujemo što predstavlja redak, kojim ključem povezujemo zapise i kako tumačimo kodove. Bilježimo filtre i pravila za nedostajuće vrijednosti kako bi druga osoba mogla ponoviti postupak.
Tri tablice, tri jedinice
DigiKatov izbor tekstova određuje i granicu našeg zaključka. Tablice opisuju objave obuhvaćene pravilima projekta, a ne slučajan uzorak hrvatskih medija, publike ili korisnika (Šikić i sur. 2026.). Raspolažemo već izračunatim zbrojevima, bez pojedinačnih objava. Prije računanja zato provjeravamo predstavljaju li retci različitih datoteka usporedive jedinice.
| Datoteka | Što predstavlja redak | Ključ | Redaka |
|---|---|---|---|
| mjesečna | platforma u mjesecu | mjesec + platforma | 438 |
| godišnja | platforma u godini | godina + platforma | 49 |
| izvori | imenovana domena kroz cijeli raspon | izvor | 3 604 |
Datoteka domena nema zajednički ključ s platformskim tablicama pa je analiziramo zasebno. Ona pokazuje raspored objava među domenama. Mjesečne i godišnje podatke o platformama možemo povezati parom godina + platforma. Izostavljanjem jednog dijela ključa spojili bismo zapise koji ne pripadaju istoj jedinici.
U mjesečnoj tablici, primjerice, jedan redak bilježi 11.701 obuhvaćenu objavu na webu u siječnju 2021. (Šikić i sur. 2026.). U tablici domena redak za hkm.hr bilježi 56.500 objava kroz cijeli obuhvaćeni raspon (Šikić i sur. 2026.). Prvi broj opisuje platformu i mjesec, a drugi jednu domenu kroz više godina. Oba broje objave. Za broj jedinstvenih čitatelja trebali bismo podatke o publici.
Ključ prije sažetka
Mjesečna tablica ima 438 redaka, svaki s jedinstvenim ključem mjesec + platforma. Iz godišnje joj tablice pridružujemo godišnji nazivnik i oznaku potpunosti. Nakon ispravnog spajanja broj redaka i ukupan broj objava moraju ostati isti. Ako spojimo samo po godini, svaki mjesečni redak dobit će par sa svim platformama te godine i pojavit će se više puta.
Za dva mjesečna zapisa weba vidimo što je spoj dodao. Mjesec i njegov broj objava dolaze iz mjesečne datoteke, a ukupni godišnji nazivnik iz godišnje. Tražimo podudaranje i godine i platforme. Oba mjesečna zapisa tako dobivaju isti godišnji nazivnik, bez ponovnog brojanja njihovih objava.
| Mjesec | Platforma | Mjesečne objave | Godišnji nazivnik |
|---|---|---|---|
| 2021-01 | web | 11 701 | 90 388 |
| 2021-02 | web | 6 619 | 90 388 |
U sljedećoj tablici uspoređujemo broj redaka, jedinstvene mjesečne ključeve i zbroj objava prije i nakon ispravnog spajanja.
| Postupak | Redaka | Jedinstvenih mjesečnih ključeva | Zbroj objava |
|---|---|---|---|
| Mjesečna datoteka prije spajanja | 438 | 438 | 710 307 |
| Ispravno: godina + platforma | 438 | 438 | 710 307 |
Provjeravamo i pojedine ćelije, jer jednak ukupan zbroj ne jamči njihovo slaganje. Mjesečni i godišnji izvadak razlikuju se u 17 od 49 kombinacija platforme i godine, a odstupanja se u ukupnom zbroju poništavaju. Zato ne zamjenjujemo mjesečne vrijednosti godišnjima i ne gradimo neprekinut trend. Za daljnju analizu koristimo potpunu 2025. godinu, uz isključenje 2024. zbog praznine i promjene metode. U 2024. nedostaju mjesečni retci od veljače do svibnja, siječanj je djelomičan, a lipanj označuje promjenu metode i obuhvata (Šikić i sur. 2026.).
Kada nula znači da mjera nije dostupna
U podacima za 2025. svih devet platformi ima zabilježen broj objava. Za tri od njih nema usporedivog podatka o dosegu i interakcijama. Ondje zapisana nula, uz oznaku metrika_dostupna = ne, znači da mjerenje nije dostupno. Izvorni stupac čuvamo, a za analizu izrađujemo novi u kojem te nule označujemo kao nedostajuće vrijednosti.
Primjerice, u mjesečnom retku za reddit izvorno je uz interakcije zapisana nula, ali oznaka dostupnosti glasi ne. Analitički zapis zato čuva broj objava, a interakcije pretvara u oznaku nedostajanja. Tako redak ostaje dostupan za analizu objava, a prosjek interakcija računamo samo iz dostupnih mjerenja.
To se odnosi na platforme reddit, forum i comment, koje zajedno imaju 7 648 objava. Metapodaci potvrđuju da metrika nedostaje zbog načina mjerenja. Broj objava zato možemo sažeti za svih devet platformi, a angažman samo za šest s dostupnom metrikom. Učinak sužavanja skupa provjeravamo na broju objava, koji poznajemo za sve platforme. Doseg i interakcije nedostajućih platformi ne možemo tako usporediti.
| Pravilo | Platformi | Medijan objava |
|---|---|---|
| Sve platforme za broj objava | 9 | 2 724,0 |
| Samo platforme s metrikom angažmana | 6 | 14 807,5 |
Medijan, središnja vrijednost u poredanom nizu, mijenja se s 2 724,0 na 14 807,5 objava. Usporedili smo svih devet vrsta platformi sa šest koje imaju metriku angažmana. Promijenio se skup na koji se rezultat odnosi. O dosegu i interakcijama preostalih triju platformi i dalje nemamo podatke.
Za ručnu provjeru poredani brojevi objava po platformama u 2025. iznose 231, 1.641, 1.779, 2.122, 2.724, 4.228, 26.891, 44.502 i 152.048 (Šikić i sur. 2026.). Izbacivanjem platformi bez metrike angažmana uklanjamo vrijednosti 1.641, 1.779 i 4.228 (Šikić i sur. 2026.).
Nazivnik je dio tvrdnje
Za udio trebamo znati i ukupnu količinu. Ako riječi brojimo prema razmacima, ne razlikujući velika i mala slova, Analysis se u naslovu Exploratory Data Analysis pojavljuje jednom među trima riječima (Tukey 1977.). U naslovu Statistical Power Analysis for the Behavioral Sciences također se pojavljuje jednom, ali među sedam riječi (Cohen 1988.). Učestalost je ista, dok se udjeli razlikuju zbog duljine naslova.
Tukey, John W. 1977. Exploratory Data Analysis. Addison-Wesley.
Cohen, Jacob. 1988. Statistical Power Analysis for the Behavioral Sciences. 2. izd. Lawrence Erlbaum Associates.
Tablica imenovanih domena ima 3 604 redaka i ukupno 551 712 objava. Za udjele objava među tim domenama zato koristimo nazivnik 551.712. Nazivnik 710.307 iz platformskih tablica odnosi se na drugi obuhvat.
Ponašanje sredine i drugih mjera lakše ćemo pratiti na tablici pojedinačnih odgovora. Zato prelazimo na skup anketa_mreze, simuliranu anketu s 300 ispitanika. Jedan redak predstavlja jednu zamišljenu osobu. Za nju su zadani dob, dnevne minute na društvenim mrežama i povjerenje u tamošnji sadržaj na ljestvici od 1 do 10. Skup je generiran zasebno, neovisno o ranije uvedenoj populaciji medijskih navika.
Generator je zadao četiri dobne skupine s 90, 84, 66 i 60 osoba. Unutar svake dob je slučajno odabrana iz njezina raspona, a minute nastaju zasebnim izvlačenjem pozitivnih, desno asimetričnih vrijednosti. Tipična vrijednost minuta niža je u starijim skupinama. Zaokruživanjem zadržavamo barem jednu minutu. Povjerenju također zadajemo niže prosjeke u starijim skupinama, uz slučajna odstupanja i granice ljestvice od 1 do 10.
Nekoliko pojedinačnih zapisa omogućuje da prije prosjeka vidimo što se zbraja. Oznaka ispitanika služi razlikovanju redaka. Dnevne minute i ocjena povjerenja dvije su odvojene varijable.
Na istoj ćemo anketi poslije usporediti grafove, izračunati povezanost i sastaviti završno istraživanje. Vrijednosti su stvorene tako da većina osoba provodi kraće vrijeme na mrežama, a manji dio znatno dulje. Takav oblik omogućuje da vidimo zašto sredina i medijan daju različite opise. Tumačenje zato ostaje unutar zadanog nastavnog primjera.
Dnevnik transformacija bilježi što smo promijenili između izvora i analize, prema kojem pravilu i s kakvim učinkom na broj redaka ili rezultat. Ovdje u njega pripadaju ključ spajanja, isključeno razdoblje i razlikovanje nedostupne metrike od nule. Osjetljivost na odluku o podacima znači da provjerimo mijenja li se zaključak uz drugu opravdanu odluku, primjerice uz drukčiji obuhvat dostupnih platformi.
Poštena rečenica izvještaja imenuje jedinicu, obuhvat, mjeru i granicu zaključka. Rečenica o medijanu objava po domeni zato mora reći odnosi li se na sve domene ili samo one s dostupnom metrikom. Uz uzoračku procjenu dodaje se odgovarajući opis nesigurnosti. Precizan broj bez tih podataka ostavlja čitatelju da sam izmisli doseg tvrdnje.
Mjere središta
Prosjek dobivamo kada ukupno vrijeme ravnomjerno rasporedimo među ispitanicima. U formuli \(n\) označuje broj opažanja, a \(x_i\) vrijednost za pojedinog ispitanika. Crta iznad slova označuje aritmetičku sredinu tih vrijednosti.
\[ \bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i \]
Definicija 1 Aritmetička sredina je zbroj svih izmjerenih vrijednosti podijeljen njihovim brojem.
Zbroj minuta svih 300 osoba iznosi 15 019. Dijeljenjem toga zbroja s 300 dobivamo 50,06 minuta. Tri prikazana retka samo su početak toga zbrajanja. Svih 300 odgovora ovdje je dostupno.
Sredina iznosi 50,1 minuta dnevno, ali samo 40 % ljudi provodi više vremena od toga. Ukupno smo vrijeme ravnomjerno podijelili među svim ispitanicima, pa su i rijetke velike vrijednosti podigle dobiveni broj. Ako nas zanima osoba u sredini poretka, trebamo drukčiji sažetak. Do njega ćemo doći promatrajući što se događa kada krajnjim vrijednostima postupno smanjujemo utjecaj.
Utjecaj krajnjih vrijednosti možemo ublažiti skraćenom sredinom (trimmed mean). Poredamo opažanja, uklonimo unaprijed zadan jednak udio s oba kraja i izračunamo sredinu ostatka. U našem uzorku po 5 % znači 15 najmanjih i 15 najvećih vrijednosti, pa novi zbroj dijelimo s 270. Uz po 10 % ostaje 240 vrijednosti. Nakon uklanjanja po 5 % s oba kraja ovdje dobivamo 46,1 minuta, a uz po 10 % dobivamo 44,1.
Nastavimo li uklanjati vrijednosti s oba kraja, približavamo se medijanu, središtu poredanog niza. Različit odnos prema krajnjim vrijednostima možemo izraziti i računom odstupanja. Zbroj kvadriranih odstupanja najmanji je kada ih računamo od sredine. Kvadriranjem velika odstupanja dobivaju veću težinu. Medijan pak daje najmanji zbroj apsolutnih odstupanja, bez njihova kvadriranja. Zato te dvije mjere mogu dati različite vrijednosti središta podataka.
Definicija 2 Medijan je vrijednost koja poredani niz opažanja dijeli na dvije jednako velike polovine.
U poredanih 300 odgovora središnja su mjesta 150 i 151. Na njima su 39 i 39 minuta. Njihov prosjek daje medijan. Poredak nam omogućuje pronalaženje središnjih mjesta među zapisima istih osoba.
Medijan je 39 minuta, što je 11,1 minuta manje od sredine. Takav razmak potiče nas da pogledamo graf. Može nastati zbog repa prema velikim vrijednostima, ali i zbog mješavine skupina ili složenijeg oblika raspodjele. Još jedna mjera središta, mod, označuje najčešću vrijednost. Za kontinuirano vrijeme korištenja ovdje nam malo koristi, dok za cjelobrojne odgovore o povjerenju iznosi 5. Kod kategorija mod pokazuje koja je najčešća, bez računanja prosjeka kategorijskih oznaka.
Mjere raspršenosti
Uz središte trebamo opisati koliko se vrijednosti razlikuju. Zamislimo dva portala s istim prosjekom komentara po članku. Na prvom svaki članak ima između 45 i 55 komentara. Na drugom neki nemaju nijedan, a poneki imaju 200. Tu razliku u raspodjeli trebamo prikazati uz zajednički prosjek.
Raspon je razlika najveće i najmanje vrijednosti. Vrijeme u našem uzorku kreće se od 3 do 248 minuta, uz raspon od 245 minuta. Raspon ovisi samo o dvama krajnjim opažanjima. Za raspored ostalih vrijednosti trebamo dodatne mjere.
Za potpuniji opis razmatramo odstupanje svake vrijednosti od sredine. Njegova apsolutna vrijednost daje udaljenost bez obzira na smjer. Prosjek tih udaljenosti, prosječno apsolutno odstupanje, govori koliko se opažanja u prosjeku udaljavaju od sredine.
\[ \text{PAO} = \frac{1}{n} \sum_{i=1}^{n} |x_i - \bar{x}| \]
Ovdje prosječno apsolutno odstupanje iznosi 29,4 minuta. Umjesto apsolutnih odstupanja mnogi postupci koriste kvadrirana jer ih je lakše povezati s kasnijim modelima. Tako dolazimo do varijance, koju je nešto teže izravno protumačiti.
\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]
Za varijancu uzorka zbroj kvadriranih odstupanja dijelimo s \(n-1\). To je Besselova korekcija. Povezana je s time što smo sredinu procijenili iz istog uzorka. U poglavlju o uzorkovanju simulacijom ćemo vidjeti zašto takvo dijeljenje uklanja dugoročnu pristranost procjene.
Uzoračke veličine zapisujemo latiničnim slovima. Sredina je \(\bar{x}\), a varijanca \(s^2\). Populacijsku sredinu označujemo grčkim slovom \(\mu\), a populacijsku varijancu oznakom \(\sigma^2\). Veličina uzorka je \(n\), dok \(N\) označuje veličinu populacije.
U toj ćemo simulaciji mnogo puta izvući uzorak iz iste poznate populacije i usporediti što se dugoročno događa s djeliteljima \(n\) i \(n-1\).
Prva osoba ima 69 minuta. Odstupanje od sredine iznosi 18,94, a njegov kvadrat 358,60. Takav kvadrat računamo za svaku osobu, zbrajamo svih 300 vrijednosti i dijelimo s 299. Pri kvadriranju zadržavamo punu preciznost odstupanja. Prikaz na dvije decimale služi čitanju rezultata.
Varijanca iznosi 1 533,3 kvadriranih minuta. Kvadrira se i mjerna jedinica, zbog čega broj nije lako tumačiti u izvještaju. Kvadriranje također povećava utjecaj krajnjih vrijednosti. Dvostruko veće odstupanje pridonosi zbroju četverostruko više.
Standardna devijacija i kvartili
Vađenjem korijena iz varijance vraćamo se na izvornu mjernu jedinicu, ovdje minute.
Definicija 3 Standardna devijacija uzorka korijen je varijance. Varijancu računamo dijeljenjem zbroja kvadriranih odstupanja od sredine s \(n-1\), a korijen vraća raspršenost u jedinice izvornih vrijednosti.
\[ s = \sqrt{\frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2} \]
Standardna devijacija ovdje iznosi 39,2 minuta i veća je od prosječnog apsolutnog odstupanja od 29,4 minuta. Kvadriranje daje veću težinu velikim odstupanjima. Zato standardnu devijaciju možemo samo približno opisati kao tipičnu udaljenost od sredine.
Za normalnu raspodjelu, koju ćemo razraditi u poglavlju o vjerojatnosti, postoji korisno pravilo. U približno normalnoj raspodjeli oko 68 % opažanja nalazi se unutar jedne standardne devijacije od sredine, oko 95 % unutar dviju, a oko 99,7 % unutar triju. U našem je uzorku unutar jedne devijacije 79,3 % ispitanika. Raspon dviju devijacija ide od minus 28,3 do 128,4 minuta. Budući da trajanje ne može biti negativno, taj raspon upozorava da trebamo provjeriti odgovara li normalno pravilo podacima. Sam po sebi ipak ne određuje oblik raspodjele.
Unutar dviju devijacija ovdje se nalazi 95,0 % ispitanika, gotovo kao prema normalnom pravilu. Procjena približne normalnosti traži pregled cijele raspodjele, uz ovo pojedinačno podudaranje.
Ako želimo opis raspršenosti koji manje ovisi o krajnjim vrijednostima, možemo se, kao kod medijana, osloniti na položaje u poredanom nizu. Percentil je vrijednost ispod koje se nalazi zadani postotak opažanja, pa je medijan pedeseti percentil. Prvi kvartil odvaja donjih 25 %, a treći gornjih 25 %. Njihova razlika obuhvaća raspon središnje polovine podataka.
| Percentil | Minuta |
|---|---|
| 5. | 9,0 |
| 10. | 12,0 |
| 25. | 22,0 |
| 50. | 39,0 |
| 75. | 68,2 |
| 90. | 103,1 |
| 95. | 127,3 |
Taj interkvartilni raspon ovdje iznosi 46,2 minuta, od 22,0 do 68,2 minuta. Pomicanje opažanja koje već leži daleko izvan središnje polovine obično ga ne mijenja. Promjena poretka oko kvartila ipak može utjecati na rezultat. Interkvartilni raspon često navodimo uz medijan, a standardnu devijaciju uz sredinu. Druge kombinacije mogu biti korisne ako objasnimo čemu služe.
Oblik raspodjele i položaj opažanja
Graf nam pokazuje i oblik raspodjele. U simetričnoj raspodjeli dvije strane približno su zrcalne i sredina je često blizu medijana. Dugi rep prema većim vrijednostima može povući sredinu naviše. Njihov razmak ipak nije dovoljan opis oblika. Asimetrija uzima u obzir cijelu raspodjelu.
Dugi rep koji smo naslutili iz razmaka sredine i medijana želimo opisati i brojem koji razlikuje dvije strane raspodjele. Zato odstupanja najprije izražavamo u standardnim devijacijama, a zatim ih dižemo na treću potenciju. Neparna potencija čuva njihov predznak. Velika pozitivna odstupanja tako vuku zbroj prema pozitivnome, a velika negativna prema negativnome.
\[ \text{asimetrija} = \frac{1}{n} \sum_{i=1}^{n} \left( \frac{x_i - \bar{x}}{s} \right)^3 \]
Asimetrija simuliranog uzorka iznosi 1,61 i proizlazi iz načina generiranja podataka. Opisuje oblik koji smo zadali simulacijom. Ako u izrazu upotrijebimo četvrtu potenciju, dobivamo koeficijent zaobljenosti (kurtosis). Njegov višak nad referentnom normalnom vrijednošću ovdje je 3,36. On pomaže pri pregledu repova raspodjele, ali ne objašnjava njihov uzrok ni broj krajnjih slučajeva. Ovdje koristimo prosjek trećih odnosno četvrtih potencija odstupanja standardiziranih uzoračkom standardnom devijacijom, bez korekcije za mali uzorak. Od četvrtog momenta oduzimamo tri. Drugi programski postupci mogu koristiti drukčiju korekciju, pa uz usporedbu vrijednosti treba provjeriti i definiciju.
Podsjetnik. Logaritamska skala
Za strogo pozitivne vrijednosti možemo razmotriti logaritamsku ljestvicu. Ona sabija velike vrijednosti i jednake omjere prikazuje jednakim razmacima. Omjeri 20 prema 10 i 120 prema 60 zato imaju isti razmak. Nulu ne možemo logaritmirati. Dodavanje jedinice svim vrijednostima mijenja analizu i traži obrazloženje.
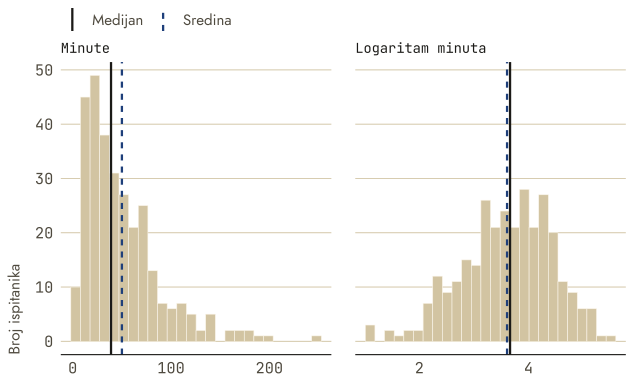
Isti se odgovor sada zapisuje na drugoj ljestvici. Prvih 69 minuta postaje \(\ln(69) = 4,23\). Sve su minute pozitivne, pa transformiramo svih 300 odgovora bez izostavljanja. Svaki transformirani zapis i dalje pripada istom izvornom odgovoru iste osobe.
Nakon logaritmiranja asimetrija iznosi -0,44, a sredina i medijan bliski su, 3,61 i 3,66. Sada, međutim, tumačimo drugu ljestvicu. Eksponenciranjem razlike logaritama dobivamo omjer izvornih vrijednosti. Rezultat stoga tumačimo kao višekratnik izvorne vrijednosti.
Uz oblik raspodjele zanima nas i položaj pojedine osobe u njoj. Dnevnih 100 minuta može biti mnogo u skupini s prosjekom od 15 minuta, a manje neobično u skupini s prosjekom od 80. Da bismo opisali položaj, udaljenost od sredine izražavamo brojem standardnih devijacija.
Definicija 4 Standardizirana vrijednost kaže koliko standardnih devijacija pojedino opažanje leži iznad ili ispod aritmetičke sredine.
\[ z_i = \frac{x_i - \bar{x}}{s} \]
Standardizirana varijabla ima sredinu nula i standardnu devijaciju jedan. Tako možemo usporediti relativni položaj osobe prema vremenu korištenja i prema povjerenju, svako unutar njegove raspodjele. Vrijeme i povjerenje pritom zadržavaju svako svoje značenje. Standardizacija čuva oblik raspodjele i ograničenja ljestvice, pa uz krajnje vrijednosti i dalje gledamo graf.
Moramo navesti i referentnu skupinu. Položaj u cijelom uzorku može se razlikovati od položaja unutar dobne skupine, čak i po predznaku. Za najstariju skupinu sredina iznosi 16,2333 minute, a standardna devijacija 9,4750 minuta. Račun koristi nezaokružene vrijednosti.
| Ispitanik | Minuta | U uzorku | U skupini |
|---|---|---|---|
| I288 | 39 | -0,28 | 2,40 |
| I251 | 37 | -0,33 | 2,19 |
| I280 | 37 | -0,33 | 2,19 |
Osobe iz tablice provode manje vremena od prosjeka cijelog uzorka, a u svojoj su dobnoj skupini među najintenzivnijim korisnicima. Obje tvrdnje mogu biti točne jer koriste različite referentne skupine. U izvještaju zato navodimo prema kojoj je skupini položaj izračunat.
Interakcija — Oblikovanje distribucije
Tri raspodjele prikazuju utjecaj krajnjeg opažanja i raspršenosti ostalih vrijednosti. Usporedba sredine, medijana i mjera raspršenosti pokazuje koje mjere jače reagiraju na pojedinu vrijednost, a koje više ovise o poretku. Za tu smo usporedbu ručno zadali nizove vrijednosti. Svako je opažanje broj u nastavnoj konstrukciji, pa zaključak vrijedi za zadane nizove.
Što isprobati.
- Spustite krajnje opažanje sa 70 na 14 i usporedite sredinu s medijanom.
- Vratite ga na 70 i provjerite koja se mjera središta više pomaknula.
- Postavite krajnje opažanje na 11 pa povećajte faktor raspršenosti i usporedite dvije raspodjele iste sredine.
Uz graf su u tablici navedene vrijednosti za sva tri stanja i njihovi sažeci. Na njima se račun može provjeriti ručno.
| Stanje | Vrijednosti | Sredina | Medijan |
|---|---|---|---|
| Zbijena | 8, 9, 10, 10, 11, 11, 12, 12, 13, 14 | 11,0 | 11,0 |
| Krajnje opažanje | 8, 9, 10, 10, 11, 12, 12, 13, 14, 70 | 16,9 | 11,5 |
| Raširena | 2, 5, 8, 8, 11, 11, 14, 14, 17, 20 | 11,0 | 11,0 |
Prosječan izvor i tipična domena. Urednik iz uvodnog primjera želi opisati koliko se katolička tematika pojavljuje u izvorima koje DigiKat prati. Za naslov razmatra rečenicu da prosječan izvor ima 153 objave. Odluka i predloženi naslov zamišljeni su za ovaj primjer, a tablica domena preuzeta je iz stvarnog izvora.
Sredina tablice iznosi 153,1 objave, dok je medijan 4 (Šikić i sur. 2026.). Razlika proizlazi iz dvaju načina sažimanja iste tablice. Kada bi svaka domena nosila jednak dio svih objava, dobila bi vrijednost sredine. Kada domene poredamo prema broju objava i pogledamo sredinu toga niza, dobivamo medijan. Urednik treba odlučiti koju od tih dviju slika želi prenijeti čitatelju.
Raspored objava objašnjava zašto je odluka važna. Prvih deset domena ima 148 748 od ukupno 551.712 objava, odnosno 26,96 % (Šikić i sur. 2026.). Ako naslov treba približiti tipičnu domenu, sama sredina mogla bi stvoriti dojam da je mnogo objava uobičajeno za većinu izvora. Ako istraživanje zanima gdje se objave koncentriraju, samo medijan ne bi pokazao ulogu najvećih domena.
Urednik zato može uz opis tipične domene prikazati koliko objava nose najveći izvori. Te se informacije dopunjuju. Pritom treba zadržati ograničenje da opisujemo 3.604 imenovane domene uključene prema pravilima DigiKatova korpusa, a ne sve hrvatske medije (Šikić i sur. 2026.). Broj objava također nije broj čitatelja. Iz ovih sažetaka ne zaključujemo koji izvor ima najveći utjecaj ili doseg.
Izbor mjere tako mijenja priču koju ista tablica podržava. Za pitanje o tipičnom izvoru tražimo njegov položaj u raspodjeli. Za pitanje o koncentraciji trebamo pogledati koliko ukupnog broja objava pripada malom dijelu izvora. Za ta dva pitanja biramo različite, jasno imenovane sažetke.
Prije računanja sažetaka trebamo provjeriti što jedan redak predstavlja nakon povezivanja tablica. Sljedeći zapis omogućuje takav pregled.
Prije sažimanja objava po platformi pregledajte zapis spajanja DigiKatovih tablica (Šikić i sur. 2026.). Redak mjesečne tablice predstavlja platformu u mjesecu, a redak godišnje platformu u godini. U mjesečnoj je tablici jedinstvena kombinacija mjesec + platforma. U godišnjoj se ista godina pojavljuje uz više platformi.
Asistent je spojio mjesečnu i godišnju tablicu te priložio provjeru. Zbroj se odnosi na broj objava iz mjesečne tablice.
| Provjera | Prije spajanja | Nakon spajanja |
|---|---|---|
| Broj redaka | 438 | 3 571 |
| Različite kombinacije mjeseca i platforme | 438 | 438 |
| Zbroj objava | 710.307 | 5 959 081 |
Sve početne kombinacije mjeseca i platforme ostale su u rezultatu. Zbroj objava točno odgovara dobivenim redcima. Spoj je zato valjan i tablicu možemo sažeti po platformi.
Odlučite može li tablica u sljedeći korak analize. Pokažite koji podatak podupire vašu odluku, navedite potpuni ključ spajanja i zapišite broj redaka te zbroj objava koje treba dobiti nakon popravka. Zadržite ono što je u asistentovoj provjeri doista točno.
Razrađeni primjer
Na simuliranim minutama vidjeli smo zašto uz sredinu trebamo i druge opise raspodjele. Sada se vraćamo urednikovu pitanju o tipičnom izvoru u DigiKatovu izvatku. Redak predstavlja domenu tijekom cijelog obuhvaćenog razdoblja, a ključ je izvor. Datoteka već sadržava samo internetske domene zapisane malim slovima, bez stranica, kanala i osobnih računa. Najprije provjeravamo jedinstvenost domena i ukupan broj objava, a zatim biramo sažetke za opis ovog korpusa. Doseg procjene određen je uključenim domenama i razdobljem korpusa.
Sljedeći programski račun služi dodatnoj provjeri. Objekt s4_izvori sadržava retke datoteke data/digikat-izvori.csv, a funkcije za sažimanje pripadaju paketu dplyr. Priprema podataka opisana je u mrežnom R praktikumu. Račun i bez pokretanja koda možemo pratiti prema brojčanim provjerama u tekstu.
Prikaži kod
s4_rezultat <- s4_izvori |>
  summarise(
    izvori = n(),
    jedinstveni_izvori = n_distinct(izvor),
    sredina = mean(objave),
    medijan = median(objave),
    prvih_deset = sum(sort(objave, decreasing = TRUE)[1:10]),
    objave = sum(objave)
  )

stopifnot(s4_rezultat$izvori == s4_rezultat$jedinstveni_izvori,
          s4_rezultat$objave == 551712)
Ako se domena ponovi ili zbroj odstupi od 551.712, zaustavljamo račun i provjeravamo razlog. Nakon uspješne provjere možemo sažeti 3.604 različite domene. Sredina i medijan opisuju različite aspekte raspodjele, a udio objava prvih deset domena računamo prema ukupnom broju objava u datoteci.
Šikić, Luka i sur. 2026. „Prikaz i analiza katoličke tematike u digitalnom medijskom prostoru“. Hrvatsko katoličko sveučilište. https://github.com/lusiki/DigiKat/tree/278a127f9170c1aca82035a4a8357b8a995f91d8.
| Provjera | Vrijednost |
|---|---|
| Jedinstvene domene | 3 604 |
| Objave u datoteci | 551 712 |
| Sredina objava po domeni | 153,1 |
| Medijan objava po domeni | 4 |
| Prvih deset domena | 148 748 / 551 712 = 26,96 % |
Sredina je više od 38 puta veća od medijana. To nije formalna mjera asimetrije, ali uz koncentraciju objava u prvih deset domena pokazuje zašto treba pregledati raspodjelu. Prosjek ne predstavlja tipičnu domenu. Doseg i interakcije izostavljamo jer njihove nule u ovoj datoteci ne možemo pouzdano protumačiti.
Rezultat možemo opisati ovako. U DigiKatovu filtriranom korpusu od 3.604 imenovane domene medijan je četiri objave po domeni. Prvih deset domena ima 26,96 % od 551.712 objava. Opis vrijedi za domene uključene prema pravilima korpusa i ne prenosimo ga na ostale hrvatske medije, objave ili publiku.
Sažetak
Sažetak može odgovoriti na naše pitanje tek kada znamo što predstavlja svaki redak, jesu li zapisi ispravno spojeni, kako su označene nedostajuće vrijednosti i koji nazivnik koristimo. Pogrešan spoj može umnožiti zapise, a isključivanje redaka mijenja skup koji opisujemo, pa ni točan račun ne može nadomjestiti te provjere. Na provjerenoj tablici biramo mjere središta i raspršenosti prema obliku raspodjele. Standardizacijom opisujemo relativni položaj opažanja, a transformacijom mijenjamo ljestvicu. Uz odabrane mjere zato zadržavamo jedinicu i obuhvat, kao i ono što se jednim brojem ne može opisati. U poglavlju o vizualizaciji graf će nam pomoći vidjeti upravo te pojedinosti.
Pojmovi
- analitička tablica
- analysis table
- spajanje
- join
- nedostajuća vrijednost
- missing value
- osjetljivost na odluku o podacima
- data-decision sensitivity
- nazivnik
- denominator
- dnevnik transformacija
- transformation log
- poštena rečenica izvještaja
- honest reporting sentence
- aritmetička sredina
- mean
- skraćena sredina
- trimmed mean
- medijan
- median
- mod
- mode
- varijanca
- variance
- standardna devijacija
- standard deviation
- interkvartilni raspon
- interquartile range
- standardizirana vrijednost
- z-score
- asimetrija
- skewness
- zaobljenost
- kurtosis
Zadaci
Nakon vlastitog pokušaja otvorite naznake i provjere rješenja.
Konceptualni
Mjesečna datoteka ima ključ mjesec + platforma, a godišnja godina + platforma. Objasnite zašto spoj samo po godini može zadržati sva popunjena polja, a ipak promijeniti jedinicu retka. Uz pomoć kontrolne tablice objasnite što provjeravaju broj redaka, broj jedinstvenih mjesečnih ključeva i zbroj objava. Zatim navedite koju od te tri provjere nijedna druga ne može zamijeniti.
Računski
Iz tablice zadanih vrijednosti uzmite stanja Zbijena i Krajnje opažanje. Iz svih deset vrijednosti ručno izračunajte sredine i medijane te ih usporedite s posljednjim dvama stupcima. U dvije rečenice objasnite zašto se sredina promijenila više od medijana. Za stanje Zbijena izračunajte i uzoračku standardnu devijaciju, koristeći djelitelj devet. U tablici raspršenosti usporedite promjene SD-a i IQR-a nakon zamjene krajnjeg opažanja. Koja se mjera više promijenila i zašto? Ako je standardizirana vrijednost neke osobe \(z=1,5\), opišite njezin položaj prema sredini bez pretvaranja te vrijednosti u postotak osoba. Zadatak je jednak u digitalnoj i tiskanoj inačici. Interakcija služi samo za dodatne pokuse.
Za drugu provjeru koristimo agregate simulirane ankete, bez dodatnog zaokruživanja. U svakom su retku uz prosjek navedeni brojnik, nazivnik i cjelobrojni zbroj.
| Šifra | Dobna skupina | Broj | Ukupno | Zbroj minuta | Prosjek minuta | Udio |
|---|---|---|---|---|---|---|
| 1 | 18 do 24 | 90 | 300 | 7 339 | 81,5444 | 30 % |
| 2 | 25 do 34 | 84 | 300 | 4 567 | 54,3690 | 28 % |
| 3 | 35 do 44 | 66 | 300 | 2 139 | 32,4091 | 22 % |
| 4 | 45 i više | 60 | 300 | 974 | 16,2333 | 20 % |
Za šifru 1 provjerite 7339 / 90 i 90 / 300. Zatim zbrojite četiri brojnika i četiri zbroja minuta. Ako koristite datoteku data/anketa-mreze.csv, izdvojite šifru 1 i iz tih redaka ponovno izračunajte prvi redak zbirne tablice. Zadatak ne zahtijeva pisanje koda. U tisku su svi potrebni brojnici, nazivnici i provjereni odgovori već u tablici.
Kritički
Urednik objavljuje naslov „Prosječan izvor ima 153 objave”. Na temelju DigiKatova razrađenog primjera napišite tri rečenice. Prva objašnjava što medijan mijenja u čitanju naslova, druga imenuje 551.712 kao nazivnik udjela prvih deset domena, a treća je poštena rečenica s jedinicom, obuhvatom i granicom generalizacije. Ne dodajte tvrdnju o hrvatskim medijima, dosegu ili interakcijama.
Revizija modela
Provjerite modelsku analizu iz okvira. Najprije potvrdite zbroj u tablici koju je model proizveo. Zatim usporedite 3.571 redak s 438 jedinstvenih ključeva i navedite koji dio ključa nedostaje. Napišite ukupan broj objava koji bi dao ispravan spoj. Završite objašnjenjem zašto točan zbroj ne potvrđuje ispravno spajanje.