Vjerojatnost koliko treba
Vjerojatnost povezuje model, ponavljanje i neizvjesnost
Košarkaši i navijači često govore o vrućoj ruci, uvjerenju da nakon nekoliko pogodaka raste vjerojatnost sljedećeg. Jedno je istraživanje provjerilo to vjerovanje kroz zapise utakmica i kontrolirani pokus. Nalazi su protumačeni kao znak da ljudi u slučajnim nizovima vide obrazac koji ne postoji (Gilovich i sur. 1985.).
Prema tom se tumačenju prividni niz uspjeha mogao objasniti slučajnošću (Gilovich i sur. 1985.). Kasnija ponovna analiza, međutim, otkrila je pristranost u samom načinu mjerenja tog obrasca (Miller i Sanjurjo 2018.).
Kako procijeniti je li niz posljedica promjene u procesu ili slučajnosti?
Niz pogodaka može izgledati uvjerljivije od raspršenih uspjeha. Da bismo procijenili taj dojam, trebamo najprije upoznati nizove koje proizvodi proces sa stalnim izgledima za uspjeh. Nakon opisivanja raspodjela i povezanosti trebamo način da odredimo što bismo očekivali pod jasno zadanim uvjetima. Vjerojatnost će nam omogućiti da opaženi rezultat usporedimo s drugim rezultatima koje isti model može proizvesti.
Počet ćemo simuliranim bacanjima novčića. Jedno opažanje bit će ishod bacanja, a nizovi će pokazati kako se udio glava mijenja kada ponavljamo isti postupak. Budući da sami zadajemo izglede, možemo provjeriti koliko kratki niz odstupa od onoga što vrijedi za proces. Jednostavan model služi kao polazište za usporedbu. Tvrdnju o ponašanju košarkaša zatim bismo trebali provjeriti na stvarnim sportskim zapisima.
Za pitanja o preklapanju događaja vratit ćemo se simuliranoj populaciji populacija_medija, koristeći dob osobe i njezin glavni izvor vijesti. Tu možemo prebrojiti koliko osoba zadovoljava jedan uvjet, drugi uvjet ili oba. Tako ćemo provjeriti kada smijemo zbrajati ili množiti vjerojatnosti i zašto poznavanje jednog obilježja može promijeniti izglede za drugo. Populacija medijskih navika stvorena je za nastavu, s jednim retkom za jednu zamišljenu osobu, pa njezini obrasci ne opisuju stvarne stanovnike. U hipotetskoj kampanji e-biltena promatrat ćemo otvaranje poruke kao pokušaj s dvama mogućim ishodima.
Raspodjele koje smo dosad čitali kao opise podataka sada ćemo koristiti i kao modele mogućih ishoda. Binomna raspodjela opisat će broj uspjeha pod određenim pretpostavkama, a normalna krivulja otvoriti pitanje kada je zvonasti oblik opravdan. Uz svaki ćemo račun zadržati uvjete koji ga omogućuju.
Usporedbom izračuna i ponovljenih simulacija iste kampanje utvrdit ćemo koliko je rezultat neobičan pod zadanim modelom. Taj račun treba razlikovati od provjere opisuje li model dobro stvarni svijet.
Što vjerojatnost opisuje
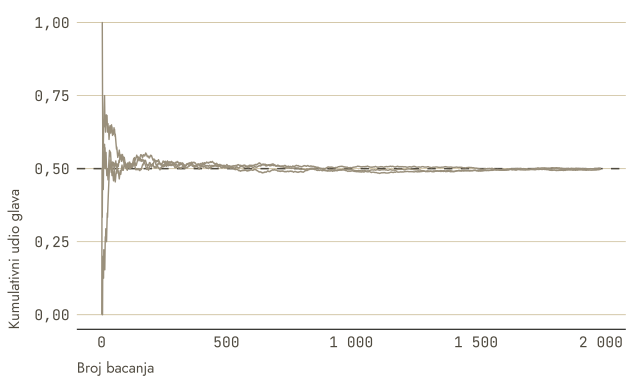
Računalni model svakom bacanju neovisno daje glavu s vjerojatnošću 0,5. U prvom generiranom nizu početnih pet ishoda, s jedinicom za glavu i nulom za pismo, glasi 1, 1, 1, 0, 0. Nakon petog bacanja imamo 3 glava od pet, pa je udio 0,60. Svaka sljedeća točka iste linije dodaje jedno bacanje i ponovno dijeli dotadašnji broj glava brojem svih dotadašnjih bacanja. Cijela linija ima 2 000 takvih koraka.
Simulirat ćemo bacanje poštenog novčića i nakon svakog bacanja zabilježiti udio glava. Ponavljamo postupak triput kako bismo usporedili moguće nizove. Kratki odsječci mogu izgledati neuravnoteženo i uz isti pošten novčić.
Nakon dvadeset bacanja udjeli se kreću od 0,25 do 0,65. Nakon dvije tisuće između 0,498 i 0,502. Nizovi su različiti, ali su u duljim nizovima njihovi udjeli bliži polovini. Sam kratki neuravnotežen niz zato nije dovoljan da novčić proglasimo nepoštenim.
Definicija 1 Vjerojatnost je broj od nule do jedinice koji događaju pridružuje razinu neizvjesnosti unutar jasno opisanoga modela, pri čemu veći broj označuje veće izglede za taj događaj.
Model može opisivati ponovljiv postupak ili jedinstven događaj. Za ponovljiv postupak vjerojatnost uspoređujemo s učestalošću kroz mnogo ponavljanja. Za jedinstven događaj, poput uspjeha reprezentacije na sljedećem prvenstvu, broj opisuje neizvjesnost uz dostupne informacije. U oba slučaja trebamo znati odakle procjena dolazi.
Zakon velikih brojeva opisuje približavanje relativne učestalosti vjerojatnosti kada raste broj neovisnih ponavljanja sa stabilnom vjerojatnošću.
Svako neovisno bacanje zadržava iste izglede. Približavanje udjela polovini objašnjavamo rastom nazivnika. Kako niz raste, početna neravnoteža čini sve manji dio ukupnog broja bacanja. Kasniji ishodi pritom nastaju po istom pravilu kao raniji.
Očekivanje da nakon četiri glave pošten novčić duguje pismo nazivamo kockarskom zabludom. U modelu neovisnih bacanja niz glava ne povećava ni izglede za novu glavu. Kod košarke je pitanje drukčije jer se mogu mijenjati forma, težina šuta, obrana ili odabir pokušaja. Fiksna neovisna vjerojatnost služi nam kao polazni model za usporedbu, bez pretpostavke da potpuno opisuje igru.
Razlikujemo modelnu vjerojatnost, opaženu učestalost i osobnu sigurnost. Modelna vjerojatnost proizlazi iz pretpostavki i informacija. Učestalošću kroz ponavljanja možemo provjeravati model. Za osobno uvjerenje izraženo postotkom tek treba pokazati na čemu se temelji i kako se slaže s ishodima.
Kalibrirana nesigurnost znači da se prognozirani izgledi slažu s učestalostima u mnogo usporedivih prognoza. Među događajima kojima smo pripisali sedamdeset posto izgleda, približno sedamdeset posto trebalo bi se ostvariti. Za pojedinu prognozu navodimo njezine informacije i pretpostavke. Ocjena kalibracije stoga zahtijeva niz usporedivih prognoza i njihovih ishoda.
Tri pravila i jedna pretpostavka
Da bismo iz poznatih vjerojatnosti dobili novu, najprije razjašnjavamo koje ishode ubrajamo u događaj koji nas zanima. Vjerojatnost da se taj događaj ne dogodi dobivamo oduzimanjem njegove vjerojatnosti od jedan. To je pravilo komplementa. Kada povezujemo dva događaja riječju „ili”, njihove vjerojatnosti zbrajamo, ali eventualni preklop oduzimamo kako iste ishode ne bismo prebrojili dvaput. Za zajedničko nastupanje množimo vjerojatnost prvog događaja uvjetnom vjerojatnošću drugog. Tek kada saznanje o prvome ne mijenja izglede drugoga, događaji su neovisni i možemo izravno pomnožiti njihove pojedinačne vjerojatnosti. Na izboru izvora vijesti vidjet ćemo zašto je taj uvjet važan.
Brojnosti u tablici omogućuju da nazivnike provjerimo prije računanja postotaka. Retci razlikuju dob do 29 godina od ostalih, a stupci glavni izvor vijesti u poznatoj simuliranoj populaciji.
| Mreže | Ostalo | Portal | Ukupno | |
|---|---|---|---|---|
| 30 i više | 7 710 | 18 767 | 11 163 | 37 640 |
| Do 29 godina | 5 668 | 2 754 | 3 938 | 12 360 |
| Ukupno | 13 378 | 21 521 | 15 101 | 50 000 |
U simuliranoj populaciji populacija_medija portal bira 30,2 % ljudi, a do dvadeset devet godina ima ih 24,7 %. Zbrajanjem dobivamo 54,9 %. No udio ljudi koji su mladi ili biraju portal jest 47,0 %. Razlika nastaje jer je 7,9 % ljudi istodobno mlado i bira portal, pa smo ih u zbroju računali dvaput.
Za pojednostavnjeno pravilo množenja trebamo opravdati neovisnost.
Definicija 2 Neovisnost dvaju događaja znači da saznanje o tome je li se jedan dogodio ne mijenja vjerojatnost drugoga.
Koristimo potpuno poznatu simuliranu populaciju od pedeset tisuća odraslih osoba. Društvene mreže kao glavni izvor vijesti bira 26,8 %, a do dvadeset devet godina ima 24,7 % ljudi. Uz neovisnost bismo množenjem dobili 6,6 % ljudi koji zadovoljavaju oba uvjeta. U generiranim podacima taj je udio 11,3 %, znatno veći.
Množenje je točno, ali pretpostavka neovisnosti ovdje ne vrijedi. Nju treba opravdati načinom nastanka podataka i dizajnom. Podaci mogu pokazati odstupanje od neovisnosti, dok odsutnost uočljive razlike sama ne potvrđuje pretpostavku. U ovom skupu trebamo razlikovati udio u cijeloj populaciji od udjela unutar određene skupine.
Definicija 3 Uvjetna vjerojatnost je vjerojatnost događaja izračunata unutar skupine u kojoj je neki drugi događaj već nastupio.
Među mlađima od trideset godina mreže bira 45,9 %, a među ostalima 20,5 %. Televiziju bira 21,7 % cijele populacije i 41,2 % onih od šezdeset godina naviše. Ukupne i uvjetne vrijednosti razlikuju se jer su dob i izbor izvora povezani.
Uvjetna vjerojatnost ovisi o smjeru pitanja. Udio upozorenja među ciljanim zapisima računa se s drugim nazivnikom od udjela ciljanih zapisa među upozorenjima. Taj smo problem susreli u poglavlju o zavaravanju brojkama. Za drugi smjer trebamo i temeljnu stopu te stopu pogrešnih upozorenja.
Udio konverzija među ljudima koji su kliknuli oglas ili udio otvaranja među poslanim porukama također su uvjetne vjerojatnosti. Vrijede za skupinu iz svojeg nazivnika. Pri usporedbi segmenata zato svaki put jasno određujemo na koga se udio odnosi.
Ponovljeni pokušaji s dva ishoda
Pravila za pojedine događaje možemo povezati kada se isti pokušaj ponavlja. Često pratimo unaprijed zadan broj pokušaja s dvama ishodima. Zanima nas, primjerice, koliko je ljudi kliknulo, odgovorilo na poziv ili otvorilo poruku. Za takve situacije možemo razmotriti binomni model.
Definicija 4 Binomna raspodjela opisuje broj uspjeha u zadanom broju pokušaja kad svaki pokušaj ima samo dva ishoda, jednaku vjerojatnost uspjeha i nikakvu vezu s ostalim pokušajima.
U hipotetskom modelu promatramo dvadeset objava. Svaka ima zadanu vjerojatnost od dva posto da u sedam dana prijeđe dogovoreni prag dijeljenja. Prag, razdoblje i broj izloženih korisnika dio su definicije viralnosti. Vjerojatnost smo zadali kao pretpostavku modela. Prema binomnom modelu, nijedna objava ne bi prešla prag u 66,8 % takvih zamišljenih mjeseci. Time opisujemo ponavljanja modela, bez jamstva za određeni mjesec.
Za pojedinu objavu izostanak viralnosti ima vjerojatnost \(1-0,02=0,98\). Uz neovisnost dvadeset takvih izostanaka množimo, pa je vjerojatnost nijedne viralne objave \(0,98^{20}\). Za barem jednu koristimo suprotni događaj i računamo \(1-0,98^{20}\), odnosno 33,2 %.
Prije primjene provjeravamo uvjete. Različit doseg objava može značiti različite vjerojatnosti uspjeha. Ako jedno dijeljenje povećava vidljivost sljedeće objave, pokušaji nisu neovisni. Slično, odgovori dviju osoba iz istog kućanstva mogu biti povezani zbog zajedničkih okolnosti, premda ih zapisujemo u zasebne retke.
Kada uvjeti vrijede, očekivani broj uspjeha jednak je broju pokušaja pomnoženom vjerojatnošću uspjeha. S više pokušaja raste raspršenost broja uspjeha, ali sporije od samog broja pokušaja. Udio uspjeha zato postaje stabilniji. Veći raspon ukupnog broja ne znači nužno i nestabilniji udio.
Model pojednostavnjuje proces i jasno određuje što može nastati slučajno. Tako stvarni rezultat imamo s čime usporediti.
Interakcija — Simulator novčića i kampanje
Sada jednu vrijednost dobivamo tek nakon cijeloga niza. Ako u mogućem nizu od 20 pokušaja dobijemo šest uspjeha, u histogram unosimo jedan udio \(6/20 = 0,30\). Taj smo niz odabrali radi ilustracije računa. Za svaki histogram ponavljamo cijele neovisne nizove, a vjerojatnost uspjeha zadržavamo. Visina stupca broji nizove čiji su udjeli u istom rasponu.
Prikaz uspoređuje ishode ponovljenih nizova uz istu zadanu vjerojatnost. Duljina niza mijenja raspon simuliranih udjela. Kratki nizovi daju raspršenije rezultate iako postupak koji ih stvara ostaje isti. U tiskanom prikazu vjerojatnost uspjeha iznosi 0,30, a za svaku duljinu ponavljamo cijeli niz 2 000 puta.
Što isprobati.
- Postavite pošten novčić i dvadeset pokušaja pa opišite raspon simuliranih udjela glava.
- Povećajte niz na dvjesto pokušaja bez promjene vjerojatnosti.
- Prebacite scenarij na kampanju i postavite zadanu stopu uspjeha na trideset posto.
- Usporedite jednu krajnju simuliranu stopu s cijelom raspodjelom ponovljenih kampanja.
Rezultat jedne kampanje uspoređujemo s cijelom raspodjelom koju proizvodi isti postupak. Ako je raspodjela široka, jedan ishod teže razlikuje moguća objašnjenja. Ishod daleko u repu može dovesti model u pitanje, ali ne govori sam što je uzrok odstupanja.
Uži histogram duljih nizova pokazuje promjenu raspršenosti. Za opis njegova oblika vratit ćemo se standardiziranoj ljestvici iz poglavlja o sažimanju podataka. Na njoj nula označuje sredinu, a jedan i minus jedan položaje po jednu standardnu devijaciju iznad i ispod nje. Taj će nam poznati način opisivanja položaja pomoći da raspodjelu usporedimo sa zvonastom krivuljom.
Zvonasta krivulja i njezino područje
Raspodjela mnogih ponovljenih udjela može poprimiti približno simetričan oblik s najviše vrijednosti oko sredine. Taj zvonasti oblik susrećemo u normalnoj raspodjeli.
Definicija 5 Normalna raspodjela je simetrična zvonasta raspodjela koju u cijelosti određuju njezino središte i njezina standardna devijacija.
Na nacrtanoj normalnoj krivulji udaljenost mjerimo standardnim devijacijama. Okomite granice omeđuju srednjih približno 68 %, 95 % i 99,7 % površine. Površina predstavlja udio mogućih vrijednosti, a visina krivulje gustoću.
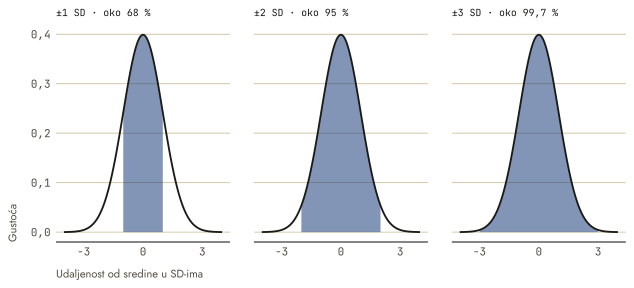
Standardizirana vrijednost određuje položaj na krivulji. Nula je sredina, pozitivan predznak označuje vrijednost iznad nje, a negativan ispod. Apsolutna vrijednost govori koliko je standardnih devijacija udaljena od sredine. Na normalnoj krivulji taj položaj možemo povezati s udjelom površine.
Svaki simulirani udio prosjek je nula za neuspjehe i jedinica za uspjehe u jednom nizu. Histogram stoga prikazuje raspodjelu udjela iz ponovljenih nizova. Jedna vrijednost u njemu sažima cijeli niz pojedinačnih nula i jedinica.
U našoj simulaciji pokušaji slijede isto stabilno pravilo i međusobno su neovisni. S duljim nizovima udjeli se manje rasipaju i njihov se histogram približava zvonastom obliku. Pojedinačni ishodi i dalje ostaju nule ili jedinice. Razlog tom obrascu i uvjete pod kojima vrijedi razradit ćemo u poglavlju o uzorkovanju, uz središnji granični teorem.
Sredina i standardna devijacija potpuno određuju položaj i širinu normalne raspodjele. Unutar jedne standardne devijacije od sredine leži oko 68 % vrijednosti, unutar dvije oko 95 %, a unutar tri oko 99,7 %.
S raspodjele prosjeka sada prelazimo na pojedinačne vrijednosti u istoj populaciji populacija_medija. Njihov oblik trebamo zasebno provjeriti. Pogledat ćemo dnevno vrijeme uz medije i iznos koji je osoba spremna platiti za sadržaj.
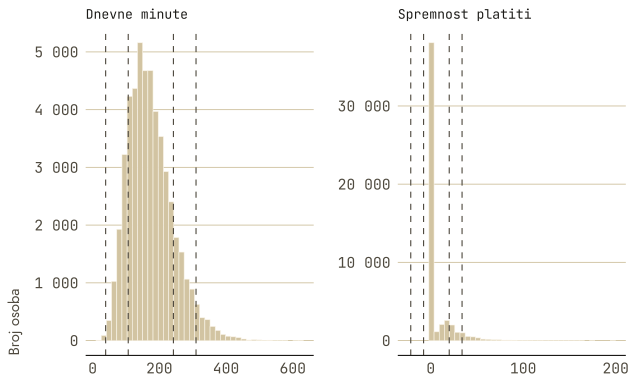
Za dnevne minute unutar jedne standardne devijacije nalazi se 70,1 % populacije, unutar dviju 95,9 %, a unutar triju 99,1 %. Te su vrijednosti blizu normalnom pravilu. Blaga asimetrija udesno stvara manja odstupanja.
Za spremnost na plaćanje odstupanja su mnogo veća. Unutar jedne devijacije nalazi se 87,7 %, a unutar triju 97,6 % populacije. Graf pokazuje da 76,1 % ljudi navodi nulu, uz dugi rep prema velikim iznosima. Jedna devijacija ispod sredine već daje negativan iznos, pa ispod te granice nema opažanja. Normalna raspodjela ne opisuje dobro te sirove vrijednosti.
Promjena ljestvice zahtijeva dva odvojena koraka. Iz istih 50 000 zapisa prvo izdvajamo 11945 pozitivnih iznosa, a zatim na njih primjenjujemo prirodni logaritam. Primjerice, za prvi pozitivan iznos od 55,0 eura nova vrijednost iznosi 4,007. Nule nemaju konačan logaritam i nisu dio toga izračuna. Nazivnik svakoga sljedećeg udjela zato su samo platitelji.
Ako izdvojimo osobe spremne nešto platiti i logaritmiramo njihove iznose, oblik postaje bliži zvonastom. Unutar odgovarajućih raspona sada je 68,0 %, 94,8 % i 99,7 %. Izdvajanjem smo, međutim, promijenili populaciju, a logaritmiranjem ljestvicu. Bolje slaganje s normalnom raspodjelom samo po sebi ne opravdava izostavljanje neplatitelja.
Kad podaci ne pristaju krivulji
Za sljedeći prikaz uzimamo po 1 200 vrijednosti iz svakoga od triju prethodno opisanih skupova. Svaki panel ima zaseban slučajni odabir bez vraćanja, pa se točke ne odnose nužno na iste osobe. Poredak unutar panela omogućuje usporedbu oblika raspodjele.
Postotci unutar raspona mogu sakriti mjesto odstupanja. QQ prikaz zato poreda opažene vrijednosti i usporedi ih s vrijednostima koje bismo na istim položajima očekivali iz normalne raspodjele. Ako se oblici podudaraju, točke prate pravac. Vodoravna os prikazuje kvantile standardne normalne raspodjele, a okomita poredane vrijednosti u jedinicama promatrane varijable. Referentni pravac ovdje prolazi kroz parove prvoga i trećega kvartila. Odstupanja od njega pokazuju gdje oblik podataka odstupa od normalnoga oblika.
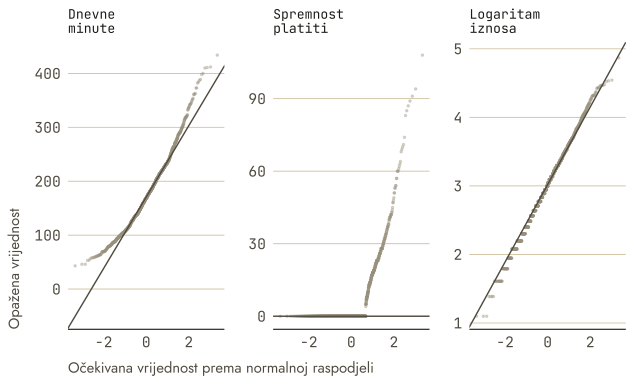
Dnevne minute uglavnom prate pravac, uz odizanje desnog kraja zbog repa prema višim vrijednostima. Za spremnost na plaćanje točke najprije stoje vodoravno zbog nula, a zatim skreću prema gore. Nakon izdvajanja platitelja i logaritmiranja iznosa opet su blizu pravca.
QQ prikaz pokazuje gdje podaci odstupaju od pretpostavke. Prikladnost analize procjenjujemo prema tome koliko su ta odstupanja važna za odabrani postupak. Posljedice blagog odstupanja u repu ovise o ciljnoj veličini, postupku i utjecajnim opažanjima. Velika skupina nula jasno pokazuje da normalna raspodjela nije dobar opis sirovih iznosa.
Poznata vjerojatnost i učenje o nepoznatoj stopi različita su pitanja. Ako smo sami zadali pošten novčić, pet glava ne mijenja sljedeću vjerojatnost 0,5. Ako ne znamo udio uspješnih objava, pet uspjeha postaje informacija za njegovu procjenu. Tada nesigurnost proizlazi i iz toga što pravilo nastanka podataka tek trebamo naučiti.
Nizovi koje slučajnost proizvodi
Usporedbom s normalnom krivuljom provjeravali smo odgovara li model obliku podataka. U pitanju o vrućoj ruci trebamo provjeriti i način na koji iz niza biramo opažanja. Slučajni niz nastaje procesom sa slučajnom sastavnicom i ne mora u kratkom odsječku izgledati pravilno. Za provjeru vruće ruke simuliramo neovisne pokušaje s fiksnom vjerojatnošću pogotka, kao kod poštenog novčića. Ne pretpostavljamo da je stvarna košarka takva. Iz svakog niza izdvajamo pokušaje neposredno nakon triju pogodaka. Želimo vidjeti mijenja li samo to pravilo odabira prosječan udio pogodaka među izdvojenim pokušajima.
Pravilo odabira možemo vidjeti na namjerno složenom nizu 1, 1, 1, 0, 1, 1, 1, 1. Nakon triju jedinica stoje četvrti i osmi pokušaj, s ishodima 0 i 1. Udio na odabranim mjestima zato je \(1/2\), iako u cijelom nizu ima sedam jedinica od osam. Posljednja tri pogotka ne stvaraju dodatno opažanje jer deveti pokušaj ne postoji. U simulaciji umjesto ovoga ilustrativnog niza svaki put generiramo novi niz neovisnih pokušaja s vjerojatnošću 0,5.
Za svaku kombinaciju duljine i uvjeta generiramo 8 000 nizova. Najprije računamo udio odabranih pogodaka unutar svakog niza, a zatim prosjek tih udjela, dajući svakom uključenom nizu jednaku težinu. Niz bez ijednog prikladnog mjesta nema definiran udio i izostavljamo ga iz toga prosjeka. U stupcima „Bez mjesta” prikazujemo koliko je takvih nizova, pa je nazivnik prosjeka 8 000 umanjeno za taj broj.
| Duljina niza pokušaja | Nakon jednog | Bez mjesta nakon jednog | Nakon tri | Bez mjesta nakon tri |
|---|---|---|---|---|
| 20 | 0,476 | 0 | 0,367 | 1846 |
| 50 | 0,490 | 0 | 0,421 | 146 |
| 100 | 0,494 | 0 | 0,459 | 2 |
U nizovima od stotinu pokušaja taj prosječni udio iznosi 0,459, a u nizovima od dvadeset 0,367. Oba su ispod polovine, iako smo simulirali proces bez memorije. Odstupanje stvara odabir mjesta i računanje udjela po konačnim nizovima.
Mehanizam se vidi već u trima bacanjima, kada tražimo ishod nakon jedne jedinice. Od osam jednako vjerojatnih nizova šest ima takvo mjesto. To su 010, 011, 100, 101, 110 i 111. Njihovi udjeli uspjeha na odabranim mjestima redom su 0, 1, 0, 0, 1/2 i 1. Prosjek tih šest udjela iznosi 5/12, približno 0,417. Nizovi s jednim i dvama odabranim mjestima dobivaju jednaku težinu. Takvo pridavanje težina spušta prosjek ispod 1/2 uz stalne izglede pri svakom bacanju. Pristranost je veća u kraćim nizovima i uz dulji uvjet. Nakon samo jednog pogotka u nizovima od stotinu pokušaja prosječni udio je 0,494, blizu polovine.
Za niz od stotinu pokušaja odstupanje je oko četiri postotna boda. Takav je pomak usporediv s razlikom koju bi istraživač mogao tražiti kao dokaz promjene forme. Zato treba provjeriti koliki dio rezultata nastaje samim postupkom mjerenja.
Kada iz podataka odabiremo jedinice prema obilježjima tih istih podataka, pravilo odabira postaje dio analize. Njegov učinak možemo provjeriti na procesu čije je pravilo poznato, ali tada moramo simulirati i odabir jedinica i završni izračun.
Vruća ruka i njezin ispravak. Kada igrač nekoliko puta uzastopno pogodi, suigrač bi mu mogao ponovno dodati loptu jer očekuje nastavak niza. To je moguća odluka kojoj pitanje o vrućoj ruci daje smisao. Zanima nas govori li prethodni uspjeh nešto o sljedećem pokušaju ili promatramo niz kakav može nastati i bez promjene vjerojatnosti pogotka.
Izvorno istraživanje vruće ruke ponudilo je tumačenje da ljudi u nizovima vide promjenu koje nema (Gilovich i sur. 1985.). Za provjeru takve tvrdnje naizgled je dovoljno izdvojiti pokušaje nakon pogodaka i usporediti njihovu uspješnost s uspješnošću pokušaja nakon promašaja. No izdvajanjem mjesta unutar konačnih nizova već smo uveli postupak odabira koji može promijeniti očekivani rezultat.
Kasnija metodološka analiza pokazala je da je uobičajena mjera ovisnosti osjetljiva na tu pristranost odabira. Nakon ispravka, ponovna analiza izvornog kontroliranog pokusa dala je zaključak u prilog vrućoj ruci (Miller i Sanjurjo 2018.). Promijenio se referentni račun s kojim se uspoređuje opaženi niz.
Naša simulacija pokazuje kako postupak odabira i prosječenja proizvodi pomak iako se zadana vjerojatnost ne mijenja. Prije tumačenja stvarnih pokušaja zato treba provjeriti cijeli postupak na procesu čije je pravilo poznato. Tako znamo koliki pomak mogu proizvesti sam odabir i računanje.
Odluka na terenu traži dodatnu prosudbu. Uz moguću promjenu forme treba razmotriti težinu sljedećeg šuta, obranu i raspoložive suigrače. Zato provjeravamo i dojam o vrućoj ruci i mjerni postupak kojim ga pokušavamo osporiti.
Za planiranje kampanje zanima nas barem jedna objava koja prijeđe prag. Provjerimo koje informacije taj račun traži uz vjerojatnost jedne objave.
U nastavnom modelu svakoj objavi zadajemo vjerojatnost od dva posto da u sedam dana prijeđe dogovoreni prag dijeljenja. To je pretpostavka vježbe, a ne izmjeren udio. Urednik pita kolika je vjerojatnost da barem jedna od pet objava iste kampanje prijeđe prag.
U opisu kampanje piše da objave mogu doći do istih pratitelja i da se dijele tijekom istog tjedna. Nema podataka o tome pojavljuju li se njihovi uspjesi zajedno. Asistent je predložio račun komplementom.
p_viral <- 0.02
p_barem_jedna <- 1 - (1 - p_viral)^5
Za jednu objavu vjerojatnost ostanka ispod praga iznosi 0,98. Za svih pet ona iznosi 0,98 na petu potenciju, pa komplement daje približno 9,6 %. Budući da je svaka objava zasebna jedinica, taj broj možemo upotrijebiti kao vjerojatnost uspjeha kampanje.
Napišite uredniku može li broj preuzeti bez dodatnog uvjeta. U odgovoru zadržite valjan račun, imenujte pretpostavku koju traži jedan njegov korak i navedite koju bi informaciju o objavama trebalo pribaviti. Ne morate izračunati novu vjerojatnost ako podaci za nju nisu zadani.
Razrađeni primjer
Zamislimo da je e-bilten poslan na pedeset adresa i otvoren četrnaest puta. Zadajemo hipotetski model s poznatom vjerojatnošću otvaranja od dvadeset dva posto za svaku poruku i neovisnim otvaranjima. Koliko je pod tim modelom vjerojatno četrnaest ili više otvaranja? Rezultat ćemo izračunati binomnom raspodjelom i provjeriti kroz dvadeset tisuća simuliranih kampanja. Primjer nije mjerenje stvarne kampanje. Za traženu vjerojatnost koristimo već poznato pravilo komplementa. Od svih mogućih ishoda izostavit ćemo one s najviše trinaest otvaranja, pa ostaju četrnaest ili više.
Jedna simulirana kampanja sadrži 50 neovisnih odgovora „otvoreno” ili „nije otvoreno”, s istih 22 % izgleda za svaku poruku. Njihov zbroj daje broj otvaranja jedne kampanje. Prvih pet generiranih zbrojeva iznosi 12, 12, 15, 11, 14. Svaki uspoređujemo s 14, a među svih 20 000 kampanja taj prag doseže njih 3862. Dijeljenjem s 20 000 dobit ćemo simuliranu vjerojatnost. Sva ponavljanja imaju definiran rezultat i ulaze u nazivnik.
Poziv pbinom provodi prvi dio tog računa, zbraja vjerojatnosti od nula do trinaest otvaranja. Oduzimanje od jedan ostavlja traženi dio raspodjele. Poziv rbinom zatim simulira kampanje prema istim pretpostavkama. Udio kampanja s najmanje četrnaest otvaranja trebao bi biti blizu izračunatoj vjerojatnosti, pa možemo usporediti računski rezultat s ponavljanjem postupka.
Izračun daje 19,4 %, a simulacija 19,3 %. Razlikuju se malo jer smo simulirali konačan broj kampanja. Podudaranje provjerava račun u zadanom modelu, bez neovisne potvrde modela u stvarnosti.
Četrnaest ili više otvaranja nastalo bi otprilike u jednom od pet ponavljanja. Ishod zato nije posebno neobičan pod modelom, ali to ne potvrđuje sve njegove pretpostavke. Ni mnogo rjeđi ishod sam ne bi dokazao učinak naslova jer bi publika, vrijeme slanja i doseg ostali moguća objašnjenja. Za učinak naslova trebali bismo usporediti nasumično dodijeljene inačice. Za uredničku odluku uz to trebamo cilj i troškove pogreške.
Izračunali smo vjerojatnost ishoda u jednom repu raspodjele pod izričitim modelom.
Sažetak
Vjerojatnost nam omogućuje da opaženi rezultat usporedimo s ishodima koje proizvodi jasno zadan model, a kalibraciju prognoza provjeravamo kroz mnogo usporedivih predviđanja. Prije zbrajanja i množenja određujemo događaje, njihove preklape i uvjete, kao što binomni model traži neovisne binarne pokušaje s jednakom vjerojatnošću. Ponavljanjem vidimo i zašto raspodjela prosjeka pod uvjetima središnjega graničnog teorema može postati približno normalna, iako pojedinačni podaci to nisu. Pravilo o 68, 95 i 99,7 % primjenjujemo na onu raspodjelu koja je doista približno normalna. Simulacija vruće ruke pokazala je da u provjeru treba uključiti i pravilo odabira, jer i ono može promijeniti rezultat. U poglavlju o uzorkovanju istim ćemo ponavljanjem proučiti procjene iz različitih uzoraka.
Pojmovi
- vjerojatnost
- probability
- zakon velikih brojeva
- law of large numbers
- kalibrirana nesigurnost
- calibrated uncertainty
- neovisnost
- independence
- uvjetna vjerojatnost
- conditional probability
- binomna raspodjela
- binomial distribution
- normalna raspodjela
- normal distribution
- QQ prikaz
- Q–Q plot
- slučajni niz
- random sequence
Zadaci
Konceptualni
Usporedite niz od pet glava iz modela poštenoga novčića s poznatom vjerojatnošću i pet uspješnih objava kampanje čija stopa uspjeha nije poznata. Objasnite zašto zadana vjerojatnost sljedećeg bacanja ostaje ista, dok uspjesi mogu promijeniti uvjerenje o nepoznatoj stopi kampanje čak i kada uspjeh jedne objave ne mijenja izglede sljedeće. Odvojeno navedite koji bi dokaz bio potreban za tvrdnju da takva promjena ipak postoji. Na kraju prosudite smije li se pravilo 68–95–99,7 primijeniti na raspodjelu s velikom skupinom nula i navedite što bi u QQ prikazu poduprlo vaš odgovor.
Računski
Vratite se na hipotetsku provjeru zapisa iz poglavlja o tome kako brojke zavode. Od 10 000 zapisa njih 100 stvorio je program. Provjera označuje 90 od tih 100 i pogrešno označuje 495 od preostalih 9 900. Na tvrdnju da je provjera pouzdana jer pronalazi devedeset posto ciljanih zapisa primijenite svih šest revizijskih pitanja. Iz navedenih brojnosti izračunajte udio upozorenja među ciljanim zapisima, udio ciljanih zapisa među svim upozorenjima i temeljnu stopu. Predajte kratku revizijsku tablicu, račun i dvije rečenice o tome što rezultati dopuštaju zaključiti.
Vraćamo se hipotetskom modelu dvadeset neovisnih objava, od kojih svaka ima vjerojatnost uspjeha 0,02. Najprije izračunajte vjerojatnost da nijedna ne uspije, a zatim pravilom komplementa vjerojatnost barem jednoga uspjeha. Navedite zašto isti račun nije opravdan ako uspjeh jedne objave mijenja vjerojatnost uspjeha sljedeće.
Kritički
Prosudite kako je nalaz o vrućoj ruci prešao put od mjerenja do općenite tvrdnje o ljudskoj procjeni slučajnosti, i što se u toj tvrdnji promijenilo nakon ispravka mjere (Gilovich i sur. 1985.; Miller i Sanjurjo 2018.). Predajte jedan odlomak i imenujte rečenicu koju bi popularni prikaz smio zadržati.
Gilovich, Thomas, Robert Vallone, i Amos Tversky. 1985. „The Hot Hand in Basketball: On the Misperception of Random Sequences“. Cognitive Psychology 17 (3): 295–314. https://doi.org/10.1016/0010-0285(85)90010-6.
Miller, Joshua B., i Adam Sanjurjo. 2018. „Surprised by the Hot Hand Fallacy? A Truth in the Law of Small Numbers“. Econometrica 86 (6): 2019–47. https://doi.org/10.3982/ECTA14943.
Revizija modela
Provjerite analizu iz okvira. Izdvojite ispravne računske korake i označite račun koji vrijedi samo uz neovisnost. Zatim izdvojite rečenicu koja neovisnost neopravdano smatra potvrđenom. Napišite zamjenu koja jasno ograničava zaključak.