| Ukupno osoba | Otkriveno | Valjane studije | Izostavljene | Snaga |
|---|---|---|---|---|
| 60 | 68 | 300 | 0 | 22,7 % |
| 100 | 107 | 300 | 0 | 35,7 % |
| 200 | 170 | 300 | 0 | 56,7 % |
| 300 | 239 | 300 | 0 | 79,7 % |
| 500 | 281 | 300 | 0 | 93,7 % |
| 800 | 299 | 300 | 0 | 99,7 % |
Veličina učinka i snaga
Koliki je učinak i koliko ga pouzdano vidimo
Otvaramo društvenu mrežu i uz poziv na izbore ugledamo lica prijatelja koji su označili da su već glasovali. Možda smo ionako namjeravali izaći, a možda nas baš taj podsjetnik pokrene. Kako bismo prepoznali njegov doprinos među svim razlozima zbog kojih ljudi odlaze na biralište?
U velikom pokusu tijekom američkih izbora istraživači su nasumično dodjeljivali različite poruke korisnicima mreže (Bond i sur. 2012.). Neke su prikazivale fotografije prijatelja koji su označili da su glasovali, a druge istu poruku bez tih fotografija (Bond i sur. 2012.). Glasovanje su mogli provjeriti u biračkim evidencijama samo za upareni podskup korisnika (Bond i sur. 2012.).
Za odluku o takvoj poruci trebamo procijeniti veličinu učinka i što bi on značio pri širokoj primjeni, uz granice skupine za koju je ishod provjeren. Koliki bi pomak bio sadržajno važan i koliko podataka trebamo da bismo ga pouzdano uočili?
Pri planiranju istraživanja polazimo od razlike koju bi vrijedilo uočiti. Zatim provjeravamo možemo li je planiranim postupkom dovoljno pouzdano razlikovati od slučajne promjenjivosti. Time pitanje iz prethodnog poglavlja okrećemo prema planiranju. Umjesto da tek nakon analize čitamo rezultat testa, unaprijed provjeravamo kakav bi nam odgovor istraživanje moglo dati.
Razliku u povjerenju čitatelja tiska i portala već smo procijenili s intervalom. Sada nas zanima njezina veličina i koliko je često uzorak može uočiti. Za poznatu referencu služe svi čitatelji tiska i portala u populaciji populacija_medija, umjesto prethodnog uzorka od 300 čitatelja tiska i portala.
Svaki redak predstavlja jednu zamišljenu osobu s izvorom vijesti i povjerenjem na ljestvici od jedan do deset. Podaci su stvoreni za nastavu i ne opisuju stvarne stanovnike. Poznatu razliku uspoređujemo s rezultatima ponovljenih izvlačenja kako bismo prebrojili koliko je često postupak uočava.
Razliku najprije izražavamo u bodovima povjerenja, a zatim je uspoređujemo s raspršenošću odgovora i opisujemo Cohenovim d. Sredina i standardna devijacija iz opisne statistike tako zajedno daju standardiziranu veličinu učinka. Važnost pomaka ipak trebamo obrazložiti sadržajem pitanja i mogućim posljedicama odluke. Vrlo malen pomak može postati statistički značajan uz dovoljno opažanja, što ćemo provjeriti simulacijom dviju naslovnica.
Snagu ćemo proučavati mijenjanjem učinka, veličine uzorka, raspršenosti i praga odluke. Provjerit ćemo i što se događa kada iz malih istraživanja zadržimo samo značajne rezultate.
Planirati možemo i unatrag, od razlike na koju bi zamišljeno uredništvo reagiralo prema potrebnom broju osoba. Drugi je mogući cilj prihvatljiva širina intervala. Usporedba tih ciljeva pomaže nam obrazložiti što od uzorka očekujemo prije nego što vidimo nalaz i prepoznati kada je nesigurnost prevelika za namjeravanu odluku.
Razlika koja nešto znači
Veličina učinka brojčano opisuje razmjer razlike ili odnosa. Možemo je izraziti u izvornim jedinicama, kao razliku bodova, ili bez njih, kao standardiziranu razliku, korelaciju ili omjer. Njezinu sadržajnu važnost procjenjujemo prema istraživačkom pitanju i posljedicama odluke.
Povjerenje u medije bilježimo bodovima na ljestvici, pa razliku među čitateljima tiska i portala prvo čitamo u tim jedinicama.
Za ovu referencu služe svi čitatelji tiska i portala u populaciji, ukupno 19956 osoba. Zbroj ocjena među 4855 čitatelja tiska iznosi 26791, a među 15101 korisnika portala 72101. Dijeljenjem svakog zbroja njegovim brojem osoba dobivamo sredine 5,518 i 4,775, pa ih možemo oduzeti.
Razlika iznosi 0,74 boda na ljestvici od jedan do deset. Navodimo je u izvornim jedinicama kako bismo je mogli povezati s odlukom. Uredništvu koje razmatra preraspodjelu sadržaja nije svejedno razlikuju li se skupine za tri četvrtine boda ili za tri boda.
Razliku možemo usporediti i s raspršenošću odgovora. Jedan bod izgleda drukčije kada su odgovori zbijeni oko sredine nego kada zauzimaju cijelu ljestvicu. Standardizirana mjera izražava taj odnos.
Definicija 1 Standardizirana razlika je razlika dviju sredina podijeljena združenom standardnom devijacijom skupina, pa se izražava u standardnim devijacijama umjesto u izvornim jedinicama.
\[d = \frac{\bar{x}_2 - \bar{x}_1}{s_{\text{zdr}}}\]
Oznakom \(s_{\text{zdr}}\) označavamo združenu standardnu devijaciju, zajedničku mjeru raspršenosti unutar dviju skupina.
Za zajedničku raspršenost povezujemo dvije varijance. Svaka dobiva težinu jednaku broju osoba u skupini umanjenom za jedan, pa veća skupina više pridonosi. Tek nakon toga vadimo korijen. Skupina 1 ovdje je portal, a skupina 2 tisak. Brojeve osoba označavamo s \(n_1\) i \(n_2\), a standardne devijacije s \(s_1\) i \(s_2\). Za dva uzorka račun glasi
\[s_{\mathrm{zdr}}=\sqrt{\frac{(n_1-1)s_1^2+(n_2-1)s_2^2}{n_1+n_2-2}}.\]
U ovom primjeru račun obavljamo na cijeloj poznatoj sintetičkoj populaciji. Zato dobivena razlika i njezina standardizacija opisuju te zapise bez uzoračke nesigurnosti. Uzoračka procjena iste veličine zahtijevala bi i interval. U brojnik ulazi \((15101-1)\times 3,641 + (4855-1)\times 3,705\), a nazivnik je 19954. Račun koristi nezaokružene varijance.
Združena standardna devijacija u ovoj populaciji iznosi 1,91 boda. Razlika od 0,74 boda zato daje standardiziranu razliku od 0,39. Skupine dijeli nešto više od trećine standardne devijacije, a njihove se raspodjele velikim dijelom preklapaju. Ista ocjena povjerenja može pripadati korisnicima obaju izvora, pa ona sama ne određuje izvor vijesti pojedine osobe.
Preklapanje raspodjela možemo približiti i pitanjem o nasumično izabranom paru osoba. Čitatelj tiska ima strogo više povjerenja od čitatelja portala u 53,6 % parova, dok je 13,9 % parova izjednačeno. Kada polovicu izjednačenja pripišemo svakoj strani, prilagođena vjerojatnost nadmoći iznosi 60,6 %. Za jednake raspodjele iznosila bi pedeset posto. Razliku među skupinama tako opisujemo usporedbom ljudi, što može biti razumljivo i čitatelju koji ne poznaje standardnu devijaciju.
Sadržajnu važnost učinka procjenjujemo prema ranijim nalazima iz istog područja i posljedicama odluke. Standardizacija olakšava usporedbu različitih ljestvica, a prosudba važnosti ostaje vezana uz sadržaj istraživanja.
Kad je značajno, a nije važno
Rezultat nazivamo statistički značajnim kada njegova p-vrijednost ne prelazi unaprijed odabrani prag odluke. Uz statističku značajnost navodimo i procjenu veličine učinka kako bismo opisali razmjer razlike. To se posebno jasno vidi na vrlo velikom uzorku.
Zamislimo pokus u kojem portal uspoređuje dvije naslovnice. Stvarna stopa klika prve iznosi 2,00 %, a druge 2,05 %. Svaku prikazuje pola milijuna puta. Podatke u nastavku simuliramo za tu zamišljenu usporedbu.
Jedno opažanje predstavlja jedan hipotetski prikaz naslovnice i njegov ishod, klik ili izostanak klika. Pretpostavljamo neovisne prikaze s istom vjerojatnošću unutar naslovnice. Račun generira zbroj klikova u svakoj od dviju skupina od 500 000 prikaza. Za prvu dobivamo 9879 klikova, a za drugu 10382. Dijeljenjem svakog broja s 500 000 nastaju stope koje uspoređujemo. Ovo je jedan simulirani pokus, ne procjena snage preko ponovljenih pokusa.
Prikazani 95-postotni interval i p-vrijednost koriste normalni Waldov račun za razliku dvaju neovisnih udjela, s procijenjenim varijancama obiju skupina. Ostvarena razlika veća je od zadane razlike od 0,05 postotnih bodova. To je slučajno precjenjivanje u ovome pokusu, a ne promjena poznatoga učinka. Značajnost ovog jednog rezultata ne mjeri snagu nacrta.
Uz zadane stope i broj prikaza normalno približenje daje snagu od oko 43 %. Otkrivanje stvarnoga pomaka zato je u ovom nacrtu rjeđe od njegova propuštanja.
U simulaciji prva naslovnica postiže 1,976 %, a druga 2,076 % klikova. Procijenjena razlika iznosi 0,101 postotnog boda, uz interval od 0,045 do 0,156. P-vrijednost iznosi 0,00036. Pod nultim modelom ovako velika ili veća odstupanja bila bi vrlo rijetka.
Dobivena razlika znači otprilike jedan dodatni klik na tisuću prikaza. Opravdava li promjenu naslovnice, ovisi o trošku promjene i vrijednosti klika. Trošak i vrijednost klika trebamo utvrditi iz dodatnih izvora. Velik uzorak omogućio nam je razlikovati mali pomak od nule, a te će informacije pomoći u obrazlaganju odluke.
U malom uzorku možemo propustiti i razliku koja bi bila važna za uredničku odluku. Izostanak značajnosti zato ne dokazuje da je učinak nevažan. Procjenu i interval izvještavamo prije testa kako bi čitatelj mogao razmotriti i veličinu i nesigurnost rezultata.
Poruka s fotografijama prijatelja iz početnog pokusa pokazuje zašto i malen pomak zaslužuje sadržajno tumačenje. Među korisnicima čije je glasovanje provjereno u evidenciji procijenjena razlika prema poruci bez fotografija iznosila je 0,39 postotnog boda, uz standardnu pogrešku 0,17 postotnog boda (Bond i sur. 2012.). Normalnim približenjem \(0,39 \pm 1,96 \times 0,17\) iz tih objavljenih vrijednosti dobivamo približan 95-postotni interval od 0,06 do 0,72 postotnog boda (Bond i sur. 2012.). Procjena je mala za pojedinca, a njezina nesigurnost ostaje važna i uz vrlo mnogo korisnika.
Bond, Robert M., Christopher J. Fariss, Jason J. Jones, i sur. 2012. „A 61-million-person experiment in social influence and political mobilization“. Nature 489 (7415): 295–98. https://doi.org/10.1038/nature11421.
U zamišljenoj primjeni na milijun usporedivih ljudi pomak od 0,39 postotnog boda odgovarao bi približno 3.900 dodatnih izlazaka. To je ilustracija razmjera, uz pretpostavku da se učinak može prenijeti na tu skupinu. Za stvarnu odluku trebalo bi provjeriti taj prijenos, trošak poruke i prihvatljivost korištenja prijateljskih veza za poticanje ponašanja. U samom su pokusu istraživači zasebno proučavali i širenje učinka kroz mrežu prijatelja (Bond i sur. 2012.). Jednostavno množenje izravnog učinka zato još ne daje ukupan društveni učinak.
Snaga kao svojstvo plana
Prije prikupljanja podataka možemo procijeniti koliko bi često naš plan otkrio zadani učinak. Za to trebamo odrediti postupak, veličinu učinka, uzorak, raspršenost i prag odluke.
Ako nakon istraživanja opaženi učinak proglasimo stvarnim i iz njega izračunamo snagu, račun je kružan. Uz isti uzorak i prag takva snaga prati već opaženu testnu statistiku i ne daje neovisnu provjeru je li dizajn mogao otkriti unaprijed važan učinak.
Definicija 2 Statistička snaga je vjerojatnost da postupak odbaci nultu hipotezu kad je ona lažna, dakle udio ponavljanja u kojima bi učinak zadane veličine bio otkriven.
U prethodnom poglavlju postupak je otkrio stvarnu razliku u otprilike četiri od pet uzoraka od tristo osoba. Taj udio procjenjuje snagu. Sada ćemo ga usporediti za nekoliko veličina uzorka.
Zadržavamo permutacijski test iz prethodnog poglavlja. Nulti model pretpostavlja jednaku cijelu raspodjelu povjerenja u objema skupinama, pa su oznake zamjenjive u odnosu na ishod. Statistika je apsolutna razlika sredina, a osobe smatramo neovisnim jedinicama. Iz podskupa koji čine svi čitatelji tiska i portala u populaciji izvlačimo uzorke bez vraćanja. Za svaku veličinu provodimo tristo zamišljenih studija. U svakoj koristimo dvjesto nasumičnih premještanja i korekciju \((b + 1)/(B + 1)\), gdje je \(B\) broj premještanja, a \(b\) broj barem toliko ekstremnih rezultata kao opaženi. Krivulja procjenjuje snagu za taj postupak i način nastanka podataka.
Veličina uzorka u ovoj tablici jest ukupan broj osoba iz obiju skupina, čije brojnosti nisu unaprijed izjednačene. Kasniji plan s jednakim skupinama navodi broj po skupini. Uz 200 permutacija moguće p-vrijednosti razlikuju se za 1/201, približno 0,005. Odluka neposredno uz prag zato može ovisiti o slučajnom izboru premještanja.
U svakom retku brojimo studije s p-vrijednošću koja ne prelazi 0,05 i dijelimo brojem valjanih studija. Ako bi uzorak sadržavao samo jednu skupinu, test ne bi bio definiran i studiju bismo isključili, uz prikazan broj isključenja. U ovoj izvedbi takvih studija ima 0. Tristo ponavljanja daje razmjerno grubu procjenu snage. Oko snage od 80 % simulacijska standardna pogreška iznosi približno 2,3 postotna boda.
Kada povećamo uzorak sa šezdeset na tristo osoba, procijenjena snaga raste s 22,7 % na 79,7 %. Rast se postupno usporava kako se približavamo gornjoj granici. Sa šezdeset osoba ovaj bi postupak propustio stvarnu razliku u približno tri od četiri studije.
Snaga raste s većim učinkom i većim uzorkom. Pomažu i manja raspršenost ishoda te blaži prag odluke. Istraživač može planirati uzorak i prag, a nacrtom i kvalitetom mjerenja utjecati na raspršenost. Veličina stvarnog učinka ostaje nepoznata, pa snagu treba razmotriti za više mogućih veličina.
Često se planira snaga od 80 %, ali taj izbor treba opravdati (Cohen 1988.). Ako bi propuštena razlika imala ozbiljne posljedice, možda trebamo višu snagu. Istraživanje izvedivosti može imati drukčiji cilj i zahtjeve.
Cohen, Jacob. 1988. Statistical Power Analysis for the Behavioral Sciences. 2. izd. Lawrence Erlbaum Associates.
Odabir značajnih nalaza pri niskoj snazi
Slaba snaga povećava broj propuštenih učinaka. Može utjecati i na veličinu procjena koje objavljujemo ako zadržavamo samo značajne rezultate. To možemo provjeriti u simulaciji s poznatom populacijom.
Za sljedeću usporedbu ponovno izvlačimo uzorke iz istoga podskupa tiska i portala, svaki put po 60 osoba. Svaka studija daje jednu procjenu razlike i jednu permutacijsku p-vrijednost. Tablica donosi prvih pet valjanih studija u redoslijedu generiranja. Oznaka u posljednjem stupcu pokazuje bi li studija bila objavljena kada bismo zadržali samo rezultate ispod 0,05.
| Studija | Razlika | p | Zadržana |
|---|---|---|---|
| 1 | 0,098 | 0,9254 | ne |
| 2 | 1,104 | 0,1095 | ne |
| 3 | 1,444 | 0,0498 | da |
| 4 | 1,140 | 0,0498 | da |
| 5 | 0,085 | 0,9104 | ne |
Prva procjena iznosi 0,098 boda i ulazi u prosjek svih studija. U prosjek odabranih ulazi samo ako zadovolji prag. Od 3 000 pokušaja neprimjenjivo je 0, pa prosjek svih računamo na 3000 valjanih studija, a prosjek značajnih na 678. Isti manji nazivnik koristimo za udio značajnih procjena s pogrešnim predznakom. Kod zasebnih 1 000 studija s po 500 osoba izostavljeno je 0, a prag prolazi 961 studija.
Proveli smo tri tisuće zamišljenih studija sa šezdeset osoba. Prosjek svih procjena iznosi 0,74 boda, blizu stvarne razlike od 0,74. Prije odabira prema pragu procjene u ovoj simulaciji ne pokazuju pristranost.
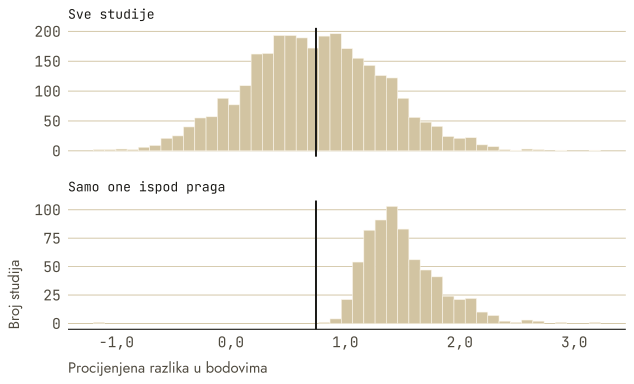
Donji panel zadržava samo rezultate koji su prešli prag značajnosti. Njihov prosjek iznosi 1,50 boda, odnosno 2,0 puta onoliko koliko iznosi stvarna razlika. U malom uzorku prag najčešće prelaze procjene koje je slučajnost povećala. Najmanja apsolutna vrijednost značajne procjene u ovoj simulaciji iznosi 0,84 boda. Sam odabir rezultata prema pragu može stvoriti to iskrivljenje, čak i kada istraživač postupa u dobroj vjeri.
Među 678 značajnih procjena njih 1 ima suprotan predznak od stvarne razlike. Račun može biti točan, a pojedinačni zaključak o smjeru učinka pogrešan.
S pet stotina osoba značajne procjene premašuju stvarnu razliku za faktor 1,03, pa je iskrivljenje mnogo manje. Ti brojevi vrijede za ovu populaciju, uzorke, postupak i prag. Ne možemo ih prenijeti na svaki nalaz iz maloga uzorka.
Pri čitanju rada zato provjeravamo širinu intervala, način odabira rezultata i odnos prema ranijim dokazima. Velik učinak uz p-vrijednost blizu praga sam po sebi ne dokazuje precjenjivanje. Sličan rezultat iz neovisne replikacije daje dodatni razlog za povjerenje u procjenu. Niska snaga upozorava na nesigurnost i moguću selekciju nalaza.
Planiranje unatrag
Veličinu uzorka planiramo prema pitanju koje želimo riješiti. Najprije trebamo odrediti kolika bi razlika bila dovoljna da promijeni postupanje.
Definicija 3 Najmanji važan učinak je najmanja razlika koja bi promijenila zaključak, odluku ili postupanje, određena sadržajno i prije prikupljanja podataka.
Tu granicu obrazlažemo troškovima odluke, ozbiljnošću ishoda i ranijim nalazima iz područja. Tako obrazložena granica postaje ulaz u račun potrebnog broja opažanja za željenu snagu.
Polazimo od važne razlike i željene snage, pa računamo potreban broj jedinica. Zatim provjeravamo je li takav uzorak izvediv. Ako nije, ograničenje znamo prije prikupljanja podataka i možemo prilagoditi plan ili doseg istraživanja.
Veličinu uzorka možemo odrediti i vraćanjem na pitanje iz poglavlja o procjeni. Koliko uzak interval trebamo da bi procjena bila korisna? Uz raspršenost iz ove populacije interval razlike širok je 1,06 boda pri stotinu osoba po skupini, 0,61 pri tristo i 0,37 pri osamsto. Margina je polovica ukupne širine, pa za marginu do pola boda tražimo širinu do jednoga boda. Ulazi u taj plan jesu željena širina intervala, razina pouzdanosti i pretpostavljena raspršenost.
Uz iste pretpostavke kao u završnom planu, poznatu standardnu devijaciju 1,9 i dvije jednake neovisne skupine, margina do 0,5 traži \(n\geq 2(1,96\times1,9/0,5)^2\), odnosno 111 osoba po skupini. Za otkrivanje razlike od 0,5 uz snagu oko 80 % normalno približenje daje \(n\approx2[(1,96+0,842)1,9/0,5]^2\), približno 227 osoba po skupini. Broj 0,842 jest kvantil standardne normalne raspodjele ispod kojega leži 80 % površine. U ovoj približnoj planskoj formuli odgovara ciljanoj snazi od 80 %, dok 1,96 dolazi iz obostranoga testa na razini 5 %. Ta dva plana odgovaraju na različita pitanja pod jednakim pretpostavkama.
Planiranje prema snazi zahtijeva pretpostavljeni učinak, koji još ne znamo. U ovom modelu planiranje prema preciznosti polazi od razine pouzdanosti, pretpostavljene raspršenosti i prihvatljive širine intervala. Cilj je dovoljno precizna procjena, bez obzira na to gdje će se nalaziti. Ostvarena preciznost ipak ovisi o tome koliko su planske pretpostavke odgovarale podacima.
Interakcija — Istraživač snage
Dosad smo mijenjali veličinu uzorka iz populacije sa zadanom razlikom. Sada želimo vidjeti i što se događa kada pretpostavimo manji ili veći učinak. Zato prelazimo na jednostavan model u kojem učinak možemo mijenjati, a raspršenost zadržati jednakom. Krivulje prikazuju snagu za različite uzorke i zadane učinke. Za isti učinak veći uzorak povećava vjerojatnost otkrivanja, dok je uz isti uzorak manji učinak teže otkriti.
Jedna točka krivulje sažima zamišljene studije za zadani učinak i broj osoba po skupini. Digitalni prikaz počinje s 1 500 ponavljanja po točki, učinkom 0,35 i odabranim uzorkom od po 80 osoba. Sve te postavke možemo mijenjati. Tiskani prikaz koristi 2 000 ponavljanja po točki i učinke 0,2, 0,4 i 0,6. Primjerice, za razliku 0,4 i po 100 osoba standardna je pogreška razlike \(\sqrt{2/100}\) kada je poznata standardna devijacija ishoda jedan. Svaka studija daje razliku podijeljenu tom pogreškom. Broj rezultata kojima je apsolutna vrijednost iznad 1,96 dijelimo s brojem ponavljanja za tu točku. Svi rezultati ulaze u nazivnik. Krivulja ne broji pojedinačne osobe, a njezina mala kolebanja potječu od simulacije.
Prikaz pretpostavlja dvije neovisne skupine jednake veličine, neovisne normalne ishode i zajedničku poznatu standardnu devijaciju. Nulta hipoteza zadaje standardiziranu razliku nula. Obostrani test koristi apsolutnu z-vrijednost. Za svaku točku simuliramo z-vrijednosti iz odgovarajuće normalne raspodjele. Više ponavljanja daje manju simulacijsku nesigurnost procjene snage.
Što isprobati.
- Zadržite učinak jednakim i povećavajte uzorak.
- Zadržite uzorak jednakim i smanjujte učinak.
- Spustite prag odluke i provjerite koliko je jedinica potrebno za istu snagu.
- Postavite standardiziranu razliku na 0,10 i pokušajte dosegnuti 80 %.
Za najmanju prikazanu standardiziranu razliku, 0,2, tristo jedinica po skupini još ne daje snagu od 80 %. Trebao bi veći uzorak. Zato pri planiranju moramo jasno reći koju veličinu učinka želimo moći otkriti.
Velik objavljeni učinak i plan male studije. Za novi istraživački projekt privlačno je uzeti učinak iz prethodnog rada i prema njemu odrediti potreban broj sudionika. Ako je objavljena razlika velika, plan može izgledati izvedivo i uz skroman uzorak. No prije nego što tu brojku pretvorimo u obećanje budućeg istraživanja, trebamo razmotriti kako je dospjela u literaturu.
Analiza istraživanja u neuroznanosti pokazala je i drugu posljedicu niske snage. Uz propuštanje postojećih učinaka, mala istraživanja mogu ostaviti i pretjeran dojam o njihovoj veličini ako se nalazi odabiru za objavu prema značajnosti (Button i sur. 2013.). U takvom izboru lakše prolaze rezultati koji su, uz postojeći učinak, dobili i povoljan slučajni pomak.
Zamislimo tim koji na temelju jednoga takvog nalaza planira ponavljanje. Ako precijenjenu razliku prihvati kao realan cilj, mogao bi odabrati uzorak koji ima premalu snagu za skromniji, ali sadržajno važan učinak. Tada neodlučan rezultat ne bi jasno razlikovao izostanak učinka od nedostatka informacija. Velik broj u prvom radu tako može dovesti do premalog plana u drugome. Zamišljeni tim ilustrira moguću posljedicu takvog planiranja.
Odgovor je pregledati interval iz prethodnog istraživanja, neovisna ponavljanja i širi skup dostupnih nalaza. Uz njih tim treba odrediti najmanju razliku koja bi promijenila njegov sadržajni zaključak te ispitati koliko sudionika treba za nekoliko uvjerljivih veličina učinka. Ako izvediv uzorak ne može dovoljno precizno odgovoriti na pitanje, korisno je to znati prije prikupljanja.
Naša simulacija pokazala je mehanizam odabira, ali njezin faktor precjenjivanja vrijedi za zadanu populaciju i postupak. Ne možemo njime korigirati sve objavljene radove. Za planiranje je korisnija promjena polaznog pitanja. Umjesto da pitamo koliko je ljudi dovoljno za objavljenu brojku, pitamo kakav nam je uzorak potreban da razlučimo mogućnosti koje su važne za naše istraživanje.
Pregledavate završni izvještaj male studije. Za ovu je vježbu konstruiran nalaz standardizirane razlike od 0,78 uz trideset osoba po skupini. Prije prikupljanja tim je kao najmanju važnu razliku odredio 0,5 boda i za planiranje pretpostavio standardnu devijaciju od 1,9 boda. Te su vrijednosti pretpostavke nastavnog primjera, a ne objavljen nalaz.
Asistent je nakon uvida u rezultat izračunao sljedeće.
d_opazeni <- 0.78
power.t.test(n = 30, delta = d_opazeni, sd = 1,
             sig.level = 0.05, type = "two.sample")
Za zadane ulaze poziv vraća snagu približno 0,84. Uz ispis stoji obrazloženje.
Opaženu standardiziranu razliku unijeli smo kao
delta, a standardnu devijaciju postavili na jedan jer računamo na standardiziranoj skali. Dobivena snaga veća je od 0,80, pa potvrđuje da je završena studija bila dovoljno velika za naše pitanje.
Sastavite odgovor timu. Objasnite što račun od 0,84 vrijedi uz zadane ulaze, a što iz njega ne slijedi. Predložite vrijednost učinka za planiranje nove studije na temelju prethodno određenog cilja i navedite koji biste podatak iz završene analize još tražili za prosudbu preciznosti.
Razrađeni primjer
Planiranje unatrag sada možemo provesti za konkretnu uredničku odluku. Pretpostavimo da bi uredništvo reagiralo na razliku od pola boda, uz očekivanu raspršenost sličnu onoj u našoj populaciji. Ta je granica pretpostavka primjera koju bi u stvarnom istraživanju trebalo opravdati. Za nekoliko veličina uzorka procijenit ćemo koliko bi često simulirana studija otkrila zadanu razliku.
Nulta hipoteza zadaje razliku sredina nula, a testna statistika dijeli opaženu razliku poznatom standardnom pogreškom. Pretpostavljamo dvije neovisne skupine, neovisne normalne ishode i jednaku poznatu standardnu devijaciju od 1,9 boda. Koristimo obostrani z-test s pragom 0,05. Za svaku veličinu uzorka simuliramo dvije tisuće parova skupina. Dobivena snaga vrijedi za te uvjete i zadanu razliku od pola boda.
Prva studija s po 100 opažanja počinje vrijednostima -0,45, 1,11, -1,65 u prvoj skupini i 2,36, -0,49, -2,33 u drugoj. To su generirani ishodi na centriranoj, neograničenoj normalnoj ljestvici, pa nisu doslovne ocjene od jedan do deset. Iz svih 100 vrijednosti po skupini dobivamo sredine 0,027 i 0,309. Njihovu razliku dijelimo s \(1,9\sqrt{2/100}\) i uspoređujemo apsolutni rezultat s 1,96. Svako novo ponavljanje generira svih 200 ishoda iznova. Broj otkrivenih razlika dijelimo s 2 000, bez isključenih studija.
Za svaku ponuđenu veličinu uzorka ponavljamo studiju dvije tisuće puta. Granica 1,96 dolazi iz standardne normalne raspodjele. Pripada ovom obostranom z-testu, a ne permutacijskom testu iz prvog prikaza snage.
| Jedinica po skupini | Otkrivanja od 2 000 | Snaga |
|---|---|---|
| 100 | 934 | 46,7 % |
| 150 | 1226 | 61,3 % |
| 200 | 1533 | 76,6 % |
| 250 | 1663 | 83,2 % |
Za snagu od približno 80 % pri razlici od pola boda potrebno je između dvjesto i dvjesto pedeset osoba po skupini. Ako je izvedivo samo stotinu, istraživanje možemo provesti uz jasno ograničenje. Pod planskim pretpostavkama propustilo bi takvu razliku u više od polovice ponavljanja.
Račun povezuje planirani uzorak s učinkom koji želimo otkriti. Granicu od pola boda trebamo opravdati sadržajno, a očekivanu raspršenost ranijim mjerenjima. Simulacija ovdje ne uključuje odustajanje ispitanika ni probleme mjerenja, pa i njih treba razmotriti pri konačnom planiranju.
Sažetak
Da bismo planirali istraživanje, trebamo odrediti koliku bi razliku vrijedilo uočiti, jer statistička značajnost sama ne govori je li ona važna. Standardizacija pomaže usporediti veličine učinka na različitim ljestvicama, a njihovo sadržajno značenje prosuđujemo zasebno. Snaga povezuje zadani učinak, uzorak, raspršenost i prag, dok planiranje prema preciznosti pita koliko nam uzak interval treba. Velik uzorak može otkriti i vrlo malu razliku, a u našoj simulaciji maloga uzorka procjene odabrane prema značajnosti bile su u prosjeku dvostruko veće od stvarne razlike. Taj faktor opisuje odabir prema pragu u prikazanom scenariju i ne prenosimo ga na druga istraživanja. U poglavlju o krizi i obnovi vidjet ćemo kako istraživačke odluke i objavljivanje dodatno oblikuju nalaze koje čitatelj uopće može vidjeti.
Pojmovi
- veličina učinka
- effect size
- standardizirana razlika
- Cohen’s d
- sadržajna važnost
- practical significance
- statistička snaga
- statistical power
- precjenjivanje pri odabiru značajnih nalaza
- selection-induced effect-size exaggeration
- najmanji važan učinak
- smallest effect size of interest
- planiranje veličine uzorka
- sample size planning
- širina intervala
- interval width
Zadaci
Konceptualni
Objasnite u jednom odlomku zašto u simulaciji ovoga poglavlja podskup procjena koje su prešle prag u prosjeku premašuje poznatu razliku, iako prosjek svih procjena ostaje blizu istini. Imenujte korak u kojem nastaje iskrivljenje i objasnite zašto se dobiveni faktor ne smije prenijeti na svako područje.
Računski
Iz upravljanoga agregata data/populacija-medija-agregat.csv uzmite retke za portal i tisak. U tiskanom ili dokumentnom izdanju iste su vrijednosti u tablici uz statični prikaz. Za svaki redak podijelite zbroj povjerenja brojem osoba, usporedite rezultat s pohranjenim prosjekom i izračunajte razliku prosjeka. Zatim za standardiziranu razliku 0,4 zabilježite snagu pri 40, 80, 160 i 300 jedinica po skupini. U HTML-u upotrijebite widget.
Vratite se objašnjenju standardne pogreške i širine intervala u poglavlju o procjeni. Objasnite zašto veći uzorak istodobno sužava interval i povećava snagu, ali ne mijenja unaprijed zadanu veličinu učinka. Predajte dva računa prosjeka, njihovu razliku, četiri vrijednosti snage i jedan odlomak koji povezuje preciznost sa snagom. Ocjenjuje se račun i tumačenje, ne pisanje koda.
Kritički
Prosudite tvrdnju da niska prosječna snaga nekog područja znači samo da istraživanja propuštaju stvarne učinke (Button i sur. 2013.). Predajte kratku uredničku bilješku i navedite podatak koji bi vam trebao da procijenite koliko je objavljena veličina učinka precijenjena.
Revizija modela
Ocijenite provjeru iz okvira o pogrešci. Imenujte što je u pozivu ispravno, argument u kojem stoji kružnost, redak koda u kojem ona ulazi u račun, i napišite čime bi taj argument trebalo zamijeniti.