Pred vama je tekst koji trebate razumjeti i zapamtiti za ispit. Možete ga ponovno pročitati, nacrtati veze među pojmovima ili zatvoriti knjigu i pokušati zapisati čega se sjećate. Posljednji je pokušaj možda najmanje ugodan jer odmah otkriva praznine. Ipak, osjećaj lakoće tijekom učenja ne mora nam reći koliko ćemo znati poslije.
U jednom pokusu studenti su učili prirodoznanstveni tekst u četiri uvjeta. Jedni su ga pročitali jednom, drugi više puta, treći su uz otvoren tekst izrađivali pojmovnu mapu, a četvrti izmjenjivali čitanje i prisjećanje bez teksta. Nakon tjedan dana svi su rješavali provjeru znanja (Karpicke i Blunt 2011.). Zastanimo i predvidimo koja bi skupina najbolje odgovorila na pitanja koja traže povezivanje ideja.
Kako usporediti sve te načine učenja i utvrditi između kojih je skupina razlika dovoljno uvjerljiva da bismo zbog nje promijenili vlastitu naviku?
Četiri načina učenja otvaraju šest parnih usporedbi. S većim brojem skupina broj pitanja brzo raste. Ista se poteškoća pojavljuje kad proširimo poznati primjer medijskih navika. Usporedba televizije i društvenih mreža ostavila je izvan analize korisnike ostalih izvora vijesti. Ako želimo obuhvatiti sve skupine, mogli bismo ponavljati postupak iz prethodnog poglavlja za svaki par. Tada donosimo niz povezanih odluka, pa moramo razmotriti koliko prilika za lažni nalaz nastaje kroz sve usporedbe koje ćemo pregledati. Tu ćemo poteškoću najprije ispitati u simulaciji u kojoj skupine dolaze iz iste raspodjele povjerenja. Svaku pronađenu razliku tada možemo prepoznati kao lažni nalaz. Povezat ćemo tu provjeru s onime što smo u poglavlju o krizi i obnovi naučili o odabiru rezultata. Ovdje je skup usporedbi unaprijed poznat, pa možemo tražiti postupak koji uvažava cijeli skup odluka.
Usporedba televizije i društvenih mreža opisala je jednu razliku u povjerenju. Sada nas zanimaju razlike među svim izvorima i nesigurnost tih procjena.
Uzorak od 300 osoba s pet izvora vijesti zasebno izvlačimo iz nastavne populacije populacija_medija. To je novo izvlačenje, a ne podskup ranijeg uzorka. Jedan redak predstavlja zamišljenu osobu s glavnim izvorom vijesti i povjerenjem na ljestvici od jedan do deset. Rezultati opisuju taj nastavni skup, bez tvrdnje o stvarnoj publici.
Umjesto jedne razlike sredina sada ispitujemo jesu li sve skupinske sredine jednake. Razlaganjem varijabilnosti usporedit ćemo razmake među sredinama s raspršenošću osoba unutar skupina. Iz te ćemo usporedbe razviti analizu varijance i F-test, uz mjeru veličine učinka. Ukupni nalaz još neće odrediti koji se parovi razlikuju. Za njih ćemo prikazati procjene i intervale koji uzimaju u obzir višestruke usporedbe, pa razmotriti i granice pretpostavki. Tako možemo sastaviti odgovor koji razlikuje ukupni obrazac, konkretne razlike i nesigurnost svake opravdane usporedbe.
Cijena mnogih usporedbi
Među pet skupina postoji deset parova. Mogli bismo svaki usporediti zasebnim testom iz prethodnog poglavlja. Simulacijom ćemo provjeriti koliko često taj niz testova daje barem jedan lažni nalaz.
Iz poznate simulirane populacije medijskih navika nasumično sastavljamo pet skupina po četrdeset osoba. Pri tome zanemarujemo njihov izvor vijesti. Sve skupine nastaju odabirom iz iste raspodjele povjerenja, pa među njima nema unaprijed zadane razlike. U svakom ponavljanju provodimo deset usporedbi i bilježimo je li barem jedna značajna. Svako takvo odbacivanje ovdje je pogrešno. Poslije ćemo se vratiti skupinama prema izvoru vijesti, među kojima razlike mogu postojati.
Jedno ponavljanje stvara pet skupina po 40 odgovora. Unutar svake skupine biramo bez vraćanja, ali svaku novu skupinu ponovno izvlačimo iz pune populacije. Ista osoba zato može biti odabrana u različitim skupinama. U prvom stvarno izvedenom ponavljanju sredine su 5,47, 5,08, 4,85, 5,50, 4,85. Među deset obostranih Welchovih usporedbi najmanja p-vrijednost iznosi 0,164, a prag 0,05 prelazi u smjeru odbacivanja 0 usporedbi. Za zbirni rezultat zapisujemo samo ima li barem jedne takve usporedbe. Dva lažna nalaza u istom ponavljanju i dalje znače jedno ponavljanje s pogreškom.
Ponovno izvlačimo svih pet skupina 2.000 puta, zadržavajući istu populaciju, veličine i pravila testiranja. Barem jedan lažni nalaz dobivamo u 548 od 2.000 ponavljanja. Svi su testovi definirani i sva ponavljanja ulaze u račun.
U dvije tisuće ponavljanja barem jedna usporedba bila je značajna u 27,4 % slučajeva. Svaki test koristi prag pet posto, ali cijeli skup daje lažni nalaz u više od četvrtine ponavljanja. Prikaz samo značajnog para sakrio bi tu veću stopu pogreške.
Definicija 1Stopa obiteljske pogreške je vjerojatnost da će barem jedan test u unaprijed određenom skupu testova dati lažno pozitivan rezultat, odnosno pogrešno odbaciti barem jednu istinitu nultu hipotezu.
U našoj su simulaciji sve nulte hipoteze istinite. Kada neke razlike postoje, pratimo vjerojatnost da pogrešno odbacimo barem jednu od preostalih istinitih nultih hipoteza.
Postupak koji kontrolira pogrešku samo kada su sve nulte hipoteze istinite ima slabu kontrolu. Jaka kontrola mora vrijediti i kada dio razlika doista postoji. Tukeyjev postupak u odgovarajućem normalnom modelu sa zajedničkom varijancom štiti obitelj parnih usporedbi i u tom drugom slučaju. Primjerice, ako se samo prva od pet skupina razlikuje od ostalih, ukupni test može lako odbaciti jednakost svih sredina. Među preostalim četirima ipak postoji šest usporedbi jednakih populacijskih sredina. Njihovo zasebno testiranje bez korekcije i dalje otvara mogućnost barem jednoga lažno pozitivnog zaključka.
Za deset neovisnih testova vjerojatnost da nijedan ne pogriješi iznosi \(0,95^{10}\). Suprotni događaj, barem jedna pogreška, zato ima vjerojatnost \(1-0,95^{10}\), približno 0,401.
Za deset neovisnih testova račun daje stopu 40,1 %. U parnim usporedbama pet skupina ista se opažanja koriste više puta, pa usporedbe nisu neovisne i u našoj simulaciji daju nižu stopu. Zasebna simulacija deset doista neovisnih usporedbi daje 40,4 %, blizu računu.
U zasebnom pokusu svaki od deset testova dobiva svoja dva nova uzorka po 40 osoba, pa testovi više ne dijele iste uzorke. Od 2.000 ponavljanja 808 sadrži barem jedno odbacivanje, bez isključenih ponavljanja. Uspoređujemo stope pogreške dviju organizacija testiranja pod nulom. Za usporedbu snage trebali bismo zadati model s razlikom. Novi niz izvlačenja dao bi malo drukčije udjele.
Formula za neovisne testove nije opća gornja granica za ovisne usporedbe. Ipak, oba simulirana skupa daleko prelaze pet posto. Zato uz najmanju p-vrijednost trebamo znati koliko je usporedbi provedeno i kako su povezane.
Za stopu blizu 5 % uz 2.000 ponavljanja standardna pogreška samoga simulacijskog postotka iznosi oko 0,49 postotnih bodova. Mala odstupanja od 5 % zato nisu sama po sebi dokaz pogrešno podešena postupka.
Možemo postaviti i jedno ukupno pitanje o jednakosti svih pet sredina. U istoj simulaciji takav test odbacuje u 4,2 % slučajeva. Uz dvije tisuće ponavljanja taj je udio u skladu s planiranih pet posto.
Varijanca između i unutar
Ukupni test treba prepoznati jesu li razmaci među skupnim sredinama veliki u odnosu na raspršenost koju već imamo među ljudima. Taj smo odnos susreli pri usporedbi dviju skupina. Razlika od jednoga boda jače ih statistički razdvaja kada su osobe unutar skupina slične nego kada su jako raspršene. Sada istu logiku primjenjujemo na sve skupine zajedno.
Ukupnu varijabilnost zato razdvajamo na odstupanja među skupnim sredinama i odstupanja pojedinaca unutar skupina. Model sa skupinama opisuje prvi dio, dok drugi ostaje neobjašnjen.
Da bismo razlaganje vidjeli na manjem prikazu, prelazimo na tri skupine po 24 točke bez stvarne mjerne jedinice. Počinjemo normalnim slučajnim vrijednostima, ali ih zatim u svakoj skupini centriramo i skaliramo tako da njihova ostvarena sredina i standardna devijacija budu točno zadane. Tako dobivamo ilustraciju razlaganja s točno zadanim sažecima. Pri sredinama 46, 52 i 58 zajednička je sredina 52. Skupina A pridonosi zbroju između skupina s \(24(46-52)^2 = 864\). Isti račun radimo za B i C, dok unutar skupina zbrajamo kvadrate udaljenosti svake od 72 točke od njezine skupne sredine.
Zbroj između skupina iznosi \(864+0+864=1\,728\). Dijeljenjem s \(3-1=2\) dobivamo srednji kvadrat 864. Uz standardnu devijaciju 6, zbroj unutar skupina iznosi \(3\times23\times6^2=2\,484\). Nakon dijeljenja sa \(72-3=69\) srednji kvadrat iznosi 36. Omjer je zato \(F=864/36=24\). Srednji kvadrat u nazivniku ima istu mjernu jedinicu kao onaj u brojniku, pa je F bez mjerne jedinice.
Kad su sve tri sredine 52, zbroj između skupina iznosi nula, zbroj unutar ostaje \(2\,484\) i F je nula. U trećem stanju zbroj između ostaje \(1\,728\), a uz standardnu devijaciju 11 zbroj unutar iznosi \(3\times23\times11^2=8\,349\). Srednji kvadrat unutar skupina tada je 121, pa je \(F=864/121\approx7,14\).
Okomite trake prikazuju udaljenost skupnih sredina od zajedničke sredine. Točke prikazuju raspršenost osoba oko sredine njihove skupine. Usporedba stanja pokazuje kako isti razmak sredina izgleda uz različitu raspršenost unutar skupina.
Prikaži kod
viewof w15_par = Inputs.form({sredina_a: Inputs.range([35,65], {value:46,step:1,label:"Sredina skupine A:" }),sredina_b: Inputs.range([35,65], {value:52,step:1,label:"Sredina skupine B:" }),sredina_c: Inputs.range([35,65], {value:58,step:1,label:"Sredina skupine C:" }),rasprsenost: Inputs.range([2,14], {value:6,step:1,label:"Standardna devijacija unutar skupina:" })})
Prikaži kod
{const form = viewof w15_par; form.dataset.learningForm="w15";const state =document.createElement("span"); state.hidden=true; state.dataset.experimentState=JSON.stringify(w15_par);return state;}
Slika 1: Dekompozicija varijance — skupne sredine, zajednička sredina i raspršenost pojedinačnih opažanja.
Što isprobati.
Postavite sve tri sredine na 52 i zadržite standardnu devijaciju 6.
Razmaknite sredine na 46, 52 i 58 te usporedite novi omjer s prvim.
Zadržite razdvojene sredine i povećajte standardnu devijaciju na 12.
U trećem stanju sredine su iste kao u drugome, ali je raspršenost unutar skupina veća, pa omjer pada. Uz standardnu devijaciju 11 njegova je vrijednost \(864/121\approx7,14\), umjesto \(864/36=24\) uz standardnu devijaciju šest. Za procjenu odstupanja od nultog modela trebamo oba izvora varijacije.
Veličina i F-omjer
Zbroj kvadriranih odstupanja označujemo s \(SS\). Dio \(SS_{\text{između}}\) sažima odstupanja skupnih sredina od zajedničke, a \(SS_{\text{unutar}}\) odstupanja pojedinaca od njihove skupne sredine. Ukupni zbroj \(SS_{\text{ukupno}}\) jednak je zbroju tih dijelova. Udio prvog dijela u ukupnom pokazuje koliko je varijabilnosti povezano sa skupinama.
Definicija 2Eta-kvadrat je udio ukupne varijabilnosti ishoda koji otpada na razlike među skupnim sredinama.
Sada prelazimo s početne simulacije nasumično sastavljenih skupina na uzorak iz poznate simulirane populacije medijskih navika. Zadržavamo oznake pet izvora vijesti zadane pri stvaranju podataka i uspoređujemo povjerenje njihovih korisnika. Skupine zato mogu imati različite prosjeke i prije uzorkovanja.
Uzorak od 300 osoba s pet izvora vijesti izvukli smo bez vraćanja iz pune populacije, zasebno od uzorka od 120 korisnika televizije i društvenih mreža. Tablica 1 pokazuje broj odgovora i sredinu koju model pridružuje svakoj osobi iste skupine.
Tablica 1: Pet skupina u glavnom uzorku od 300 osoba. Izrada autora.
Izvor
Broj osoba
Sredina
SD
tisak
32
5,47
1,72
TV
63
5,43
1,78
radio
36
5,36
1,90
portal
99
4,82
1,73
društvene mreže
70
3,84
2,06
Prva uzorkovana osoba navodi tisak i povjerenje 5. Njezina skupna sredina je 5,469, pa u zbroj unutar skupina ulazi \((5 - 5,469)^2\). Za zbroj između skupina kvadriramo razliku svake skupne i zajedničke sredine te je množimo brojem osoba u toj skupini. Tako dobivamo 113,85 između i 1 001,70 unutar. Njihov zbroj, 1 115,55, nazivnik je eta-kvadrata. Svih 300 odgovora ulazi u oba opisa.
U našem uzorku eta-kvadrat iznosi 0,102. Razlike među izvorima vijesti opisuju oko 10 % varijabilnosti povjerenja. Većina razlika među ljudima ostaje izvan modela. Za tu mjeru ovdje ne prikazujemo interval, pa njezina uzoračka nesigurnost nije kvantificirana.
Je li takav udio važan, ovisi o pitanju. Može biti koristan za razumijevanje društvenog stava, a nedovoljan za precizno predviđanje pojedinca. Procjenu zato povezujemo s ranijim nalazima i unaprijed obrazloženim najmanjim važnim učinkom.
Eta-kvadrat opisao je koliki dio ukupne varijabilnosti otpada na razlike među skupinama. Za test jednakosti sredina trebamo još usporediti raspršenost između skupina s onom koja ostaje unutar njih. Sirove zbrojeve zato najprije pretvaramo u usporedive srednje kvadrate. Za \(k\) skupina i \(n\) opažanja dijelimo \(SS_{\text{između}}\) s \(k - 1\), a \(SS_{\text{unutar}}\) s \(n - k\). Ti djelitelji predstavljaju stupnjeve slobode. Dobivamo \(MS_{\text{između}}\) i \(MS_{\text{unutar}}\), gdje \(MS\) označuje prosječnu kvadriranu raspršenost.
Definicija 3F-statistika je omjer prosječne raspršenosti među skupnim sredinama i prosječne raspršenosti opažanja oko njihovih skupnih sredina.
Pod nultim modelom jednakih populacijskih sredina i zajedničke varijance, uz neovisna opažanja, oba srednja kvadrata procjenjuju tu varijancu, pa se njihov omjer F obično nalazi blizu jedinice. Stupnjevi slobode \(k - 1\) i \(n - k\) određuju referentnu F-raspodjelu. Veći omjer daje više razloga za preispitivanje jednakosti sredina.
Referentna F-raspodjela opisuje koje bismo omjere dobivali pod tim nultim modelom uz normalne pogreške. Njezina dva parametra ovdje iznose 4 i 295. Gornjih 5 % raspodjele počinje kod 2,40, dok naš opaženi omjer iznosi 8,38. Tu usporedbu koristimo za test. Veličinu i važnost razlika i dalje čitamo iz sredina, eta-kvadrata i intervala.
Postupak se zove analiza varijance jer uspoređuje izvore varijabilnosti. Njime ipak ispitujemo pitanje o jednakosti skupnih sredina.
Isti model, više koeficijenata
U prethodnom poglavlju binarna oznaka skupine imala je jedan koeficijent razlike. Za pet skupina trebamo četiri takva koeficijenta. Jedna skupina ostaje referentna, a ostale uspoređujemo s njom. U našem je računu to portal.
Pokazatelji \(x_1\) do \(x_4\) označuju četiri nereferentne skupine. Svaki ima vrijednost jedan za svoju skupinu i nula za ostale. Koeficijent \(\beta_0\) daje sredinu reference, a koeficijenti \(\beta_1\) do \(\beta_4\) razlike prema njoj. Populacijska pogreška \(\varepsilon\) opisuje odstupanje od modelne skupne sredine. Nakon prilagodbe opaženo odstupanje zovemo rezidualom.
Svaka osoba pripada samo jednoj skupini. Pet koeficijenata tako opisuje pet skupnih sredina.
Klasični ukupni test zajednički ispituje četiri koeficijenta razlike. Uspoređuje model sa skupnim sredinama i model sa samo jednom zajedničkom sredinom. To je jedno globalno pitanje, različito od deset zasebnih parnih usporedbi.
Klasični i Welchov postupak koriste iste točkaste procjene sredina, ali drukčije računaju nesigurnost. Klasična analiza varijance, kao obični homoskedastični linearni model, procjenjuje zajedničku rezidualnu varijancu. Welch zadržava zasebne skupne varijance i prilagođava stupnjeve slobode. Zato se njihovi intervali i p-vrijednosti mogu razlikovati.
Taj model primjenjujemo na isti uzorak od 300 osoba s pet izvora vijesti. Svakoj osobi pridružujemo sredinu njezina izvora vijesti, pa odstupanja oko tih pet sredina uspoređujemo s odstupanjima oko jedne zajedničke sredine.
Uzorak od 300 osoba dijelimo prema pet izvora vijesti. Ukupni test daje F od 8,38, uz 4 i 295 stupnjeva slobode te p-vrijednost manju od 0,001. Srednji kvadrat između skupina iznosi 28,5, a unutar njih 3,4. Opaženi rezultat teško se uklapa u pretpostavku jednakih populacijskih sredina. Još trebamo procijeniti pojedine razlike i njihovu nesigurnost.
Ljudi sami biraju izvor vijesti, pa se skupine mogu razlikovati i po drugim obilježjima. Model opisuje njihove razlike u povjerenju, ali ne utvrđuje učinak izbora izvora.
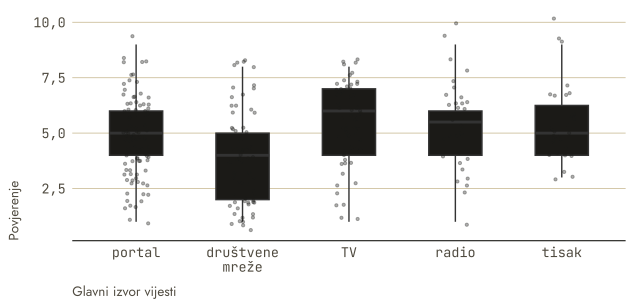
Oblik razlika provjeravamo na samim odgovorima. Kutije prikazuju srednjih 50 % vrijednosti, vodoravna crta medijan, a točke pojedinačne odgovore. Raspršenost i preklapanje ostaju vidljivi uz razlike sredina.
Slika 2: Povjerenje po glavnom izvoru vijesti u istom nastavnom uzorku. Izrada autora.
Nakon ukupnog testa
Za odgovor o konkretnim skupinama trebamo procjene njihovih razlika s intervalima i jasan popis pitanja koja smo postavili. Ukupni test odgovara na šire pitanje o jednakosti svih sredina. Unaprijed planiranu usporedbu možemo provesti izravno, neovisno o njegovu rezultatu.
Usporedbu određenu prije pregleda rezultata zovemo planirana usporedba. Za naknadne usporedbe navodimo post-hoc postupak i obitelj pitanja koju štiti. Tukeyjev postupak u klasičnom modelu sa zajedničkom rezidualnom varijancom obuhvaća sve parove. Daje istodobne intervale koji u toj obitelji kontroliraju stopu pogreške.
Zašto tim razlikama pridružujemo šire intervale nego jednoj zasebnoj usporedbi? Promatramo ih više, pa najveća među deset razlika može biti velika i kada nijednu nismo unaprijed odabrali. Tukeyjev račun uzima u obzir taj izbor koristeći raspodjelu raspona među skupnim sredinama. Širina istodobnih intervala zato ovisi o broju skupina i povezanosti usporedbi.
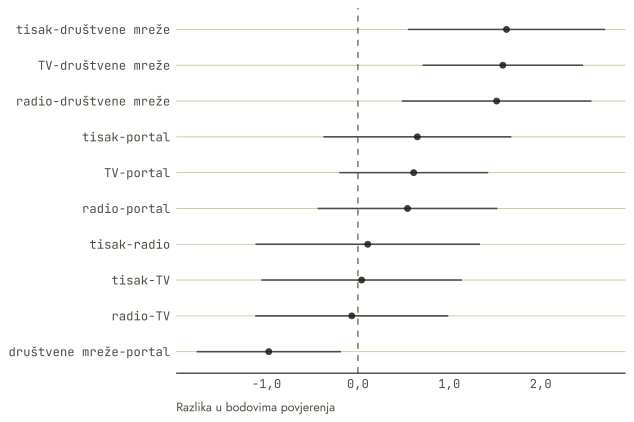
Za jedan par sada oduzmemo dvije sredine iz tablice. Razlici televizije prema mrežama pridružujemo marginu 0,88 boda, izračunatu zajedničkom rezidualnom varijancom, brojnostima tih dviju skupina i Tukeyjevim pravilom za svih pet skupina. Oduzimanjem i dodavanjem te margine nastaju granice intervala. Svih deset usporedbi temelji se na odgovorima iz uzorka od 300 osoba s pet izvora vijesti.
Među 10 parova statistički su razlučive četiri usporedbe s društvenim mrežama. Televizija se od njih razlikuje za 1,59 boda, uz istodobni 95-postotni interval od 0,71 do 2,46. Razlika tiska prema televiziji iznosi 0,04 boda, uz interval od -1,06 do 1,14. Taj par ovim uzorkom ne razlučujemo.
Na zajedničkoj osi možemo pregledati svih deset razlika. U nazivu para prvu skupinu uspoređujemo s drugom, pa pozitivna vrijednost znači višu sredinu prve skupine. Crte su istodobni 95-postotni Tukeyjevi intervali. Okomita crta označuje izostanak razlike.
Slika 3: Svih deset parnih razlika iz istoga modela, uz istodobne intervale. Izrada autora.
Interval za televiziju i tisak širok je više od dva boda. Takav rezultat ostavlja otvoren raspon razlika u oba smjera, uključujući nulu. Za njihovo razlučivanje trebala bi nam preciznija procjena.
Ako nas unaprijed zanima određena usporedba, primjerice tradicionalnih i digitalnih izvora, možemo je izravno planirati. Tada ne štitimo obitelj od deset naknadno odabranih parova. Interval može biti uži, ali samo ako je pitanje doista određeno prije pregleda sredina. Naknadni izbor ne smijemo prikazati kao unaprijed planiran.
U pokusu s početka poglavlja najbolji rezultat na provjeri nakon tjedan dana postigla je skupina koja je vježbala prisjećanje. Prednost se pojavila i na pitanjima koja su tražila povezivanje ideja iz teksta (Karpicke i Blunt 2011.). Studenti su tijekom učenja, međutim, predviđali najveću korist od ponovljenog čitanja, a najmanju od prisjećanja (Karpicke i Blunt 2011.). Vrijedi usporediti taj nalaz s vlastitim početnim predviđanjem.
Karpicke, Jeffrey D., i Janell R. Blunt. 2011. „Retrieval Practice Produces More Learning than Elaborative Studying with Concept Mapping“. Science 331 (6018): 772–75. https://doi.org/10.1126/science.1199327.
Sada preciznije vidimo i što bi bilo potrebno za savjet o učenju. Ukupni test jednakosti četiriju sredina još ne bi pokazao da je prisjećanje bolje od izrade pojmovne mape. Ta tvrdnja traži upravo njihovu usporedbu, uz veličinu razlike i njezinu nesigurnost. U objavljenom pokusu vrijeme učenja bilo je izjednačeno za te dvije skupine (Karpicke i Blunt 2011.). Pri primjeni nalaza na vlastiti ispit dodatno razmatramo gradivo, način provjere i vrijeme do ispita. Možemo iskušati prisjećanje, a njegovu korist prosuđivati prema onome što kasnije uspijemo objasniti.
Granice pretpostavki
Najprije provjeravamo neovisnost jedinica. Ponovljena mjerenja istih ljudi i zajedničko kućanstvo, razred, škola, grad, organizacija ili mrežna veza mogu stvarati ovisnost. Obični klasični, Welchov i rangovni postupak takvu strukturu ne rješavaju. Modeli za ponovljene i ugniježđene podatke prelaze opseg knjige.
Zatim pregledavamo ostatke i skupne raspršenosti. Pretpostavka približne normalnosti odnosi se na ostatke. Klasična inačica pretpostavlja jednake varijance, što trebamo procijeniti iz više informacija, a ne iz jednog pokazatelja.
Omjer najveće i najmanje skupne varijance iznosi 1,43. Koristimo ga kao orijentir uz grafove, veličine skupina i način nastanka podataka. Valjanost klasičnog testa procjenjujemo iz svih tih informacija zajedno. Ako nejednake varijance izgledaju uvjerljivo, Welchov ukupni test zadržava njihove zasebne procjene.
Welchov test daje F od 7,32, uz četiri stupnja slobode u brojniku i 112,4 u nazivniku. Procijenjene sredine i razlike ostaju iste. Provjerili smo osjetljivost ukupnog zaključka na račun nesigurnosti, ali time nismo dokazali jednake varijance ni opravdali Tukeyjeve intervale. Ako varijance nisu jednake, za parove možemo provesti Welchove usporedbe uz Bonferronijevu korekciju. Svaku uspoređujemo s pragom 0,05 podijeljenim brojem planiranih parova. To je zasebno od Tukeyjeva postupka.
Kruskal-Wallisov postupak rangira vrijednosti i uspoređuje raspodjele rangova. Utjecaj krajnjeg opažanja zato više ne ovisi izravno o njegovoj brojčanoj udaljenosti, ali postupak i dalje ima pretpostavke i ispituje drugo pitanje. U našem uzorku statistika iznosi 29,8. Uspoređujemo je s približnom hi-kvadrat raspodjelom uz 4 stupnjeva slobode, jedan manje od broja skupina. Na razini 0,05 kritična vrijednost te hi-kvadrat raspodjele iznosi 9,49. To nije F-raspodjela s dvama brojevima stupnjeva slobode. Za tumačenje razlike u položaju potrebni su usporedivi oblici raspodjela. Rangiranje također ne uklanja ovisnost redaka.
Značajno ovdje, neznačajno ondje. Pretpostavimo da istražujemo program pomoći pri učenju u dvjema dobnim skupinama. U svakoj uspoređujemo sudionike programa s odgovarajućom kontrolnom skupinom. Prvi rezultat označen je kao značajan, a drugi nije. U sažetku zato napišemo da program djeluje samo na mlađe i predložimo da se ubuduće nudi samo njima. Ta je odluka ovdje zamišljena, ali pogreška na kojoj počiva dokumentirana je u istraživačkoj literaturi.
Nieuwenhuis, Forstmann i Wagenmakers pregledali su 513 neuroznanstvenih radova iz pet vodećih časopisa. Među njima su pronašli 78 koji su izravno testirali razliku dvaju učinaka i 79 koji su je zaključili iz toga što je jedan učinak bio značajan, a drugi nije (Nieuwenhuis i sur. 2011.). Zasebni testovi odgovaraju razlikuje li se svaki učinak od svoje nulte vrijednosti. Ne odgovaraju razlikuju li se učinci međusobno.
Nieuwenhuis, Sander, Birte U. Forstmann, i Eric-Jan Wagenmakers. 2011. „Erroneous Analyses of Interactions in Neuroscience: A Problem of Significance“. Nature Neuroscience 14 (9): 1105–7. https://doi.org/10.1038/nn.2886.
U našem bi primjeru procjene koristi programa mogle biti slične, dok bi jedna imala širi interval zbog manjeg uzorka ili veće raspršenosti. Tada bi različite oznake značajnosti odražavale različitu preciznost, a ne dokaz da dob mijenja korist programa. Kad bismo prema tim oznakama suzili buduću primjenu, sadržajnu bismo odluku oslonili na usporedbu koja još nije provedena.
Potrebno je izravno procijeniti razliku između dvaju učinaka i njezinu nesigurnost. Kao i pri razlikovanju ukupnog testa od pojedinačnih usporedbi, prvo određujemo koju razliku tvrdnja traži. Pritom treba opravdati nacrt unutar svake dobne skupine. Smislenost dodatnog računa ovisi o kvaliteti tako osmišljene usporedbe.
Ako je interval razlike učinaka širok, možda još ne možemo odlučiti treba li program prilagoditi dobi. To je korisnije znati nego jednu skupinu proglasiti neprikladnom za program. Razlika između dviju oznaka značajnosti može biti povod za pitanje, ali odgovor traži procjenu razlike o kojoj stvarno odlučujemo.
Nakon ukupnog testa razlika u povjerenju među korisnicima pet izvora vijesti tim želi pregledati sve parove. Podaci su iz poznate simulacije. U ovoj nastavnoj provjeri pretpostavke o neovisnosti, raspodjelama i jednakim varijancama smatramo zadovoljenima. Zadatak je procijeniti postupak donošenja odluka o parovima.
Asistent je pripremio ovaj zapis, koji treba čitati, a ne izvršavati.
Ukupni test ispituje jesu li sve skupne sredine jednake. S pet skupina imamo deset parova. Nakon značajnog ukupnog testa svaki par možemo prosuditi na razini 0,05 bez prilagodbe, a da vjerojatnost barem jedne pogrešne tvrdnje o parovima ostane zaštićena na toj razini.
Odvojite pitanje ukupnog testa od pitanja pojedinačnih parova. Navedite koju tvrdnju o zaštiti treba popraviti i predložite postupak iz poglavlja kojim bi tim izvijestio parne razlike uz odgovarajuću nesigurnost. Sačuvajte ispravno određene skupine i broj usporedbi. Ne pišite zamjenski kod.
Razrađeni primjer
Na istom uzorku od 300 osoba s pet izvora vijesti želimo razdvojiti dva pitanja o povjerenju. Prvo se odnosi na ukupan obrazac skupnih sredina, a drugo na veličinu konkretnih razlika među izvorima. Najprije ćemo prikazati veličinu učinka i ukupni test, a zatim parne razlike s istodobnim intervalima. Tako će uz svaku usporedbu ostati vidljivo da je dio šireg skupa odluka.
Prikaži kod
model<-aov(povjerenje_medijima~izvor_vijesti, data =pet_izvora)tablica<-summary(model)[[1]]eta2<-tablica$`Sum Sq`[1]/sum(tablica$`Sum Sq`)eta2
[1] 0,1020532
Prikaži kod
tablica
               Df  Sum Sq Mean Sq F value      Pr(>F)
izvor_vijesti   4  113,85 28,4613  8,3818 0,000002042 ***
Residuals     295 1001,70  3,3956
---
Signif. codes:  0 '***' 0,001 '**' 0,01 '*' 0,05 '.' 0,1 ' ' 1
Račun počinje modelom skupnih sredina. Poziv aov procjenjuje isti model kao lm, ali prikazuje razlaganje varijance iz kojega prvo računamo eta-kvadrat. Uobičajeni F-test zatim uspoređuje srednje kvadrate uz pretpostavku zajedničke rezidualne varijance. Pod istom pretpostavkom TukeyHSD daje parne razlike, istodobne intervale i korigirane p-vrijednosti. Zato te rezultate čitamo kao klasičnu analizu, uz ranije objašnjenu razliku prema Welchovu postupku.
Zbrojevi kvadrata 113,8 između skupina i 1 001,7 unutar njih daju opisani udio varijabilnosti. F-test provjerava ukupno odstupanje od jednakih sredina. Na prethodnom prikazu parova vidimo da se društvene mreže odvajaju od svakog preostalog izvora, dok ostale parove ne razlučujemo.
U izvještaju možemo navesti da skupine u simuliranom uzorku opisuju oko desetinu varijabilnosti, uz napomenu da nesigurnost toga udjela ovdje nije procijenjena. Razlika televizije i društvenih mreža iznosi oko 1,59 bodova na ljestvici od deset, uz istodobni 95-postotni interval približno od 0,71 do 2,46. Sve četiri usporedbe s društvenim mrežama razlučive su pod pretpostavkama prikazanog postupka. Podaci ipak ne opravdavaju uzročni zaključak.
Sažetak
Kada usporedbu proširimo na više skupina, trebamo pratiti i veću mogućnost barem jednoga lažnog nalaza. Razlaganje varijabilnosti između skupina i unutar njih omogućuje jedno ukupno pitanje o jednakosti sredina, na koje odgovara F-test. Eta-kvadrat opisuje udio varijabilnosti povezan sa skupinama, uz ograničenje da njegovu uzoračku nesigurnost u ovom primjeru nismo kvantificirali. Za odgovor o konkretnoj razlici ipak trebamo planiranu usporedbu ili imenovani post-hoc postupak s odgovarajućim intervalima. Njihove pretpostavke procjenjujemo prema nacrtu, grafovima i skupnim podacima, a za ovisna opažanja trebamo drukčiji postupak. Dosad je model povezivao povjerenje s oznakom skupine, dok ćemo ga u sljedećem poglavlju proširiti na brojčane prediktore i više varijabli zajedno.
Pojmovi
Tukeyjev postupak
Tukey HSD
Kruskal-Wallisov postupak
Kruskal-Wallis test
analiza varijance
analysis of variance
stopa obiteljske pogreške
familywise error rate
F-statistika
F-statistic
planirana usporedba
planned comparison
post-hoc postupak
post-hoc procedure
eta-kvadrat
eta squared
varijanca između skupina
between-group variance
varijanca unutar skupina
within-group variance
Zadaci
Konceptualni
Objasnite zašto značajan ukupni test ne znači da se svaki par skupina razlikuje. Skicirajte tri skupne sredine i raspršenosti uz koje bi ukupni test bio značajan, a samo jedan par razlučiv. Zatim pretpostavite da ste taj par odabrali tek nakon pregleda svih sredina. Odredite je li usporedba planirana ili post-hoc, imenujte obitelj koju treba zaštititi i objasnite zašto je ne smijete prikazati kao jedno unaprijed postavljeno pitanje.
Računski
Razlaganje daje 120 na razlike među četirima skupinama i 480 na razlike unutar njih, uz ukupno sto opažanja. Izračunajte obje prosječne raspršenosti, njihov omjer i eta-kvadrat. Objasnite što bi se s omjerom dogodilo da je drugi broj dvostruko veći.
Kritički
Vratite se poglavlju o mjerenju i dizajnu radi razlike između opisne i uzročne tvrdnje te poglavlju o veličini učinka i snazi radi najmanjega važnog učinka. U agregiranoj tablici data/populacija-medija-agregat.csv pronađite retke za TV i društvene mreže. Prije računanja zapišite najmanju razliku na ljestvici od 1 do 10 koju biste smatrali sadržajno važnom. Izračunajte populacijsku razliku iz stupaca zbroj_povjerenja i broj, usporedite je sa svojim pragom i objasnite zašto rezultat ne dokazuje da odabir izvora uzrokuje povjerenje.
Revizija modela
Ocijenite postupak i obrazloženje iz okvira. Imenujte jedinu pogrešku, odredite koju stopu pogreške ugrožava i razdvojite taj prigovor od dijelova analize koji su još korisni. Predložite način izvještavanja parnih razlika koji odgovara cijeloj obitelji usporedbi. Ne pokrećite kod i ne pišite njegovu zamjenu.