Regresija — opći okvir
Od pravca do općeg linearnog modela
Kad razmišljamo o vlastitoj budućnosti, želimo vjerovati da naš trud otvara mogućnosti. Ipak, obitelji se razlikuju po onome što mogu pružiti djeci, a odrastanje u različitim mjestima donosi različite prilike. Koliko se ekonomski položaj roditelja prepoznaje u položaju njihove odrasle djece?
U istraživanju međugeneracijske mobilnosti u Sjedinjenim Državama istraživači su povezali porezne zapise roditelja i djece te usporedili njihove položaje u raspodjeli prihoda u različitim područjima (Chetty i sur. 2014.). Tako se pitanje koje često promatramo kroz vlastitu obitelj moglo postaviti za mnoge obitelji zajedno.
Zamislimo da u jednom gradu djeca iz obitelji s nižim prihodima kao odrasli stoje bolje nego u drugome. Što bismo trebali znati prije nego što obitelji preporučimo preseljenje?
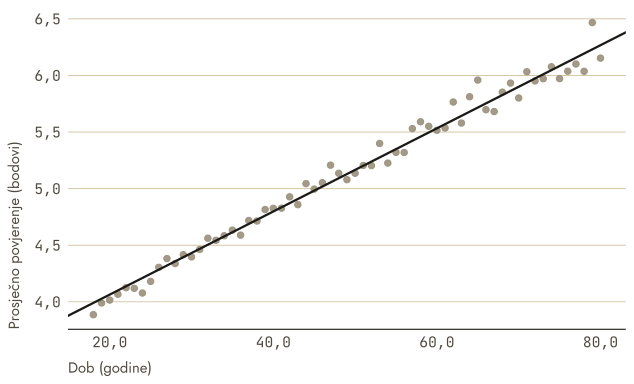
Uspoređivali smo prosječno povjerenje među korisnicima različitih izvora vijesti. Sada nas zanima kako se ono razlikuje s dobi, bez razvrstavanja ljudi u dobne skupine. Možemo postaviti pravac koji za svaku dob daje predviđeni prosjek i zatim provjeriti što takav opis propušta.
Regresija povezuje nekoliko postupaka koje već poznajemo. Korelacija nas je naučila čitati smjer i jačinu linearne veze, a usporedbe dviju i više skupina pokazale su kako oznake skupina ulaze u linearni model. Sada ćemo brojčani i kategorički prediktor promatrati zajedno. Pitanje iz poglavlja o mjerenju i dizajnu pritom ostaje otvoreno. Trebamo procijeniti opisuje li model odnos ili imamo i razloge za uzročno tumačenje.
Usporedbe su pokazale razlike u povjerenju među izvorima, a dobne skupine različit sastav njihove publike. Dob i izvor sada promatramo zajedno. Polazimo od svih 50.000 zamišljenih odraslih osoba u nastavnom skupu populacija_medija, koristeći dob, glavni izvor vijesti i povjerenje u medije.
Jedan zapis pripada jednoj osobi, a računalno stvoreni odgovori ne opisuju stvarne stanovnike. Koristimo cijelu konačnu simuliranu populaciju, pa ne procjenjujemo nepoznatu vrijednost iz uzorka. Koeficijenti će sažeti odgovore, a od njih ćemo odvojiti pravila kojima su stvoreni. Pri povratku ranijim uzorcima ponovno ćemo razmotriti i njihovu nesigurnost.
Odabrani pravac usporedit ćemo s opažanjima preko njihovih odstupanja, reziduala. Tako ćemo razumjeti metodu najmanjih kvadrata prije tumačenja koeficijenata. Dodavanjem izvora vijesti usporedit ćemo zbirni odnos dobi i povjerenja s odnosom pri jednakom izvoru, a interakcijom dopustiti da nagib ovisi o drugoj varijabli. Grafovi reziduala pomoći će nam provjeriti prilagodbu.
Model ćemo na kraju prosuđivati prema svrsi. Dobar opis opaženih odgovora, uspješno predviđanje nove osobe i objašnjenje uzroka traže različite provjere. Trebamo znati što koeficijent uspoređuje, što je ostalo izvan modela i koji bi dodatni dokaz podupro jači zaključak.
Pravac kao tvrdnja o prosjeku
Povjerenje u medije bilježimo na ljestvici od jedan do deset, a dob u godinama. Korelacija bi sažela jačinu linearne veze. Regresijski pravac omogućuje da za odabranu razliku u godinama očitamo modelom predviđenu razliku u bodovima povjerenja.
Podsjetnik. Nagib
Cilj analize je linearni sažetak zabilježenih odgovora svih pedeset tisuća osoba. Budući da analiziramo cijelu zadanu populaciju, nema nesigurnosti zbog uzorkovanja. Pravilo kojim su podaci generirani odnosi se na vrijednosti prije zaokruživanja i ograničavanja ljestvice. Njegove koeficijente trebamo razlikovati od koeficijenata za zabilježene odgovore. Procjenjivane veličine u ovom su poglavlju koeficijenti najmanjih kvadrata za cijelu konačnu populaciju.
Na slici jedna točka sažima sve osobe iste cijele godine dobi. Za nju zbrajamo njihove ocjene i dijelimo njihovim brojem. Pravac ipak računamo iz svih pojedinačnih odgovora, pa dob s više osoba nosi veću težinu. Ne prilagođavamo ga dobnim prosjecima kojima bismo dali jednaku težinu.
Za svaki odabrani odsječak i nagib možemo izračunati odstupanje svakog opažanja od pravca. Tražimo kombinaciju koja daje najmanji zbroj kvadrata tih odstupanja.
Definicija 1 Rezidual je razlika između opažene vrijednosti ishoda kod pojedine jedinice i vrijednosti koju za nju predviđa model, dakle onaj dio ishoda koji model nije objasnio.
Rezidual osobe \(i\) označujemo s \(e_i\), opaženi ishod s \(y_i\), a modelom predviđenu vrijednost s \(\hat{y}_i\). Kapica označuje vrijednost dobivenu prilagodbom modela. U konačnoj populaciji možemo je izračunati bez uzorkovanja. Rezidual \(e_i\) opaženo je odstupanje od prilagođenog pravca, dok \(\varepsilon_i\) označuje neopaženo odstupanje od pretpostavljene populacijske regresijske sredine.
\[e_i = y_i - \hat{y}_i\]
Sami reziduali mogu se poništiti jer su jedni pozitivni, a drugi negativni. Zato ih kvadriramo prije zbrajanja. Kvadrat daje veću težinu velikim odstupanjima, pa krajnja opažanja mogu snažno utjecati na odabrani pravac.
Definicija 2 Metoda najmanjih kvadrata bira koeficijente modela tako da zbroj kvadriranih reziduala bude najmanji mogući za zadane podatke.
Ovdje računamo koeficijente najmanjih kvadrata za cijelu konačnu populaciju. Model ima poznati oblik iz usporedbe skupina. Ishod \(y_i\) opisujemo odsječkom \(\beta_0\), nagibom \(\beta_1\) pomnoženim s prediktorom \(x_i\) i odstupanjem \(\varepsilon_i\).
\[y_i = \beta_0 + \beta_1 x_i + \varepsilon_i\]
Model s jednim brojčanim prediktorom zovemo jednostavna linearna regresija.
Odsječak \(\beta_0\) daje modelsku vrijednost ishoda kada je prediktor nula. Ovdje \(\beta_0\) i \(\beta_1\) pripadaju cijeloj fiksnoj populaciji, a \(e_i\) je izračunati rezidual osobe. Kada bismo koristili uzorak, procjene ciljnih koeficijenata označili bismo kapicama i prikazali njihovu nesigurnost. Za razliku od binarne usporedbe skupina, \(x_i\) sada predstavlja izmjeren broj.
Pogledajmo tri pojedinačna zapisa prije tumačenja koeficijenata. Stupac predviđanja dobivamo uvrštavanjem dobi u izračunati pravac, a rezidual oduzimanjem toga predviđanja od zabilježenoga odgovora.
| Osoba | Dob | Opaženo | Predviđeno | Rezidual |
|---|---|---|---|---|
| 1 | 59 | 4 | 5,496 | -1,496 |
| 2 | 50 | 4 | 5,166 | -1,166 |
| 3 | 45 | 6 | 4,982 | 1,018 |
Za prvu osobu račun glasi \(3,3294 + 0,0367 \times 59\), približno 5,496 boda. Kvadrat njezina reziduala, 2,238, jedan je od 50.000 članova zbroja koji smo minimizirali. Za račun koristimo nezaokružene koeficijente.
Nagib iznosi 0,0367 boda po godini. Deset godina veća dob povezana je s modelskom razlikom od 0,37 boda povjerenja. Odsječak 3,33 odnosio bi se na dob nula, izvan naših podataka. Možemo ga učiniti razumljivijim ako od dobi oduzmemo njezinu sredinu. Tada odsječak opisuje osobu prosječne dobi, a nagib ostaje isti.
Pravac sažima prosječan odnos. Točke na slici predstavljaju prosjeke nekoliko stotina ljudi iste dobi i leže blizu pravca. Pojedinačni odgovori ipak odstupaju po nekoliko bodova. Viši predviđeni prosjek za pedesetogodišnjake nego za tridesetogodišnjake ne određuje odgovor konkretne osobe.
Nagib koji nosi tuđu priču
Koeficijent za zabilježeno povjerenje iznosi 0,0367 boda po godini. Znamo ga bez uzoračne nesigurnosti jer imamo cijelu populaciju. Generator je prije zaokruživanja i ograničavanja ishoda koristio latentni, neposredno neopaženi nagib 0,028. Razlika proizlazi iz toga što brojevi opisuju različite veličine.
U generatoru se s dobi mijenja i izvor vijesti. Prosječna dob kreće se od 33,4 godine među korisnicima društvenih mreža do 47,9 među slušateljima radija. Povjerenje ovisi o oba obilježja. Zbirni nagib uz dob zato uključuje i razlike povezane s izborom izvora.
Provjerimo odnos unutar svakog izvora. Generator zadaje isti latentni dobni nagib svim skupinama. Očekujemo da će njihovi zasebni nagibi biti manji od zbirnoga jer unutar skupine izvor ostaje isti.
| Izvor vijesti | Broj ljudi | Nagib uz dob |
|---|---|---|
| portal | 15 101 | 0,0269 |
| društvene mreže | 13 378 | 0,0258 |
| TV | 10 827 | 0,0281 |
| radio | 5 839 | 0,0268 |
| tisak | 4 855 | 0,0255 |
| Svi zajedno | 50 000 | 0,0367 |
| Latentno pravilo prije mjerenja | — | 0,028 |
Skupni nagibi kreću se od 0,0255 do 0,0281. Zbirni nagib veći je od svakoga. Blizina skupnih nagiba latentnom pravilu pomaže provjeriti generator, ali to su i dalje koeficijenti zabilježenih odgovora. Kao u poglavlju o povezanosti, odnos unutar skupina razlikuje se od ukupnog odnosa.
Izvor ovdje nije konfundirajuća varijabla u strogom uzročnom smislu. U poznatom generatoru nastaje nakon dobi i prije povjerenja, pa nalikuje posredniku. Zbirni koeficijent opisuje ukupni dobni obrazac, a koeficijent pri jednakom izvoru uvjetni obrazac koji isključuje taj put. Nijedan ne pokazuje kako bi se mijenjalo povjerenje iste osobe tijekom starenja.
Različite odgovore dobivamo i uz svih pedeset tisuća osoba jer smo postavili različita pitanja. Kada bismo uzeli uzorak, procjenjivali bismo iste ciljane koeficijente uz odgovarajuću nesigurnost. Interval ni tada ne bi opisivao udaljenost od latentnog pravila prije mjerenja.
Prilagodba i ono što je čini mogućom
Zasebni nagibi pokazali su nam odnos dobi i povjerenja unutar svakog izvora. Ako dob i izvor uključimo u isti model, možemo zajedno izračunati dobni nagib pri jednakom izvoru i razlike među izvorima pri jednakoj dobi. Time pitanje o zbirnom odnosu pretvaramo u skup uvjetnih usporedbi.
Definicija 3 Višestruka regresija procjenjuje modelnu povezanost svakog prediktora s ishodom pri zadanim jednakim vrijednostima svih ostalih prediktora u modelu. Koeficijent je uvjetna usporedba koju zadaje model. Kao usporedba podataka obranjiv je samo ondje gdje postoji dovoljno potpore i preklapanja, pa ne mora označavati stvarno uparene jedinice.
Na primjer, usporedbu četrdesetogodišnjaka koji prate televiziju i portale možemo poduprijeti podacima ako obje skupine sadrže dovoljno ljudi blizu te dobi. Kad jedna skupina sadrži samo mnogo starije osobe, procjena za četrdesetogodišnjake produžuje pravac izvan opaženoga raspona. To zovemo ekstrapolacijom. Zato provjeravamo sadrže li podaci osobe s odgovarajućom kombinacijom dobi i izvora.
Za ovaj model napišimo cijelu jednadžbu. Oznaka \(I_{\mathrm{TV},i}\) ima vrijednost jedan za korisnika televizije i nula za ostale, a jednako definiramo indikatore radija, tiska i društvenih mreža. Portal je referenca za koju su sva četiri indikatora nula.
\[ y_i=\beta_0+\beta_1\,\mathrm{dob}_i+ \beta_2 I_{\mathrm{TV},i}+\beta_3 I_{\mathrm{radio},i}+ \beta_4 I_{\mathrm{tisak},i}+\beta_5 I_{\mathrm{mreže},i}+\varepsilon_i. \]
Koeficijenti daju konkretan račun za svih pedeset tisuća simuliranih osoba. Ovdje su opis konačne populacije, pa im ne pridružujemo interval uzorkovanja.
| Dio | Koeficijent |
|---|---|
| Odsječak | 3,7035 |
| Dob | 0,0269 |
| Društvene mreže | -0,5335 |
| TV | 0,3116 |
| Radio | 0,5951 |
| Tisak | 0,4864 |
Svaka osoba ostaje u istom retku, ali pravac sada dobiva i dodatak za njezin izvor. Za portal je dodatak nula. Za korisnika televizije od 40 godina zbrajamo odsječak 3,704, dobni dio \(40 \times 0,0269\) i televizijski dodatak 0,312. Rezultat je 5,091 boda. To predviđanje opisuje modelnu sredinu za osobe sa zadanim obilježjima. Za korisnika portala iste dobi mijenja se samo dodatak izvora.
U modelu s dobi i izvorom nagib uz dob iznosi 0,0269. To je uvjetni linearni sažetak ove populacije. Blizak je latentnom pravilu 0,028, ali ne procjenjuje istu veličinu. Slaganje koristimo samo za zasebnu provjeru poznatog generatora.
| Izvor vijesti | Latentno prije mjerenja | Koeficijent zabilježenog ishoda |
|---|---|---|
| društvene mreže | -0,55 | -0,53 |
| TV | 0,35 | 0,31 |
| radio | 0,60 | 0,60 |
| tisak | 0,50 | 0,49 |
Stupci tablice razlikuju latentno pravilo i koeficijente zabilježene ljestvice. Potonji su ovdje blago manji zbog zaokruživanja i ograničavanja vrijednosti na jedan do deset. Zaokruživanje i ograničavanje ljestvice tako ulaze i u tumačenje koeficijenata.
Uvid u generator ovdje nam omogućuje usporedbu koju u stvarnom istraživanju obično nemamo. Bez zabilježenog izvora vijesti nagib uz dob ostao bi 0,0367. Ispis sam ne bi objasnio da taj broj odgovara zbirnom, a ne uvjetnom pitanju.
„Kontrola” u regresiji znači usporedbu pri jednakim vrijednostima uključenih varijabli. Ona nije zamjena za randomizaciju. U pokusu randomizacija čini dodjelu neovisnom o početnim obilježjima i uravnotežuje skupine u očekivanju. U konkretnom uzorku mogu ostati slučajne razlike, a provedba i osipanje mogu narušiti usporedbu.
Koeficijent možemo opisati ovako. Ondje gdje podaci podupiru usporedbu, deset godina veća dob uz jednak izvor vijesti povezana je s modelskim prosjekom povjerenja višim za 0,27 boda. Naveli smo jedinicu prediktora, jedinicu ishoda i uvjet usporedbe. Za kategorički prediktor navodimo i referentnu skupinu.
Mogli bismo sada pomisliti da će uključivanje svake dostupne varijable dati bolju usporedbu. No već je izvor vijesti promijenio pitanje na koje odgovara dobni koeficijent. Prije sljedeće prilagodbe zato trebamo razmotriti ulogu te varijable u nastanku podataka. Dijagram razlikuje tri uloge zbog kojih ista računska radnja može imati različite posljedice.
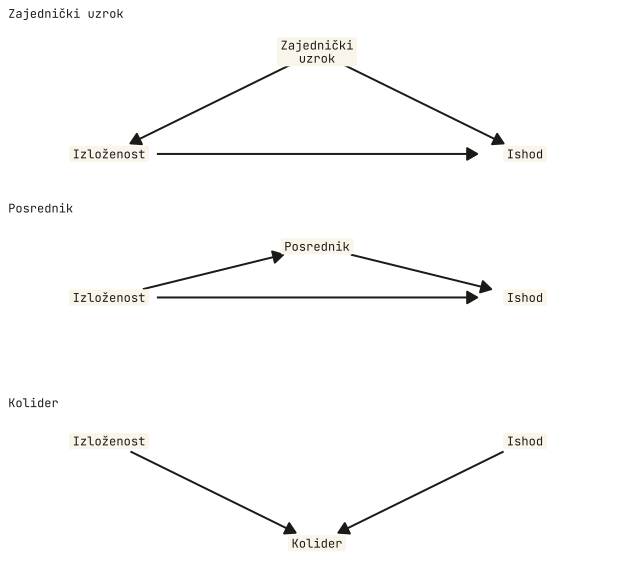
Zajednički uzrok prethodi izloženosti i ishodu te može opravdati prilagodbu. Posrednik nastaje nakon izloženosti, pa njegovim uključivanjem mijenjamo ukupnu usporedbu. Kolider je posljedica obiju varijabli. Uvjetovanje na njega može stvoriti povezanost među inače nepovezanim uzrocima. Prije izbora modela zato razmatramo vremenski redoslijed, kvalitetu mjerenja i ulogu svake varijable.
Odsječak sada daje predviđanje za dob nula i izvor portal, izvan opaženog raspona odraslih osoba. Ovdje služi matematičkom zapisu pravca, dok sadržajno tumačimo predviđanja unutar poduprtog raspona.
Kada dva prediktora nose gotovo istu informaciju, teško je razdvojiti njihove pojedinačne koeficijente. Nedostaju usporedbe u kojima se jedan mijenja, a drugi ostaje isti. Male promjene podataka tada mogu znatno promijeniti koeficijente, iako njihova zajednička predviđanja ostaju slična.
Interakcija i regresijski pravac
U dosadašnjem modelu s dobi i izvorom vijesti nagib uz dob jednak je za sve izvore. Ako nas zanima razlikuje li se nagib među skupinama, trebamo modelu dopustiti i tu mogućnost. To čini interakcija, kojom nagib jednog prediktora može ovisiti o drugome. Za planiranu provjeru unaprijed navodimo modifikator, kodiranje, kontrast i postupak zaključivanja, a kod usmjerene hipoteze i očekivani smjer. Naknadno uočena razlika među podskupinama može dati novo pitanje, ali zahtijeva neovisnu provjeru. Modifikator je varijabla prema kojoj se nagib razlikuje. Kodiranje određuje njezin brojčani zapis, a kontrast konkretnu razliku koju uspoređujemo.
Sljedeće dvije linije namjerno konstruiramo izvan medijske populacije. Za svaku cjelobrojnu vrijednost \(x\) od 0 do 10 upisujemo \(2 + 0,6x\) u A i \(8 - 0,2x\) u B, bez slučajnog odstupanja. Pri \(x=5\) vrijednosti su 5 i 7. Od \(x=5\) do \(x=6\) prva raste za 0,6, a druga pada za 0,2. Jednako mnogo točaka na istim vrijednostima \(x\) daje zbirnom pravcu prosjek tih nagiba.
U prikazu smo skupini A zadali nagib 0,6, a skupini B -0,2. Zbirni nagib iznosi 0,2 i ne opisuje nijednu skupinu zasebno. Dvije linije prikazuju razliku koju bi zajednički koeficijent sakrio. Ako je \(B=1\) za drugu skupinu, a \(B=0\) za prvu, obje zapisujemo jednadžbom \(\hat y=2+0,6x+6B-0,8xB\). Član \(xB\) mijenja nagib iz 0,6 u −0,2. Taj namjerno izražen primjer služi učenju interakcije. Ne tvrdi da su takve razlike nagiba prisutne u prethodnoj medijskoj populaciji.
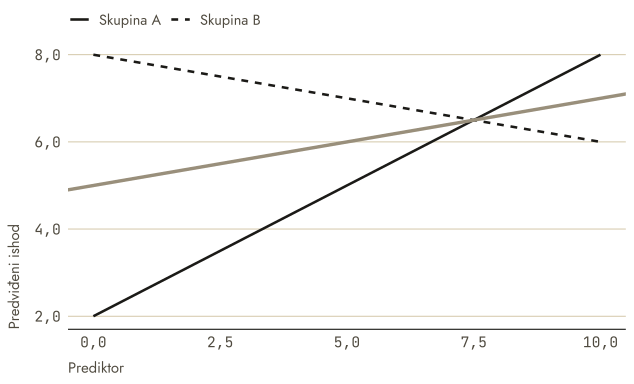
Interakciju čitamo kroz skupne nagibe ili predviđene vrijednosti. Značajan nagib u jednoj i neznačajan u drugoj skupini ne dokazuje da se nagibi razlikuju. Potrebna je izravna procjena interakcije s nesigurnošću (Nieuwenhuis i sur. 2011.). Ovaj deterministički primjer pokazuje oblik odnosa. U stvarnoj analizi trebalo bi prikazati i interval za razliku nagiba.
Nieuwenhuis, Sander, Birte U. Forstmann, i Eric-Jan Wagenmakers. 2011. „Erroneous Analyses of Interactions in Neuroscience: A Problem of Significance“. Nature Neuroscience 14 (9): 1105–7. https://doi.org/10.1038/nn.2886.
Za pomicanje pravca stvaramo drugi nastavni skup od 52 zapisa, s vremenom, angažmanom i prethodnim interesom. Interes generiramo normalno sa sredinom nula i standardnom devijacijom jedan. Vrijeme nastaje kao \(5 + 1,8\) puta interes, uz neovisno odstupanje standardne devijacije 1,5 i donju granicu nula. Angažman je \(20 + 2,3\) puta vrijeme \(+ 7\) puta interes, uz drugo neovisno odstupanje standardne devijacije 4,5. Zato prethodni interes ovdje prethodi objema varijablama i utječe na obje. To je drukčije pravilo od dobnog puta preko izvora vijesti u glavnom primjeru.
Sljedeći prikaz povezuje položaj pravca i duljinu reziduala. Zadani pravac uspoređujemo s pravcem najmanjih kvadrata i s pravcem prilagođenim za prethodni interes. Koristimo manji simulirani skup kako bismo mogli vidjeti pojedinačna odstupanja.
Što isprobati.
- Mijenjajte odsječak i nagib dok se zbroj kvadrata ne približi prikazanom minimumu.
- Povećajte samo nagib za jednu jedinicu i pratite koji se reziduali najviše produljuju.
- Uključite model s prethodnim interesom i usporedite njegov nagib sa zbirnim pravcem.
Blizu minimuma manji pomaci pravca mogu samo malo povećati zbroj kvadrata. Kod uzorka je taj odnos dio računa nesigurnosti koeficijenata. Ovaj prikaz sam ne daje interval ni procjenu uzoračne nesigurnosti.
Prije nastavka vratite se glavnom primjeru s povjerenjem. Pokušajte bez ponovnog čitanja objasniti koju veličinu ondje računamo, što mjeri rezidual, kako biramo pravac i što bi bilo potrebno za uzročni zaključak.
Isti model iza ranijih poglavlja
Model s binarnim prediktorom daje razliku dviju sredina. Model s više kategorija daje razlike prema referentnoj skupini. Sada smo dodali brojčani prediktor. Provjerimo vezu s ranijim računima.
Iste osobe iz uzorka od 120 korisnika televizije i društvenih mreža, iz poglavlja o dvjema grupama, daju razliku sredina 1,19 boda. Koeficijent uz izvor u modelu iznosi 1,19. To su dva zapisa iste točkaste procjene.
Omjer koeficijenta i obične homoskedastične standardne pogreške iznosi 3,21. Jednak je združenom Studentovu t-testu s postavkom var.equal = TRUE. Oba koriste zajedničku rezidualnu varijancu i 118 stupnjeva slobode. Welchov postupak dopušta različite varijance te daje t od 3,18 i 102,471 stupnja slobode. Procijenjena razlika ostaje jednaka, ali račun nesigurnosti se mijenja.
Na istom uzorku od 300 osoba s pet izvora vijesti iz poglavlja o više skupina klasični model daje F od 8,38, uz 4 i 295 stupnjeva slobode. To je isti homoskedastični postupak kao aov iz poglavlja Više grupa. Welch daje F od 7,32, uz 4 i 112,4 stupnja slobode. Zajednički model sredina ne znači jednak test. Objašnjeni udio varijabilnosti u klasičnom modelu iznosi 10,2 %, koliko i prethodno izračunati eta-kvadrat.
T-test, analiza varijance i regresija zato mogu dijeliti model sredina. U svakom izvještaju pitamo koja je jedinica, što se uspoređuje i pod kojim uvjetima. Zasebno provjeravamo pretpostavke i način računanja nesigurnosti.
Tablica za odabir postupka u mrežnom dodatku pomaže povezati vrstu podataka i istraživačko pitanje. Pri tom odabiru i dalje provjeravamo ishod, prediktore, neovisnost i nesigurnost. Welchovu ili običnu homoskedastičnu inferenciju biramo prema pretpostavkama o varijancama i nacrtu.
Ako jedna osoba daje više redaka ili osobe dijele razred, ustanovu ili grad, ponovno provjeravamo jedinicu i ciljanu veličinu. Više redaka može nekim osobama dati veću težinu, a uobičajena nesigurnost više nema opravdanje neovisnosti. Trebamo postupak koji uvažava tu strukturu. Takve modele ovdje ne procjenjujemo.
Pristajanje i njegove granice
Vezu regresije s analizom varijance možemo iskoristiti i za procjenu pristajanja. Ondje nas je zanimalo koliki dio varijabilnosti opisuju skupne sredine. Sada isto pitanje postavljamo za vrijednosti koje predviđa cijeli model, neovisno o tome sadrži li oznake skupina ili brojčane prediktore.
Definicija 4 Koeficijent determinacije je udio ukupne varijabilnosti ishoda u promatranom skupu podataka koji je model objasnio, izračunat kao jedan minus omjer zbroja kvadrata reziduala i zbroja kvadrata odstupanja od zajedničke sredine.
Mjeru označujemo s \(R^2\). U formuli je \(e_i\) rezidual, \(y_i\) opaženi ishod, a \(\bar{y}\) njegova zajednička sredina.
\[R^2 = 1 - \frac{\sum e_i^2}{\sum (y_i - \bar{y})^2}\]
Za model s dobi zbroj kvadrata 50.000 reziduala iznosi 179 511,3. Bez prediktora svakoj bismo osobi dodijelili zajednički prosjek. Zbroj kvadrata odstupanja od njega iznosi 196 832,6. Dijeljenjem prvoga zbroja drugim dobivamo preostali dio varijabilnosti, pa ga oduzimamo od jedan. Usporedba koristi iste osobe i isti ishod.
Model s dobi opisuje 8,8 % varijabilnosti povjerenja, a s dobi i izvorom 12,2 %. Nizak udio može odražavati razlike među ljudima, mjernu pogrešku ili neprikladan oblik modela. Za razlikovanje tih mogućnosti trebamo provjeriti mjerenje i dijagnostičke prikaze modela. Blizina prilagođenog koeficijenta latentnom pravilu također ne mijenja činjenicu da su to različite veličine.
Za sljedeću provjeru uzimamo novi slučajni uzorak od 200 osoba bez vraćanja iz te populacije. Svakoj dodajemo pet neovisnih normalnih brojeva sa sredinom nula i standardnom devijacijom jedan. Ti stupci po pravilu nastanka nemaju vezu s povjerenjem, iako je u konačnom uzorku mogu slučajno pokazati. Uspoređujemo dva modela na istih 200 potpunih redaka.
U toj usporedbi osnovni model sadrži dob i glavni izvor vijesti. Prošireni model istim prediktorima dodaje pet neovisno generiranih normalnih slučajnih varijabli, označenih sum1 do sum5. Oba se prilagođavaju istim dvjema stotinama osoba. Dodatne varijable nemaju sadržajno opravdanje.
Na istim redcima i istom ishodu dodavanje prediktora ne smanjuje obični objašnjeni udio. U uzorku od dvjesto osoba pet slučajnih stupaca povećava ga s 8,1 % na 9,1 %. Prilagođeni koeficijent determinacije uzima u obzir broj prediktora i pada s 5,8 % na 4,3 %. Ta prilagodba pomaže pri usporedbi, ali sama ne provjerava predviđanje, uzročnost ni sadržajnu valjanost.
Za provjeru ograničenja raspona vraćamo se cijeloj simuliranoj populaciji, zasebno od prethodnog uzorka od 200 osoba. Među osobama od trideset do pedeset godina nagib iznosi 0,0385, gotovo kao prije. Objašnjeni udio ipak pada s 8,8 % na 1,4 % u skupu od 24 282 ljudi. Koeficijent determinacije zato ovisi o populaciji i rasponu podataka.
Slični nagibi u različitim populacijama mogu imati vrlo različite objašnjene udjele. Za usporedbu koeficijenata trebamo provjeriti ishod, ljestvicu, populaciju, kodiranje i uključene prilagodbe. Kod uzoraka trebamo i intervale koji odgovaraju nacrtu.
Iza zajedničkog naziva mogu stajati različiti konstrukti i jedinice. U našoj simulaciji „medijska aktivnost” označuje dnevne minute osobe iz konačne populacije odraslih. DigiKat obuhvaća platformske objave prema pravilima korpusa, s jedinicom objave ili agregata (Šikić i sur. 2026.). Osobne minute ne prikazuju svako privatno ponašanje, a korpus ne obuhvaća sadržaj izvan svojeg izbora. Regresija objava zato ne opisuje osobnu uporabu, a skupni obrazac ne možemo pripisati pojedincu. Trebamo usporediti konstrukt, jedinicu, populaciju i obuhvat mjerenja.
Šikić, Luka i sur. 2026. „Prikaz i analiza katoličke tematike u digitalnom medijskom prostoru“. Hrvatsko katoličko sveučilište. https://github.com/lusiki/DigiKat/tree/278a127f9170c1aca82035a4a8357b8a995f91d8.
Za sljedeći dijagnostički primjer ponovno koristimo svih 50.000 osoba, ali mijenjamo ishod iz povjerenja u dnevne minute. Te su minute generirane tako da s dobi rastu i očekivana vrijednost i raspršenost.
Mjesta na kojima model slabije odgovara podacima tražimo pregledom pojedinačnih odstupanja, reziduala. Tako dopunjujemo ukupni opis objašnjenog udjela. U našoj populaciji linearni odnos dnevnog praćenja medija i dobi ima nagib 1,05 minute po godini. Reziduali oko tog pravca nisu jednako raspršeni duž cijelog raspona, što možemo vidjeti na njihovu prikazu. Model računamo na cijeloj populaciji, a slika prikazuje slučajni podskup od 2.000 osoba.
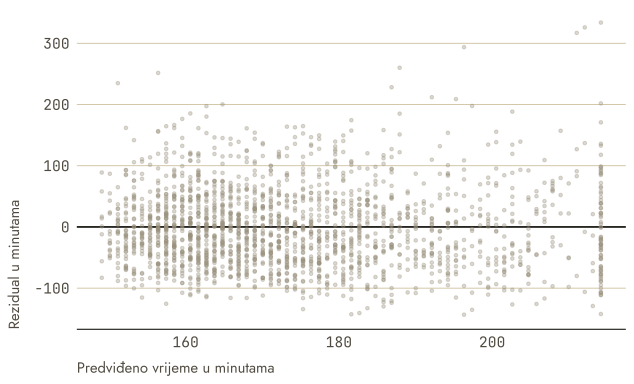
Od šestine s najnižim do šestine s najvišim predviđanjima raspršenost reziduala raste s 58 na 77 minuta. Pogrešku zato trebamo opisati duž raspona predviđanja, uz ukupnu mjeru. Kada bismo imali uzorak, račun nesigurnosti trebao bi dopustiti promjenjivu varijancu. Graf otkriva problem, a sljedeći korak biramo prema cilju analize.
Vrijeme ne može pasti ispod nule. Zbog te granice donji rub ostataka slijedi kosu crtu, a osobe s nulom gomilaju se na njoj. Zakrivljenost oblaka i širenje ostatka prema većim predviđanjima upozoravaju da jedan pravac sa stalnom varijancom ne opisuje sve dijelove raspodjele jednako dobro. Promjena računa standardne pogreške može ublažiti problem nesigurnosti, ali ne ispravlja pogrešan oblik sredine ni predviđanja izvan mogućeg raspona.
Takav pregled modela potreban je uz svaki odabrani način izražavanja nesigurnosti. Bayesovski pristup, koji smo kratko upoznali uz testiranje, može istom modelu pridružiti prethodne raspodjele i dati raspodjelu nesigurnosti koeficijenata ili predviđanja. I tada trebamo dobro mjerenje, prikladne jedinice i opravdane pretpostavke. Takav račun sam ne rješava curenje informacija ni uzročno zaključivanje, a ovdje ostajemo na tom kratkom osvrtu.
Objašnjenje i predviđanje
Za opis odnosa tražimo sadržajno smislen i razumljiv model. Za predviđanje tražimo malu pogrešku na novim jedinicama. Uzročno objašnjenje zahtijeva dodatno opravdanje iz nacrta i identifikacijskih pretpostavki, uvjeta pod kojima opažene odnose možemo pripisati pretpostavljenom uzroku. Shmueli pokazuje da se ti ciljevi razlikuju već pri izboru mjera i varijabli (Shmueli 2010.). Model dobar za jedan cilj može biti loš za drugi.
Shmueli, Galit. 2010. „To Explain or to Predict?“ Statistical Science 25 (3): 289–310. https://doi.org/10.1214/10-STS330.
U sljedećim primjerima povjerenje predviđamo neposredno prije nego što nova osoba odgovori na pitanje o povjerenju. Tada znamo dob i izvor vijesti. Slučajni stupci kojima ćemo pokazati preprilagodbu također su dostupni prije odgovora i jednako definirani u oba skupa. Informacije koje nastaju poslije ishoda ne smijemo koristiti.
Spremnost na plaćanje vijesti u generatoru nastaje nakon povjerenja i pod njegovim utjecajem. Ako je dodamo modelu povjerenja, objašnjeni udio raste s 12,2 % na 13,2 %. Za naš trenutak primjene to je curenje informacija. Prediktor tada još nije dostupan, pa poboljšanje na postojećim podacima nije valjan prediktivni dobitak.
Sada izvlačimo zasebnih 150 osoba za učenje, a iz preostalih osoba 2.000 za provjeru. Skupovi se ne preklapaju. Svakom skupu dodajemo 25 neovisnih normalnih stupaca sa sredinom nula i standardnom devijacijom jedan. To je novi pokus, različit od prethodnih pet stupaca na 200 osoba. Složeniji model koristi svih 25 dodataka, a jednostavniji samo dob i izvor. Oba procjenjujemo na 150 osoba. Dobivene koeficijente zatim zamrzavamo prije predviđanja za 2.000 odvojenih osoba.
Predviđanje provjeravamo na podacima odvojenima prije procjene modela. Pogrešku mjerimo srodno ranijem računu reziduala. Odstupanja opaženih odgovora od predviđanja kvadriramo, izračunamo njihovu sredinu i izvadimo korijen kako bismo se vratili u bodove povjerenja. Tako možemo usporediti pogrešku na podacima za učenje s pogreškom na odvojenim osobama. Ovdje je to interna provjera istog simuliranog mehanizma koja ne dokazuje prijenos u drugo vrijeme, sustav ili populaciju. Oba uspoređena modela koriste samo informacije dostupne do zadanog trenutka.
Prva tri zapisa iz skupa za provjeru pokazuju kako nastaje njegova pogreška. Svako predviđanje dobiveno je bez uporabe odgovora te osobe pri procjeni koeficijenata. Takvo predviđanje za osobe koje nisu sudjelovale u prilagodbi modela zovemo predviđanjem izvan uzorka.
| Osoba | Opaženo | Predviđeno | Kvadrat pogreške |
|---|---|---|---|
| 30952 | 2 | 5,188 | 10,162 |
| 31037 | 9 | 5,662 | 11,143 |
| 36739 | 3 | 3,999 | 0,997 |
Prvi kvadrat ulazi u zbroj s još 1.999 takvih kvadrata. Zbroj dijelimo s 2.000 i vadimo korijen. Za učenje je nazivnik 150. Svi su odgovori i predviđanja definirani, pa nema izostavljanja. Tablica koja slijedi sažima iste račune za oba modela i za predviđanje prosjekom skupa za učenje.
| Model | Na skupu za učenje | Na odvojenom skupu |
|---|---|---|
| Dob i izvor vijesti | 1,78 | 1,88 |
| Dob, izvor i 25 slučajnih brojeva | 1,65 | 2,06 |
| Sama sredina učenja | — | 1,99 |
Na skupu za učenje od 150 osoba složeniji model opisuje 25,4 % varijabilnosti, a jednostavniji 13,1 %. Na tih istih podacima složeniji griješi manje. Na odvojenih 2 000 osoba griješi više od jednostavnijeg modela, pa i od predviđanja zajedničkim prosjekom skupa za učenje. Prilagodio se slučajnim obrascima koji se ne ponavljaju u novim podacima.
Jednostavniji model bolji je na ovom odvojenom skupu. Standardna devijacija povjerenja u populaciji iznosi 1,98 boda, a rezidualna raspršenost nakon uključivanja dobi i izvora 1,86. Ostatak uključuje slučajnu sastavnicu generatora, ali možda i neprimjerenost oblika modela. Za procjenu koliko bi se ta pogreška još mogla smanjiti trebalo bi ispitati i druge opravdane modele.
Valjana provjera predviđanja zato zahtijeva odvojene podatke i prediktore dostupne u trenutku primjene.
Granica prema uzroku
Konfundirajuća varijabla prethodi pretpostavljenom uzroku i ishodu. Regresijom možemo prilagoditi usporedbu za tu varijablu. Njezinu ulogu pritom opravdavamo sadržajnim znanjem, vremenskim redoslijedom i nacrtom istraživanja.
U našem generatoru izvor vijesti nastaje poslije dobi i prije povjerenja. Prilagodba za izvor zato zatvara mogući posrednički put i mijenja cilj sa zbirnog na uvjetni odnos. Blizinu prilagođenog koeficijenta latentnom izravnom pravilu razumijemo jer poznajemo generator. U stvarnom istraživanju takvo slaganje ne bismo mogli pretpostaviti.
Prilagođena povezanost sama ne dokazuje uzrok. Trebamo opravdati vremenski red, izostanak neizmjerenih zajedničkih uzroka i izbor prilagodbi. Važni su i valjano mjerenje, dovoljno preklapanja usporedivih jedinica, jasno definirana intervencija, selekcija i oblik modela. Za svaki uvjet trebamo pokazati na kojim dokazima počiva opravdanje.
Dob je posebno zahtjevna jer nema jednostavno intervencijsko tumačenje. U stvarnom istraživanju ulogu dobi i izvora trebali bismo razmotriti prije računanja. Modelni ispis ne može potvrditi te pretpostavke.
Zato u izvještaju opisujemo usporedbu koju smo doista napravili. Tvrdnja o tome što bi se dogodilo kada bismo nešto promijenili traži nacrt i pretpostavke koji opravdavaju takvu promjenu.
Prije riječi „učinak” korisno je zapisati koja bi druga objašnjenja proizvela isti obrazac i kako ih nacrt isključuje. Ako se ključna pretpostavka ne može provjeriti ovim podacima, trebamo je jasno navesti uz zaključak.
Sada možemo preciznije pročitati priču o ekonomskim prilikama s početka poglavlja. Istraživanje međugeneracijske mobilnosti pokazalo je da se odnos između položaja roditelja i njihove odrasle djece razlikuje među područjima (Chetty i sur. 2014.). Nagib pravca koji povezuje njihove položaje u raspodjeli prihoda opisuje koliko je položaj djece vezan uz položaj roditelja. Za obitelj s nižim prihodima važno je i na kojoj se visini nalazi taj pravac pri njezinu položaju. Dva područja možemo uspoređivati prema jačini veze, ali i prema predviđenom položaju djece iz obitelji s jednakim početnim položajem.
Chetty, Raj, Nathaniel Hendren, Patrick Kline, i Emmanuel Saez. 2014. „Where Is the Land of Opportunity? The Geography of Intergenerational Mobility in the United States“. The Quarterly Journal of Economics 129 (4): 1553–623. https://doi.org/10.1093/qje/qju022.
Autori su veću mobilnost povezali, među ostalim, s manjom segregacijom i boljim osnovnim školama, uz izričito ograničenje da njihova opisna analiza ne utvrđuje uzročne mehanizme (Chetty i sur. 2014.). Obitelji koje žive u tim područjima mogu se razlikovati i po onome što nismo izmjerili. Za preporuku o preseljenju trebalo bi istražiti što se događa usporedivim obiteljima nakon promjene sredine i obrazložiti zašto razliku pripisujemo toj promjeni. Karta mobilnosti može pokazati gdje tražiti objašnjenje, a regresijski pravac sažeti obrazac. Nijedno od toga samo po sebi ne određuje budućnost pojedinog djeteta.
Od omjera do dopuštene rečenice. Školski stručni tim mogao bi iz istraživanja o društvenim mrežama pokušati zaključiti bi li ograničenje vremena uporabe smanjilo simptome depresije. U toj zamišljenoj primjeni nalaz treba pročitati prije nego što ga pretvorimo u preporuku. Analiza se oslanja na presječne podatke istraživanja Ungdata iz 2018., u kojem je 12.353 norveških adolescenata od 15 do 16 godina dalo podatke o vlastitim navikama i simptomima, uz ukupni odaziv od 85 % (Kleppang i sur. 2021.). Ti odgovori omogućuju proučavanje povezanosti uporabe medija i simptoma. Učinak provedene zabrane zahtijevao bi drukčije istraživanje.
Ishod u modelu razlikuje rezultat na mjeri simptoma depresije na ili iznad 80. percentila od nižih rezultata (Kleppang i sur. 2021.). To nije isto što i klinička dijagnoza. Sljedeći izvadak prikazuje kako se omjeri mijenjaju kada se društvene mreže i igranje uključe zasebno ili zajedno.
| Prediktor i kategorija | Model 1, društvene mreže AOR (95 % interval) | Model 2, igranje AOR (95 % interval) | Model 3, oba prediktora AOR (95 % interval) |
|---|---|---|---|
| Društvene mreže, do 3 sata | 1 (ref.) | nije u modelu | 1 (ref.) |
| Društvene mreže, više od 3 sata | 1,60 (1,43–1,80) | nije u modelu | 1,51 (1,34–1,70) |
| Igranje, do 3 sata | nije u modelu | 1 (ref.) | 1 (ref.) |
| Igranje, više od 3 sata | nije u modelu | 1,57 (1,36–1,80) | 1,38 (1,19–1,59) |
Binarni ishod u ovome radu analizira se logističkom regresijom. Taj model povezuje prediktore s logaritmom izgleda, a ne s neograničenom sredinom binarnoga ishoda. Izgledi su omjer vjerojatnosti ishoda i vjerojatnosti njegova izostanka. Eksponiranjem odgovarajućega koeficijenta dobiva se omjer izgleda uz ostale prediktore u modelu. Ovdje učimo čitati objavljeni rezultat. Prilagodba i provjera logističkog modela izvan su opsega knjige (Kleppang i sur. 2021.).
AOR označuje prilagođeni omjer izgleda. Sva tri modela uključuju rod ili spol, imanje prijatelja, pušenje, visoko obrazovanje roditelja i obiteljsko materijalno stanje (Kleppang i sur. 2021.). Model 3 istodobno uključuje obje aktivnosti, pa je omjer za mreže prilagođen i za igranje, a omjer za igranje i za uporabu mreža. Referentne su skupine označene jedinicom. Prije čitanja nalaza treba razlikovati izglede od vjerojatnosti. U zamišljenoj skupini u kojoj ishod ima 20 od 100 osoba, vjerojatnost je 0,20, a izgledi su 20 prema 80, odnosno 0,25. Za vjerojatnost \(p\) isti račun zapisujemo kao \(p/(1-p)\). Omjer izgleda uspoređuje te izglede, a omjer rizika uspoređuje vjerojatnosti. Nijedan nije razlika u postotnim bodovima.
U Modelu 1 procijenjeni izgledi za ishod kod uporabe mreža dulje od tri sata iznose 1,60 puta izglede referentne skupine, uz interval od 1,43 do 1,80 (Kleppang i sur. 2021.). Vrijednosti iznad jedan znače veće, a ispod jedan manje izglede. Interval koji obuhvaća jedan dopušta i jednake izglede. Tim stoga ne može nalaz prepričati kao povećanje vjerojatnosti za 60 postotnih bodova ili kao dokaz da će ograničenje uporabe ukloniti odgovarajući dio simptoma.
Westreich, Daniel, i Sander Greenland. 2013. „The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficients“. American Journal of Epidemiology 177 (4): 292–98. https://doi.org/10.1093/aje/kws412.
Za predviđenu vjerojatnost trebaju odsječak, ostali koeficijenti i vrijednosti prediktora. Izvadak ne daje nazivnike modela, mjere pristajanja ni dijagnostiku, pa ne omogućuje provjeru gubitka redaka i pristajanja. Koeficijenti prilagodbenih varijabli nisu automatski njihovi uzročni učinci (Westreich i Greenland 2013.).
Školskom timu nalaz pokazuje povezanost vrijednu daljnjeg proučavanja. Presječni nacrt, samoprijava i mogući neizmjereni čimbenici ne dopuštaju uzročni zaključak (Kleppang i sur. 2021.). Tablica tako čuva opaženi nalaz, a pokazuje koji dokaz još nedostaje za odluku o ograničavanju uporabe.
Kleppang, Annette Løvheim, Anne Mari Steigen, Li Ma, Hanne Søberg Finbråten, i Curt Hagquist. 2021. „Electronic Media Use and Symptoms of Depression among Adolescents in Norway“. PLOS ONE 16 (7): e0254197. https://doi.org/10.1371/journal.pone.0254197.
Izvor su Annette Løvheim Kleppang, Anne Mari Steigen, Li Ma, Hanne Søberg Finbråten i Curt Hagquist, „Electronic media use and symptoms of depression among adolescents in Norway”, PLOS ONE 16(7), e0254197, 2021, članak i izvorna Tablica 3. Licenca je CC BY 4.0. Tablica je skraćena, preoblikovana i prevedena na hrvatski. Brojevi i granice intervala sačuvani su. Prilagodba ne podrazumijeva odobrenje autora ni PLOS-a.
Tim želi provjeriti predviđa li model povjerenje kod novih korisnika uz korijen srednje kvadratne pogreške manji od dva boda. To je unaprijed zadan kriterij ove nastavne vježbe. Za prilagodbu je uzeto prvih 200 zapisa simulirane populacije. U zamišljenoj primjeni svi prediktori dostupni su prije odgovora o povjerenju.
Asistentov račun rabi naziv uzorak za tih istih 200 zapisa.
Ispis daje \(R^2 =\) 0,12 i korijen srednje kvadratne pogreške 1,78 boda na ljestvici povjerenja od jedan do deset. U zapisu nema drugog skupa podataka. Asistent zaključuje sljedeće.
Izračunane vrijednosti opisuju pristajanje modela navedenim zapisima. Pogreška je manja od dva boda, pa je zadani kriterij za nove korisnike zadovoljen i model možemo preporučiti za primjenu.
Pratite iz kojih redaka dolaze koeficijenti, a iz kojih pogreške. Napišite što ovaj ispis već podupire i koju provjeru treba provesti prije odluke o primjeni. Vaša preporuka treba odrediti kako bi se novi rezultat usporedio s unaprijed zadanim kriterijem.
Razrađeni primjer
Vratimo se našim simuliranim podacima. Koliko se povjerenje razlikuje s dobi i što se u tom odgovoru promijeni kada uspoređujemo osobe s jednakim izvorom vijesti? Izračunat ćemo oba nagiba na istim zabilježenim odgovorima svih pedeset tisuća osoba. Tako razliku među koeficijentima možemo povezati s promjenom pitanja, bez promjene analizirane populacije.
Prikaži kod
     zbirni prilagodeni
 0,03672382  0,02688517
Funkcija lm ovdje računa opis cijele konačne populacije. Zato ne koristimo confint za uzoračne intervale. Uobičajeni interval te funkcije odnosio bi se na drugi modelni ili nadpopulacijski cilj. To znači zaključivanje o zamišljenom procesu koji bi stvarao i druge populacije, a taj cilj ovdje nismo odabrali.
| Model | Konačnopopulacijski nagib | Uzoračna nesigurnost |
|---|---|---|
| Samo dob | 0,0367 | nema |
| Dob i izvor vijesti | 0,0269 | nema |
Oba nagiba znamo točno za zadanu populaciju. Zbirni uključuje dobni obrazac povezan s izborom izvora, dok prilagođeni uspoređuje pri jednakom izvoru. Različite brojke proizlaze iz različitih pitanja. Izvještaj mora pokazati koje je pitanje postavljeno.
U zbirnom modelu deset godina veća dob povezana je s predviđenim prosjekom povjerenja višim za 0,37 boda. Uz jednak izvor razlika iznosi 0,27 boda. Prva rečenica opisuje ukupni, a druga uvjetni linearni odnos.
Ovim smo koeficijentima opisali cijelu zadanu populaciju, pa im ne pridružujemo uzoračni interval. Kada bismo istu usporedbu procjenjivali iz uzorka, trebali bismo odgovarajuću nesigurnost. Za predviđanje odgovora nove osobe trebali bismo i provjeru na odvojenim podacima, uz prediktore dostupne u trenutku primjene. Uzročna tvrdnja tražila bi dodatno opravdanje izvan ovog računa.
Granica našeg opisa ovisi i o onome što smo uključili u model. Uz dva odabrana prediktora u stvarnom bismo istraživanju razmotrili, primjerice, obrazovanje, iskustvo s redakcijama ili političke sklonosti. Njihovo uključivanje moglo bi promijeniti ciljanu uvjetnu usporedbu i koeficijent.
Prikazani nagibi opisuju razlike među osobama u populaciji u jednom trenutku. Za proučavanje promjene povjerenja iste osobe tijekom starenja ili promjene izvora vijesti trebali bismo je pratiti kroz vrijeme, uz nacrt primjeren tom pitanju.
Sažetak
Regresiju možemo čitati kao nastavak ranijih usporedbi, u kojem najmanji kvadrati biraju koeficijente prema odstupanjima opažanja od predviđenih vrijednosti. Dodavanjem prediktora prelazimo na uvjetne usporedbe, a interakcijom dopuštamo da se nagibi razlikuju. Naš je primjer pokazao zašto koeficijente zabilježenih odgovora, nakon zaokruživanja i ograničavanja ljestvice, trebamo razlikovati od pravila kojima smo podatke stvorili. Reziduali pomažu provjeriti pristajanje, a veći objašnjeni udio ne jamči bolje predviđanje novih osoba jer ga mogu povećati i slučajni prediktori. Zato predviđanje provjeravamo na odvojenim jedinicama uz informacije dostupne u trenutku primjene, dok uzročno tumačenje prilagođene povezanosti traži dodatno opravdanje. S tom razlikom između opisa, predviđanja i uzroka možemo u sljedećem poglavlju prosuditi kako se modeli koriste u odlukama o ljudima.
Pojmovi
- linearna regresija
- linear regression
- procjenjivana veličina
- estimand
- rezidual
- residual
- metoda najmanjih kvadrata
- least squares
- višestruka regresija
- multiple regression
- prilagođena povezanost
- adjusted association
- koeficijent determinacije
- R-squared
- interakcija
- interaction
- curenje informacija
- information leakage
- predviđanje izvan uzorka
- out-of-sample prediction
- izgledi
- odds
- omjer izgleda
- odds ratio
Zadaci
Konceptualni
Objasnite u jednom odlomku zašto se nagib uz dob mijenja kada u model uđe izvor vijesti, a nijedan podatak o dobi pritom nije promijenjen. Imenujte pitanje na koje odgovara svaki od dvaju nagiba. Na prikazu interakcije zatim odredite koji nagib opisuje skupinu A, koji skupinu B i zašto zbirni nagib ne opisuje nijednu.
Računski
Zbirni nagib iznosi 0,0367 boda po godini. Izračunajte modelom predviđenu razliku prosjeka između dobi od 25 i 55 godina, a zatim isti račun ponovite s prilagođenim nagibom 0,0269 uz jednak izvor vijesti. Predajte obje brojke i objasnite zašto nijedna ne određuje ostvarenu razliku dviju konkretnih osoba.
Kritički
Vratite se poglavlju o mjerenju i dizajnu radi operacionalizacije i vremenskog reda te poglavlju o tome kako brojke zavode radi razlike između točne brojke i preširoke tvrdnje. U prilagođenoj tablici iz okvira odredite što je mjereno, koja je referentna skupina, koju količinu podupire ćelija 1,60 i koja bi dodatna količina trebala za tvrdnju o apsolutnoj vjerojatnosti. Zatim preuredite naslov „Više od tri sata na društvenim mrežama povećava depresiju za 60 %” u jednu rečenicu koju presječni nacrt i prikazani omjer izgleda doista podupiru.
Revizija modela
Ocijenite račun i zaključak iz okvira o pogrešci. Imenujte što je u kodu ispravno i povežite obje prijavljene veličine sa skupom na kojem su dobivene. Napišite zaključak koji bi isti ispis podnio te opišite provjeru potrebnu za nove korisnike. Objasnite zašto unaprijed dostupni prediktori sami ne potvrđuju uspješnost predviđanja na novim podacima.