| Izvor | Osoba | Zbroj | Sredina | SD |
|---|---|---|---|---|
| društvene mreže | 70 | 316 | 4,51 | 1,95 |
| TV | 50 | 285 | 5,70 | 2,05 |
Uspoređivanje dviju grupa
Ista razlika, različiti dizajni i zaključci
Što biste dobili, a što propustili kada biste nakratko isključili Facebook? Možda biste oslobodili vrijeme, ali biste drukčije dolazili do vijesti i obavijesti ljudi koje pratite. U poglavlju o povezanosti razmatrali smo odnos digitalnih navika i dobrobiti. Ovdje nas zanima posljedica promjene navike.
Deaktivacija računa tijekom četiri tjedna istražena je pokusom prije američkih izbora 2018. godine (Allcott i sur. 2020.). Dobrovoljci koji su pristali na ponuđenu naknadu za deaktivaciju računa nasumično su raspoređeni u skupine (Allcott i sur. 2020.). Istraživači su pratili dobrobit i informiranost, uz usporedbu sa skupinom koja je nastavila koristiti Facebook (Allcott i sur. 2020.).
U odnosu na istraživanje adolescenata iz poglavlja o povezanosti ovdje se mijenjaju i sudionici i pitanje. Pratimo određenu skupinu korisnika i privremenu deaktivaciju jedne platforme.
Za svaki ishod trebalo je procijeniti razliku među skupinama i njezinu nesigurnost. Randomizacija je oblikovala skupine, ali sudionici nisu bili slučajan uzorak svih korisnika (Allcott i sur. 2020.). Kako usporedbu uskladiti s istraživačkim nacrtom i obrazložiti na koga se zaključak odnosi?
Oznaka glavnoga izvora vijesti u prethodnom nam je poglavlju služila za brojanje osoba u kategorijama. Sada uz oznaku skupine promatramo brojčani odgovor. Zanima nas koliko se prosječno povjerenje u medije razlikuje među skupinama i koliko smo tu razliku precizno procijenili. Poznato pitanje o povezanosti time dobiva drukčiji oblik podataka i drukčiji račun.
Usporedba tiska i portala pokazala je razliku u povjerenju, a dobne skupine različit sastav publike izvora. Sada procjenjujemo razliku između korisnika televizije i društvenih mreža s njezinim intervalom.
Iz iste nastavne populacije populacija_medija zasebno izvlačimo uzorak od 120 korisnika televizije i društvenih mreža. Svaki redak predstavlja jednu zamišljenu osobu, njezin izvor i povjerenje na ljestvici od jedan do deset. Rezultati se odnose na tu simulaciju, bez zaključka o stvarnoj publici.
Za izbor postupka vratit ćemo se nacrtu istraživanja. Razlika između rezultata različitih ljudi i promjena izmjerena na istim ljudima traže različite račune. Zasebno ćemo razmotriti i usporedbu jedne sredine s unaprijed zadanom vrijednošću. Na simuliranim ponovljenim mjerenjima provjerit ćemo kako očuvanje parova mijenja procjenu nesigurnosti. To nas vodi do različitih oblika t-testa, uz isto polazište u procjeni razlike.
Intervale, veličinu učinka i pogreške odluke već poznajemo, pa možemo usmjeriti pozornost na to koji račun odgovara kojim opažanjima. Welchov postupak usporedit ćemo s linearnim modelom u kojem oznaka skupine postaje prediktor, odnosno varijabla kojom model opisuje razlike u ishodu. Provjerit ćemo zašto jednaka procjena razlike ne mora značiti jednaku standardnu pogrešku. Grafovima ćemo pregledati pretpostavke i razmotriti što mijenja postupak temeljen na rangovima. Naš će izvještaj povezati nacrt, procjenu i njezine granice. Sama razlika u povjerenju neće nam reći što bi se dogodilo kada bi osoba promijenila izvor vijesti.
Tko nosi dva rezultata
Prije nego što izaberemo račun za razliku, trebamo razjasniti što uspoređujemo. Jesu li to odgovori različitih ljudi, dva mjerenja istih ljudi ili rezultat jedne skupine prema zadanoj vrijednosti? Ta tri pitanja vode različitim postupcima.
Možemo usporediti sredinu jedne skupine s unaprijed zadanom vrijednošću, primjerice sredinom ljestvice ili pragom odluke. Procjena iz ranije ankete nije takva konstanta. Ima vlastitu nesigurnost, a možda i drukčiju ciljnu populaciju ili mjerenje, pa pri usporedbi trebamo uvažiti obje procjene. Druga situacija obuhvaća dvije skupine različitih ljudi, primjerice korisnike televizije i društvenih mreža. U trećoj iste osobe mjerimo dvaput, prije i poslije događaja.
Definicija 1 Jedinica neovisnosti je entitet koji se u istraživanju mogao pojaviti ili izostati neovisno o ostalima, pa njegove vrijednosti nisu unaprijed vezane uz vrijednosti bilo koje druge jedinice u istom skupu.
U našoj usporedbi dviju neovisnih skupina jedinica je osoba. Kod ponovljenog mjerenja osoba ostaje jedinica, ali daje dva povezana rezultata. Za dvadeset osoba mjerenih dvaput računamo dvadeset razlika, po jednu za svaku osobu. Ako zanemarimo povezanost unutar para, pogrešno računamo nesigurnost. Uz pozitivnu povezanost iz primjera koji slijedi interval postaje nepotrebno širok.
Najprije zato imenujemo jedinicu i opisujemo veze među mjerenjima. Tek potom biramo postupak usporedbe.
Ovisnost može nastati i među različitim osobama. Učenici istog razreda ili članovi istog kućanstva mogu dijeliti uvjete koji utječu na rezultat. Povezani mogu biti i ljudi u društvenoj mreži. Ovisnost među njihovim zapisima trebamo zabilježiti i odabrati postupak koji uvažava tu strukturu. Takvi modeli prelaze opseg ovog poglavlja.
Razlika prije oznake
U usporedbi televizije i društvenih mreža zadržavamo osobe koje navode jedan od ta dva glavna izvora. Osobe s drugim izvorom ostaju izvan analize, pa se procjena odnosi samo na odabranu usporedbu unutar simulirane populacije.
U izvještaju prvo navodimo razliku u izvornim jedinicama i njezin interval. Zatim prikazujemo test i standardiziranu razliku. Tako čitatelj prije odluke o nuli može procijeniti veličinu i nesigurnost opaženog odnosa.
Uzorak od 120 korisnika televizije i društvenih mreža izvučen je bez vraćanja iz populacije ograničene na ta dva izvora, zasebno od uzorka od 800 osoba. Broj korisnika svakog izvora nije unaprijed zadan. Zbrajanjem njihovih odgovora i dijeljenjem odgovarajućim brojem osoba dobivamo dvije sredine.
U retku društvenih mreža dijelimo 316 s 70, a u retku televizije 285 s 50. Zatim od televizijske sredine oduzimamo sredinu mreža. Kada raspršenost procjenjujemo iz istog uzorka, njezina nesigurnost također ulazi u zaključak. t-raspodjela zvonasta je referentna krivulja s debljim repovima od normalne. Pri manje podataka zato traži veću udaljenost od nule. Kako raste broj stupnjeva slobode, približava se normalnoj krivulji. Kritična t-vrijednost omeđuje središnjih 95 % te referentne raspodjele za obostrani 95-postotni interval.
Stupnjevi slobode opisuju koliko neovisnih odstupanja ostaje nakon procjene sredina. U jednoj skupini procijenjena sredina veže zbroj odstupanja na nulu, pa ostaje n − 1. Združeni postupak za dvije skupine koristi n₁ + n₂ − 2 uz pretpostavku zajedničke varijance. Welchov postupak umjesto toga računa efektivnu vrijednost prema doprinosu nesigurnosti svake skupine. Ona može biti razlomljena i ne predstavlja broj osoba.
Za interval trebamo i nesigurnost te razlike. Welchov račun zbraja dvije procijenjene varijance sredina, \(s_T^2/n_T+s_M^2/n_M\), i iz njihova zbroja vadi korijen. Dobivenu standardnu pogrešku 0,373 množimo pripadnom kritičnom t-vrijednošću i oduzimamo od razlike te joj dodajemo. Uključeni su svi odgovori.
U ovome računu Welchovi stupnjevi slobode iznose 102,471, a pripadna kritična vrijednost 1,983. Za test nulte razlike dijelimo opaženu razliku njezinom standardnom pogreškom. Dobivenu t-statistiku uspoređujemo s oba repa iste t-raspodjele. Taj račun pretpostavlja neovisne skupine i jedinice te približno normalne sredine. Za male skupine posebno je važan oblik raspodjele bez dominantnih krajnjih vrijednosti.
U uzorku od 120 korisnika televizije i društvenih mreža prosječno povjerenje iznosi 5,70 među onima koji navode TV kao glavni izvor vijesti i 4,51 među onima koji navode društvene mreže. Razlika iznosi 1,19 boda uz interval pouzdanosti od 0,45 do 1,92.
Koristimo Welchov interval, koji zasebno procjenjuje varijancu svake skupine. Pripadni obostrani test ispituje je li populacijska sredina TV skupine minus sredina skupine društvenih mreža jednaka nuli. Ovdje uspoređujemo sredine. Ne testiramo jednakost cijelih raspodjela.
Interval obuhvaća razlike ispod pola boda i blizu dva boda. Te vrijednosti mogu voditi različitim praktičnim odlukama. Širina intervala čini tu nepreciznost vidljivom uz oznaku značajnosti.
U simulaciji znamo da stvarna razlika iznosi 1,30 boda i da je interval obuhvaća. Dugoročni obuhvat provjeravamo ponavljanjima kakva smo koristili u poglavlju o procjeni. Ovaj je pogodak samo jedno od mogućih ponavljanja.
Interakcija — Uzorkivač dviju grupa
Ovo je zaseban normalni model bez ljestvice povjerenja. U prikazanoj postavci svaka skupina ima 50 ishoda, sredine su 0 i 5, a standardna devijacija 10. U neovisnom nacrtu svaki ishod izvlačimo zasebno. U uparenom dva ishoda iste osobe dijele dio slučajnog odstupanja, tako da je zadana korelacija 0,65. Za jedan skup oduzimamo sredinu A od sredine B, odnosno računamo prosjek promjena unutar parova.
Raspodjelu tih razlika ovdje stvaramo kraćim računom. Za zadani normalni model poznajemo njezinu sredinu i standardnu pogrešku, pa razlike izvlačimo izravno iz te raspodjele, bez stvaranja svih pojedinaca svakoga novog uzorka. Digitalni prikaz koristi 1.500 takvih razlika, a tiskani 4.000 po nacrtu. Uključena su sva ponavljanja. Njihov raspon pokazuje preciznost procjene. Za snagu testa ili obuhvat intervala trebali bismo u svakom ponavljanju provesti odgovarajući dodatni račun. Oblik histograma može se malo promijeniti pri novom izvlačenju.
Na slici uspoređujemo raspršenost pojedinačnih rezultata i preciznost procijenjene razlike. Uz ishode skupina prikazane su raspodjele razlika za neovisna i uparena mjerenja. Veličina uzorka, stvarna razlika i raspršenost ishoda jednake su, pa možemo vidjeti učinak uparivanja. Okomite crte označuju zadane sredine ishoda u prva dva panela i stvarnu razliku u preostala dva. Okomite ljestvice prilagođene su pojedinom panelu, pa uspoređujemo širinu raspodjela na zajedničkoj vodoravnoj osi.
Što isprobati.
- Povećajte stvarnu razliku uz jednaku raspršenost.
- Povećajte raspršenost uz jednaku razliku i pogledajte oba panela.
- Povećajte broj jedinica bez promjene razlike i raspršenosti.
- Prebacite dizajn u upareni uz sve ostalo nepromijenjeno.
U ovom primjeru uparena mjerenja daju užu raspodjelu procijenjenih razlika. Kada računamo promjenu unutar osobe, uklanjamo dio varijacije koji potječe od trajnih razlika među osobama. Taj dobitak zadržavamo samo ako u analizi sačuvamo parove.
Ista razlika, dva dizajna
Pogledajmo to na 60 simuliranih osoba izmjerenih prije i poslije događaja. Pomak, varijance i povezanost zadani su kako bismo uvježbali račun za povezana mjerenja. Podaci ne opisuju stvarne ljude. Ni u stvarnom istraživanju takva promjena sama, bez kontrolne skupine ili randomizacije, ne bi dokazivala učinak događaja.
Vraćamo se računu iz pojedinačnih zapisa, ali stvaramo nove osobe. Svakoj od 60 osoba najprije generiramo zajedničku osnovu iz normalne raspodjele sa sredinom 5 i standardnom devijacijom 1,6. Početnom mjerenju dodajemo neovisno odstupanje standardne devijacije 0,7. Završnom dodajemo zadani pomak 0,45 i drugo takvo odstupanje. Prva tri para prikazuju ostvarene vrijednosti i njihovo oduzimanje. Ishodi ovdje nisu zaokruženi ni ograničeni na ljestvicu od 1 do 10.
| Osoba | Prije | Poslije | Promjena |
|---|---|---|---|
| 1 | 6,48 | 7,59 | 1,11 |
| 2 | 6,13 | 7,68 | 1,55 |
| 3 | 4,89 | 4,50 | -0,39 |
Za pregled uparenih podataka potrebna su dva pogleda. Na prvome svaka točka povezuje dva mjerenja iste osobe, a dijagonala znači jednaka mjerenja. Na drugome pregledavamo raspodjelu razlika, jer se na njih odnosi upareni postupak. Ne možemo je zamijeniti zasebnim histogramima prije i poslije.
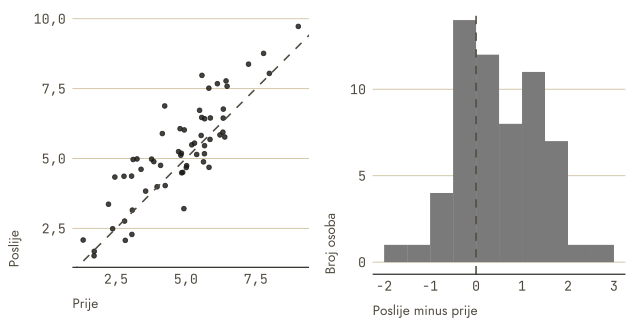
Prva promjena iznosi 7,59 minus 6,48, odnosno 1,11. Zbroj svih 60 promjena dijelimo sa 60, a njihovu standardnu devijaciju s \(\sqrt{60}\) za standardnu pogrešku sredine. Svi parovi ostaju uključeni.
Uparena t-statistika zato je sredina promjena podijeljena sa \(s_{\mathrm{promjena}}/\sqrt{60}\). Referentna t-raspodjela ima 59 stupnjeva slobode. P-vrijednost zbraja oba repa iza apsolutne opažene statistike. Neovisnost se ovdje traži među osobama, dok se povezanost dvaju mjerenja iste osobe čuva izračunavanjem njezine promjene.
Korelacija mjerenja iznosi 0,86. Osobe s višim početnim rezultatom uglavnom imaju viši i završni rezultat. Velik dio raspršenosti zato odražava razlike među osobama, dok nas zanima njihova promjena. Za svaku osobu najprije oduzmemo početni rezultat od završnoga. Dobivene razlike čine jedan uzorak čiju sredinu možemo usporediti s nulom, pa upareni račun prepoznajemo kao jednouzoračni postupak primijenjen na promjene.
Prosječna promjena iznosi 0,48, a standardna devijacija pojedinačnih razlika 0,90. Uparena analiza daje interval od 0,25 do 0,71, uz p-vrijednost 0,0001.
Ako iste podatke pogrešno obradimo kao neovisne skupine, dobivamo interval od -0,14 do 1,10 i p-vrijednost 0,126. Prosječna promjena ostaje ista, ali procijenjena nesigurnost znatno se mijenja.
Neovisna analiza koristi raspršenost među osobama, koja je ovdje velika. Uparena koristi raspršenost promjena unutar osoba, koja je manja. Budući da su iste osobe izmjerene dvaput, upareni postupak odgovara nacrtu istraživanja. Nacrt stoga određuje izbor postupka prije uvida u p-vrijednost.
Dobitak ovisi o varijanci razlika, a ona o raspršenosti obaju mjerenja i njihovoj povezanosti. Uz slične varijance veća pozitivna povezanost obično daje uži interval. Slaba povezanost daje manji dobitak, a pogrešno spojeni parovi mogu ga ukloniti. Parove zato određujemo prema identitetu jedinica i nacrtu.
Razlika skupina u linearnom modelu
Razliku dviju neovisnih skupina dosad smo dobivali oduzimanjem njihovih sredina. Istu procjenu možemo zapisati modelom koji svakoj osobi pridružuje sredinu njezine skupine. Za to je dovoljna oznaka nula ili jedan, a koeficijent uz nju postaje razlika sredina. Pritom čuvamo razliku među trima opisanim nacrtima i njihovim postupcima.
\[\text{povjerenje} = \beta_0 + \beta_1 \cdot \text{skupina} + \varepsilon\]
Oznaka \(\beta_0\) predstavlja očekivani ishod u polaznoj skupini, a \(\beta_1\) razliku druge skupine prema njoj. Oznaka \(\varepsilon\) obuhvaća odstupanje pojedine osobe od modela. Varijabla skupine ima vrijednost nula za polaznu i jedan za drugu skupinu.
Definicija 2 Referentna skupina je kategorija prema kojoj se izražavaju sve ostale kategorije istog prediktora, pa njezina sredina postaje polazna vrijednost modela, a koeficijenti ostalih kategorija odstupanja od nje.
Osobi iz referentne skupine model daje predviđanje \(\beta_0\), jer se koeficijent razlike množi nulom. Osobi iz druge daje \(\beta_0 + \beta_1\). Svi ljudi iste skupine dobivaju isti predviđeni prosjek, ali zadržavaju vlastite opažene odgovore i različite reziduale, odnosno razlike između opaženih i modelom predviđenih odgovora.
Kao referencu uzimamo društvene mreže. Zato \(\beta_0\) iznosi 4,51 i jednak je sredini te skupine. Koeficijent \(\beta_1\) iznosi 1,19 i jednak je prethodno izračunatoj razlici. Promjena reference mijenja odsječak i predznak koeficijenta, ali ostavlja iste procijenjene sredine skupina.
Jednouzoračni postupak uspoređuje sredinu s vanjskom vrijednošću, a upareni analizira sredinu razlika unutar parova. Svi postupci daju procjenu, nesigurnost i usporedbu s nulom, ali njihove pretpostavke nisu iste.
Uzročno tumačenje koeficijenta zahtijeva opravdanje iz nacrta i načina nastanka skupina. U našem primjeru ljudi sami biraju izvor vijesti, pa koeficijent opisuje razliku među njima.
Što razlika sama ne kaže
Model nam je dao drugi zapis iste razlike, ali još trebamo procijeniti njezin razmjer. Tu se vraćamo raspršenosti unutar skupina. Jedan bod predstavlja veće razdvajanje kada su odgovori zbijeni nego kada su široko raspršeni.
Standardiziranu razliku računamo dijeljenjem razlike sredina združenom standardnom devijacijom. Tako rezultat izražavamo u standardnim devijacijama, kako smo učinili u poglavlju o veličini učinka.
\[d = \frac{\bar{x}_2 - \bar{x}_1}{s_{\text{zdr}}}\]
Združena varijanca ponderirani je prosjek dviju varijanci, s težinama \(n_1-1\) i \(n_2-1\). Nakon korjenovanja dobivamo združenu standardnu devijaciju. Vraćamo se istom uzorku od 120 korisnika televizije i društvenih mreža. Za 70 korisnika mreža i 50 korisnika televizije račun iz nezaokruženih podataka daje 1,9957. Razlika sredina iznosi 1,1857, pa njihov omjer daje \(d\approx\) 0,5941, odnosno 0,59. Račun iz ranije tablice može se malo razlikovati jer su njezine standardne devijacije zaokružene.
Sadržajnu važnost procjenjujemo prema usporedivim nalazima i posljedicama razlike u izvornim jedinicama. U uparenom primjeru dijelimo standardnom devijacijom razlika i dobivamo 0,53. Budući da nazivnici nisu isti, te dvije standardizirane mjere nisu izravno usporedive.
Pri tumačenju standardizirane razlike trebamo razmotriti i ostala obilježja po kojima se skupine razlikuju. U našoj populaciji korisnici društvenih mreža imaju prosječno 33,4 godine, a korisnici televizije 50,2 godine. Povjerenje pritom raste s dobi. Dob je moguća konfundirajuća varijabla, u smislu objašnjenom u poglavlju o mjerenju i dizajnu.
Provjerimo zato osjetljivost usporedbe na dobni raspon. U cijeloj simuliranoj populaciji razlika iznosi 1,30 boda. Među osobama od trideset do četrdeset devet godina, gdje su dobne razlike skupina manje, iznosi 0,90 boda. Time smo promijenili ciljnu populaciju. Nismo izmjerili udio razlike koji je uzrokovan dobi niti odvojili uzročne učinke dobi i izvora vijesti.
U uzorku od 120 korisnika televizije i društvenih mreža tom dobnom rasponu pripada 55 od 120 osoba. Razlika sredina iznosi 0,77 boda. Interval ide od -0,34 do 1,88 i obuhvaća nulu. Ciljana razlika je manja, a zbog manjeg broja osoba procjena je manje precizna. Za planiranje uzorka potrebnog za takvu razliku koristimo znanje o snazi i preciznosti.
Zaključak vrijedi za ovdje korištene mjere i populaciju koju nacrt može dosegnuti. Za odluku trebamo i sadržajni kriterij. Interval od nepunih pola do gotovo dva boda može biti dovoljno informativan kada nas zanima bilo koja pozitivna razlika, a nedovoljan kada tražimo najmanje dva boda. Taj kriterij moramo obrazložiti prije čitanja rezultata.
Što se onda promijenilo nakon deaktivacije Facebooka? Objavljena analiza pokusa s početka poglavlja pokazala je porast subjektivne dobrobiti, uz smanjenje poznavanja činjenica iz vijesti (Allcott i sur. 2020.). Ista je intervencija, dakle, imala različite posljedice za dva ishoda do kojih nam može biti stalo. Savjet osobi koja razmatra prekid uporabe ovisio bi i o tome koji joj je ishod važniji te kako bi nadomjestila ono što gubi.
Allcott, Hunt, Luca Braghieri, Sarah Eichmeyer, i Matthew Gentzkow. 2020. „The Welfare Effects of Social Media“. American Economic Review 110 (3): 629–76. https://doi.org/10.1257/aer.20190658.
Procjena se odnosi na sudionike uključene u taj pokus i razdoblje deaktivacije, uz usporedbu omogućenu nasumičnom dodjelom (Allcott i sur. 2020.). Prosječna razlika ne obećava jednaku promjenu svakom korisniku. Za pitanje kome je korist bila najveća trebala bi unaprijed obrazložena usporedba učinaka među podskupinama i njezina nesigurnost. U našim simuliranim medijskim podacima korisnici su sami odabrali izvor vijesti. Zato dvije analize mogu obje uspoređivati sredine, a pružati različitu osnovu za zaključak o tome što bi promjena navike izazvala.
Pretpostavke i njihove granice
Za neovisnu usporedbu provjeravamo da jedinice nisu povezane i da svaka osoba pripada samo jednoj skupini. Ishod treba biti ispravno kodiran, referentna skupina jasno određena, a uzorkovanje primjereno ciljnoj populaciji. Te provjere određuju koliko se možemo pouzdati u rezultat odabranog testa.
U malim uzorcima t-aproksimacija ovisi o približnoj normalnosti ishoda unutar skupina. U velikima su važne konačne varijance i odsutnost opažanja koje samo određuje rezultat. Kod uparenog postupka pregledavamo raspodjelu razlika unutar parova.
Welchov postupak zasebno koristi varijancu i veličinu svake skupine te ne zahtijeva jednake varijance. Uobičajena inferencija običnog linearnog modela koristi zajedničku rezidualnu varijancu i pretpostavlja jednake uvjetne rezidualne varijance.
Budući da veličine i varijance naših skupina nisu jednake, koristimo Welchov postupak. Obični linearni model daje istu procjenu razlike, ali nesigurnost računa drukčije. U razrađenom primjeru usporedit ćemo standardne pogreške, stupnjeve slobode i intervale te jasno navesti pretpostavku zajedničke rezidualne varijance.
Raspodjelu najprije pregledavamo grafički. Test normalnosti ne treba sam određivati izbor analize. U velikom uzorku može otkriti nevažno odstupanje, a u malom propustiti ozbiljno. To vrijedi i za Shapiro-Wilkov test.
Krajnje vrijednosti pregledavamo pojedinačno. Mogu biti pogrešno unesene, rijetke ali stvarne ili znak da sredina loše opisuje ishod. Opravdanu provjeru s njima i bez njih treba prikazati s oba rezultata. Opažanja ne uklanjamo tiho prema tome kako mijenjaju p-vrijednost.
Možemo se pitati nose li zaključak velike brojčane udaljenosti ili dosljednost smjera promjene. Za tu provjeru koristimo Wilcoxonov postupak predznačenih rangova. Uzimamo iste promjene 60 osoba, poredamo njihove apsolutne iznose i vratimo svakom rangu predznak promjene. Prva osoba dobiva rang 41 i pozitivan predznak. Zatim uspoređujemo zbrojeve rangova pozitivnih i negativnih promjena. U ovom skupu nema nultih razlika ni vezanih rangova. Za tumačenje kao provjere središta promjena potrebno je i opravdanje simetričnosti njihove raspodjele.
Uz pretpostavku simetrične raspodjele postupak provjerava je li središte promjena jednako nuli. To nije isto pitanje kao provjera prosječne promjene. U našem primjeru daje p-vrijednost 0,0005. Zaključci su slični, ali odnose se na različite veličine.
Preklapanje crtica. Na grafu su dvije sredine i oko svake crtice pogreške. Čitatelj želi znati razlikuju li se skupine, pa pogleda dodiruju li se crtice. Takav brz postupak može djelovati uvjerljivo dok ne saznamo što crtice prikazuju i kako su mjerenja nastala. Ista slika ne mora predstavljati istu usporedbu.
Problem se pokazao i u istraživanju u kojem su grafove čitali autori znanstvenih radova. Internetski zadatak dovršila su 473 autora iz psihologije, bihevioralne neuroznanosti i medicine (Belia i sur. 2005.). Trebali su pomaknuti prikazane sredine do razlike koju smatraju upravo statistički značajnom (Belia i sur. 2005.). Mnogi nisu dovoljno razlikovali standardne pogreške od intervala pouzdanosti ni neovisne skupine od ponovljenih mjerenja (Belia i sur. 2005.).
Belia, Sarah, Fiona Fidler, Jennifer Williams, i Geoff Cumming. 2005. „Researchers Misunderstand Confidence Intervals and Standard Error Bars“. Psychological Methods 10 (4): 389–96. https://doi.org/10.1037/1082-989X.10.4.389.
Posljedicu možemo razmotriti na zamišljenoj procjeni radionice. Ako graf prikazuje rezultate istih polaznika prije i poslije radionice, zanima nas promjena svake osobe. Interval za tu promjenu ovisi i o povezanosti njezinih dvaju mjerenja. Odvojene crtice oko sredine prije i sredine poslije tu informaciju ne prenose. Zaključak da radionica nije povezana s promjenom, izveden samo iz preklapanja crtica, zato preskače potrebnu uparenu analizu.
Kod dviju neovisnih skupina trebamo drukčiji račun nesigurnosti razlike. I tu opis crtica prethodi zaključku. Standardna devijacija opisuje raspršenost opažanja, standardna pogreška nesigurnost procjene sredine, a interval pouzdanosti određen je postupkom s odabranom razinom pouzdanosti. Svaku oznaku zato čitamo prema njezinu imenovanom značenju.
Autor izvještaja može pomoći čitatelju tako da uz graf navede nacrt i značenje crtica te izravno prikaže procjenu razlike s njezinim intervalom. Ako je radionica procijenjena samo prije i poslije, ni dobro izračunata promjena sama ne isključuje druga objašnjenja. Prije zaključka o dvjema sredinama zato procjenjujemo nesigurnost njihove razlike. Preklapanje dvaju zasebnih raspona nije dovoljno.
Za izvještaj o televiziji i društvenim mrežama pregledajte usporedbu među osobama od 30 do 49 godina iz našeg simuliranog uzorka. Ishod je povjerenje u medije na ljestvici od jedan do deset, a razlika se računa kao televizija minus društvene mreže. Svaka osoba pripada jednoj skupini.
| Rezultat u dobnoj podskupini | Vrijednost |
|---|---|
| Ukupan broj osoba | 55 |
| Procijenjena razlika sredina | 0,77 boda |
| Welchov 95-postotni interval razlike | od −0,34 do 1,88 boda |
Asistentov osvrt na postupak i rezultat glasi ovako.
Jedinica neovisnosti je osoba. Referentna skupina su društvene mreže, pa pozitivan koeficijent uz TV znači višu sredinu u TV skupini. Raspodjele i neobična opažanja pregledani su, a Welchov test ne traži jednake varijance. Interval razlike obuhvaća nulu, pa u toj dobnoj skupini glavni izvor vijesti nema veze s povjerenjem.
Uz nulu navedite još dvije različite vrijednosti razlike koje pripadaju prikazanom intervalu. Upotrijebite ih u obrazloženju je li posljednja rečenica prihvatljiva. Zatim napišite zamjenu koja zadržava smjer usporedbe, procjenu i granice intervala, bez odbacivanja valjanih provjera postupka.
Razrađeni primjer
U uzorku od 120 korisnika televizije i društvenih mreža zadržavamo iste osobe, isto povjerenje i istu ciljanu razliku. Najprije ćemo je procijeniti Welchovim postupkom, a zatim zapisati kao koeficijent uz binarnu oznaku skupine. Budući da se točkasta procjena time ne mijenja, možemo se usredotočiti na pretpostavke i račun njezine nesigurnosti.
U tablici uspoređujemo procjenu i njezin interval prije čitanja programskog računa. Sve su vrijednosti u bodovima povjerenja, a stupci Donja i Gornja granice su 95-postotnog intervala. Razlika je u oba retka televizija minus društvene mreže. Za glavni zaključak zadržavamo Welchov postupak, dok drugi redak pokazuje što se mijenja kada model pretpostavi zajedničku rezidualnu varijancu.
| Postupak | Razlika | SE | df | Donja | Gornja |
|---|---|---|---|---|---|
| Welch | 1,186 | 0,373 | 102,471 | 0,447 | 1,925 |
| Linearni model | 1,186 | 0,370 | 118,000 | 0,454 | 1,917 |
U izvještaju možemo navesti da u uzorku od 120 korisnika televizije i društvenih mreža korisnici televizije imaju prosječno 1,19 boda više povjerenja od korisnika društvenih mreža, uz Welchov 95-postotni interval od 0,45 do 1,92 boda. To je razlika među skupinama koje same biraju izvor vijesti. Nije procjena promjene povjerenja koju bi izazvalo prebacivanje iste osobe na televiziju. Cijeli interval ostaje ispod dva boda, pa podaci ne podupiru odluku koja zahtijeva najmanje toliku razliku.
Welchov postupak daje razliku 1,186 boda, standardnu pogrešku 0,373 i 102,471 stupnja slobode. Koeficijent uz TV jednak je toj razlici jer su društvene mreže referenca. Obična standardna pogreška modela iznosi 0,370, uz 118 stupnjeva slobode. Njegov interval ide od 0,454 do 1,917, dok Welchov ide od 0,447 do 1,925. Procjene su jednake, ali njihova nesigurnost nije. Ovdje su intervali bliski jer su skupne standardne devijacije slične. Uz izrazito različite varijance i brojnosti razlika u standardnim pogreškama može biti mnogo veća. I pri proširenju na više skupina moramo zasebno odabrati način računanja nesigurnosti.
Uz brojke navodimo da ljudi sami biraju izvor vijesti i da se skupine razlikuju po dobi. Time čitatelju objašnjavamo zašto rezultat opisuje razliku među skupinama i ne utvrđuje učinak medija.
Za provjeru računa slijedi isti postupak u R-u. Prvi prolaz kroz primjer može završiti prethodnim tumačenjem. Ovdje provjeravamo kako program dobiva procjenu i zašto se njegova dva intervala razlikuju.
Prikaži kod
tv <- filter(dvije_skupine, izvor == "TV") |> pull(povjerenje_medijima)
mreze <- filter(dvije_skupine, izvor == "društvene mreže") |> pull(povjerenje_medijima)
welch <- t.test(tv, mreze)
model <- lm(povjerenje_medijima ~ izvor, data = dvije_skupine)

welch
coef(model)
summary(model)$coefficients["izvorTV", ]
df.residual(model)
confint(model)["izvorTV", ]
Oba računa uspoređuju isto povjerenje u istim skupinama. Poziv t.test prima njihove vrijednosti odvojeno i u zadanoj postavci provodi Welchov postupak. U pozivu lm zapis povjerenje_medijima ~ izvor povezuje brojčani ishod s oznakom skupine. Uobičajeni ispis toga modela računa nesigurnost uz pretpostavku jednake rezidualne varijance u skupinama, odnosno homoskedastičnosti. Pozivom df.residual izdvajamo i rezidualne stupnjeve slobode kako bismo mogli usporediti način računanja intervala. Kod je izvadak iz analize poglavlja i pretpostavlja već pripremljen objekt dvije_skupine. Vrijednost welch$stderr daje Welchovu standardnu pogrešku.
Sažetak
Ista brojčana razlika može potjecati iz različitih nacrta, pa usporedbu počinjemo jedinicom neovisnosti i odnosom među mjerenjima. Tako razlikujemo jednouzoračni, neovisni i upareni postupak te vidimo zašto zanemarivanje parova može znatno promijeniti procijenjenu nesigurnost. Razliku neovisnih sredina možemo zapisati i koeficijentom uz binarnu oznaku skupine, ali jednak koeficijent ne jamči jednak interval u Welchovu i običnom postupku najmanjih kvadrata (OLS). Standardizirana razlika pomaže usporediti razmjer, dok druga obilježja po kojima se skupine razlikuju i dalje ograničavaju tumačenje. U sljedećem poglavlju isti model proširujemo na više skupina, pa ćemo uz pojedinu razliku morati razmotriti i cijeli skup usporedbi.
Prediktor je varijabla kojom model opisuje razlike u ishodu. Homoskedastičnost označuje jednaku rezidualnu varijancu, pretpostavku obične modelne standardne pogreške o kojoj smo govorili uz usporedbu s Welchovim postupkom.
Pojmovi
- homoskedastičnost
- homoskedasticity
- Wilcoxonov postupak predznačenih rangova
- Wilcoxon signed-rank test
- prediktor
- predictor
- jedinica neovisnosti
- unit of independence
- neovisne skupine
- independent groups
- upareni podaci
- paired data
- razlika sredina
- difference in means
- Welchov postupak
- Welch’s t-test
- t-raspodjela
- t distribution
- kritična t-vrijednost
- critical t value
- stupnjevi slobode
- degrees of freedom
- referentna skupina
- reference category
- standardizirana razlika
- Cohen’s d
- ovisnost opažanja
- dependence among observations
Zadaci
Nakon vlastitog pokušaja otvorite naznake i provjere rješenja.
Konceptualni
Za tri istraživačke situacije imenujte jedinicu neovisnosti i odgovarajući dizajn. Prva uspoređuje prosječno povjerenje u uzorku s unaprijed zadanim pragom od pet bodova, druga uspoređuje dvije skupine prema primarnom izvoru vijesti, a treća mjeri iste ispitanike prije i poslije kampanje.
Računski
Iz upravljanoga agregata data/populacija-medija-agregat.csv uzmite retke za TV i društvene mreže. Za svaki redak podijelite zbroj_povjerenja stupcem broj, provjerite pohranjeni prosjek i izračunajte razliku aritmetičkih sredina. Zatim pretpostavite jednake standardne devijacije 1,6 pa 3,2 i za obje izračunajte standardiziranu razliku. Objasnite zašto se prva brojka nije promijenila, a druga jest. Za rad bez datoteke upotrijebite izvadak iz istoga agregata.
| Izvor | Broj | Zbroj povjerenja | Pohranjeni prosjek |
|---|---|---|---|
| društvene mreže | 13378 | 54432 | 4,068770 |
| TV | 10827 | 58098 | 5,366029 |
Kritički
Vratite se operacionalizaciji iz poglavlja o mjerenju i istraživačkom dizajnu i tumačenju intervala iz poglavlja o procjeni. Za glavni primjer najprije napišite što ljestvica povjerenja i kategorija izvora vijesti ne mjere. Zatim za isti interval usporedite odluku kojoj je važna bilo koja pozitivna razlika s odlukom koja traži najmanje dva boda. Predajte kratku bilješku recenzentu i objasnite zašto sama oznaka značajnosti ne može riješiti ni problem mjerenja ni izbor praga (Cumming 2014.).
Cumming, Geoff. 2014. „The New Statistics: Why and How“. Psychological Science 25 (1): 7–29. https://doi.org/10.1177/0956797613504966.
Revizija modela
Ocijenite usporedbu dviju skupina iz okvira. Imenujte referentnu skupinu i objasnite što bi se promijenilo, a što ostalo isto kada bi se referenca zamijenila. Zatim provjerite jedinicu neovisnosti, vrstu ishoda, odnos prema varijancama i doseg ciljne populacije. Izdvojite jedinu tvrdnju koja iz rezultata ne slijedi i napišite rečenicu kojom bi je trebalo zamijeniti.