Povezanost
Sažetak odnosa bez cijele slike
Zamislimo večer u kojoj se nakon duljeg pregledavanja objava osjećamo lošije nego prije. Možda nas je uznemirio sadržaj. Možda smo već bili neraspoloženi pa smo zato ostali uz ekran. Kad bismo pitali prijatelje koliko vremena provode uz digitalne medije i kako se osjećaju, bismo li iz njihovih odgovora mogli razlučiti što se događa?
Analiza triju velikih skupova podataka o adolescentima povezala je uporabu digitalne tehnologije s pokazateljima njihove psihološke dobrobiti. Istraživači su usporedili niz opravdanih analitičkih izbora, uključujući različite mjere i varijable uključene u račun (Orben i Przybylski 2019.). Jedno široko pitanje tako je postalo skup konkretnih usporedbi, od kojih svaka nešto zadržava, a nešto izostavlja.
Što nam povezanost vremena uz tehnologiju i dobrobiti može reći o adolescentima, a što bismo još trebali znati da nekome savjetujemo promjenu navike?
Sada kada znamo pročitati raspršeni dijagram, možemo preciznije pitati kako se dvije varijable mijenjaju zajedno. U dosadašnjim smo sažecima dnevne minute i dob često promatrali odvojeno. Zanima nas i njihov odnos. Želimo ga opisati usporedivim brojem, a pritom sačuvati ono što smo iz grafova naučili o zakrivljenosti, podskupinama i izdvojenim opažanjima.
Glavni primjer ostaju isti zapisi iz simulirane ankete anketa_mreze, koje smo sažimali i prikazivali grafovima. Jedan redak predstavlja jednu zamišljenu osobu, pa njezinu dob povezujemo s njezinim dnevnim vremenom na društvenim mrežama. Za pregled više parova uključit ćemo i povjerenje u sadržaj. Podaci su konstruirani za nastavu. Na njima učimo opisivati odnos, bez zaključka o stvarnim navikama ili o tome što bi promjena vremena na mrežama izazvala.
Mjeru zajedničkog kretanja gradimo od odstupanja od sredine i standardizacije, koje već poznajemo. Pearsonova korelacija sažima linearnu vezu, a Spearmanov koeficijent polazi od poretka vrijednosti. Izdvojena točka, uži raspon dobi ili spajanje podskupina mogu promijeniti koeficijent i njegov smisao. Usporedbom tih slučajeva vraćamo se problemu zbirne slike iz Berkeleyjskog slučaja, sada s dvjema brojčanim varijablama.
Provjeru ćemo proširiti na stvarne Eurostatove pokazatelje obrazovanja i uporabe interneta, gdje jedinica postaje država umjesto osobe (Eurostat 2026.d, 2026.c). Ta promjena određuje što povezanost smije značiti. Uočen odnos među državama nećemo pripisati njihovim pojedinim stanovnicima. Prikladnost koeficijenta provjeravamo uz graf i opis odabranih jedinica. Tako vidimo koliko dobro sažima odnos i što izostavlja. Za pitanje o uzroku trebamo odgovarajući nacrt i dodatne podatke, a počinjemo pregledom oblika odnosa koji već vidimo.
Zajedničko kretanje
Dvije su varijable povezane kada se vrijednosti jedne razlikuju ovisno o vrijednostima druge. Pri pozitivnoj vezi veće vrijednosti jedne češće dolaze uz veće vrijednosti druge. Pri negativnoj dolaze uz manje vrijednosti druge. Koeficijent blizu nule može značiti slabu linearnu vezu, ali pritom može postojati zakrivljen odnos.
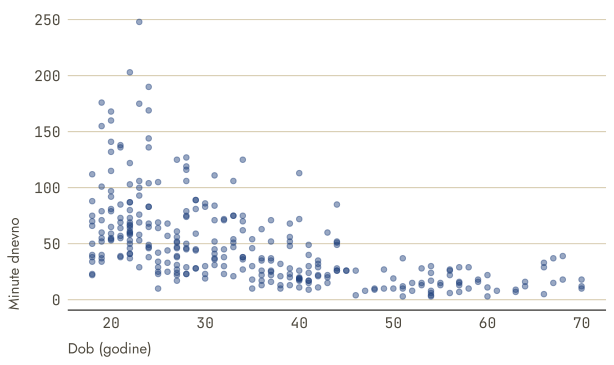
Na grafu dobi i dnevnih minuta iz ankete anketa_mreze svaka točka povezuje vrijednosti iste zamišljene osobe. Točke tvore silazni oblak. Pad je strmiji među mlađima i poslije se izravnava. Graf nam pokazuje taj oblik prije računanja koeficijenta.
Najprije uspoređujemo na koju stranu od prosjeka odstupa svaki ispitanik u objema varijablama. U poznatoj tablici simulirane ankete anketa_mreze s 300 ispitanika, 27 % odstupa na istu stranu u dobi i dnevnim minutama. Uz simetrične raspodjele i neovisna odstupanja očekivali bismo udio blizu polovine. Asimetrija ga može promijeniti i bez povezanosti, pa sam udio nije mjera veze. U ovom primjeru češća su odstupanja na suprotne strane, što odgovara negativnom obrascu na grafu. Za jačinu veze trebamo uz smjer uzeti u obzir i veličinu odstupanja.
Zato za svaku osobu množimo odstupanja od dviju sredina. Umnožak je pozitivan ako oba odstupanja imaju isti predznak, a negativan ako imaju suprotne. Velika odstupanja pridonose više od malih. Zbrajanjem tih umnožaka i dijeljenjem dobivamo mjeru zajedničkog kretanja.
Definicija 1 Kovarijanca uzorka je zbroj umnožaka odstupanja dviju varijabli od njihovih sredina, podijeljen brojem opažanja umanjenim za jedan. Pozitivan predznak upućuje na prevladavanje odstupanja u istom smjeru, a negativan u suprotnom.
Zapisano simbolima, gdje \(x_i\) i \(y_i\) označavaju vrijednosti izmjerene kod istog opažanja, \(\bar{x}\) i \(\bar{y}\) njihove sredine, a \(n\) broj opažanja, kovarijanca glasi
\[\operatorname{Cov}(x, y) = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}).\]
Djelitelj \(n-1\) isti je onaj iz poglavlja o sažimanju podataka, a formula je poopćenje varijance, jer varijanca nastaje kada se ista varijabla stavi na oba mjesta.
Za provjeru računa potrebne su obje sredine i standardne devijacije. U anketi je sredina dobi 34,517, a njezina standardna devijacija 13,384 godina. Za dnevne minute odgovarajuće vrijednosti iznose 50,063 i 39,157. Račun u nastavku koristi nezaokružene vrijednosti. Prikaz na tri decimale služi ručnoj približnoj provjeri.
Na prvoj osobi iz poznate ankete možemo pregledati jedan član zbroja. Dob je 22, a vrijeme 69 minuta. Odstupanja od dviju sredina iznose -12,52 godina i 18,94 minuta. Njihov je umnožak -237,02. Račun ponavljamo na svih 300 parova, zbrajamo umnoške i dijelimo s 299. Svi su parovi potpuni, a dob jedne osobe uvijek ostaje uz njezine minute.
Veličina kovarijance ovisi o mjernim jedinicama. Za dob i dnevne minute ovdje iznosi -293,1. Ako iste minute pretvorimo u sate, dobivamo -4,9, šezdeset puta drukčiju vrijednost. Odnos je ostao isti. Kovarijancu zato moramo čitati uz jedinice i ne možemo njome izravno uspoređivati parove mjerene različitim jedinicama.
Za usporedbu različitih parova potrebna nam je mjera neovisna o jedinicama.
Od standardizacije do matrice
Standardizacijom vrijednosti pretvaramo u broj standardnih devijacija od sredine. Ako to učinimo s objema varijablama prije množenja, račun daje jednak rezultat za vrijeme izraženo u minutama i u satima.
Definicija 2 Pearsonova korelacija uzorka jest zbroj umnožaka uzorački standardiziranih vrijednosti dviju varijabli, podijeljen s \(n-1\). Mjeri smjer i jačinu njihove linearne veze na ljestvici od \(-1\) do \(+1\), neovisno o mjernim jedinicama.
Uzoračku korelaciju označujemo s \(r\), a populacijsku s \(\rho\). Standardizirane vrijednosti opažanja \(i\) jesu \(z_{x_i}\) i \(z_{y_i}\), dok su \(s_x\) i \(s_y\) uzoračke standardne devijacije. Korelaciju možemo zapisati na dva jednaka načina
\[r = \frac{1}{n-1} \sum_{i=1}^{n} z_{x_i} \, z_{y_i} = \frac{\operatorname{Cov}(x, y)}{s_x \, s_y},\]
Dva zapisa daju isti broj. U prvome standardiziramo prije množenja, a u drugome kovarijancu dijelimo standardnim devijacijama. Računamo isto, samo drugim redoslijedom.
Nakon standardizacije prva osoba ima \(z_x = -0,94\) i \(z_y = 0,48\), pa u zbroj ulazi njihov umnožak -0,452. Svih 300 takvih umnožaka opet dijelimo s 299, jer smo standardizirali uzoračkim standardnim devijacijama.
U anketi račun preko standardiziranih vrijednosti daje -0,559, a ugrađeni izračun korelacije -0,559. Ako umjesto minuta koristimo sate, rezultat ostaje -0,559. Kovarijanca se pri toj promjeni jedinice promijenila šezdeset puta, a korelacija ostaje ista.
Kada je korelacija \(+1\), sve točke leže na uzlaznom pravcu, a pri \(-1\) na silaznom. Vrijednost nula znači da nema linearne veze. Međuvrijednosti opisuju koliko raspored točaka prati pravac. Nagib pravca odgovara na zasebno pitanje, za koliko se minuta vrijeme korištenja mijenja uz jednu godinu dobi. Uz korelaciju -0,56 za taj ćemo opis trebati i regresiju.
Kao gruba orijentacija u društvenim znanostima često se navode korelacije oko 0,10, 0,30 i 0,50 za male, srednje i velike odnose (Cohen 1988.). Te su vrijednosti predložene za situacije u kojima nemamo bolju osnovu u poznavanju područja (Cohen 1988.). Važnost koeficijenta zato procjenjujemo prema pojavi, načinu mjerenja, posljedicama i nalazima usporedivih istraživanja.
Cohen, Jacob. 1988. Statistical Power Analysis for the Behavioral Sciences. 2. izd. Lawrence Erlbaum Associates.
U jednostavnom linearnom opisu kvadrat korelacije pokazuje udio varijance povezan s tim opisom. Za korelaciju -0,56 to je 31 % varijance. Preostalih 69 % linearni opis ne obuhvaća. Primjerice, korelacija 0,30 daje devet posto. U poglavlju o regresiji tu ćemo veličinu koristiti za opis prilagodbe modela.
Uz veličinu veze treba procijeniti nesigurnost. Korelacija iz uzorka može odstupati od populacijske, a uz isti nacrt i usporedive neovisne jedinice veći uzorak obično daje precizniju procjenu. Vrijednost 0,40 na trideset i na tri tisuće osoba zato nema jednaku nesigurnost. Uz koeficijent uvijek navodimo broj opažanja, a račun nesigurnosti slijedi u poglavljima o uzorkovanju i procjeni.
U poznatoj anketi uz dob i dnevne minute imamo i povjerenje, pa možemo promatrati više odnosa. Umjesto da koeficijente zapisujemo odvojeno, slažemo ih u matricu u kojoj svaki redak i stupac pripada jednoj varijabli. Isti se par pojavljuje s obje strane dijagonale, pa je matrica simetrična. Na dijagonali su jedinice jer je svaka varijabla savršeno povezana sama sa sobom.
| dob | minute_dnevno | povjerenje | |
|---|---|---|---|
| dob | 1,00 | -0,56 | -0,33 |
| minute_dnevno | -0,56 | 1,00 | 0,18 |
| povjerenje | -0,33 | 0,18 | 1,00 |
Matrica, kodovi i rangovi
Matrica olakšava pregled, ali i traženje slučajno velikih koeficijenata. Tri varijable daju tri para, a deset ih daje četrdeset pet. Hipoteza nastala traženjem najvećeg broja ima istraživački status, različit od hipoteze postavljene prije pregleda rezultata. Posljedice za testiranje razmotrit ćemo u poglavlju o krizi i obnovi. Svaki par koji namjeravamo tumačiti najprije prikazujemo raspršenim dijagramom.
U usporedbu možemo uključiti i tekst pretvoren u brojčanu varijablu kodiranjem, uz pravila mjerenja koja smo već upoznali. Kodirana kategorija teksta ovisi o pravilu koje smo odabrali. Za šest namjerno izabranih naslova iz poglavlja o vizualizaciji dodjeljujemo jedan ako naslov sadržava graphs, graphical ili graphics, a inače nulu. Pet naslova dobiva jedan, a jedan nulu. Korelacija s godinom iznosi -0,05 (Anscombe 1973.; Cleveland i McGill 1984.; Tufte 2001.; Wilkinson 2005.; Wickham 2016.; Matejka i Fitzmaurice 2017.). Taj rezultat opisuje samo izabrane naslove i ne pokazuje opću promjenu znanstvenih naslova kroz vrijeme.
Anscombe, F. J. 1973. „Graphs in Statistical Analysis“. The American Statistician 27 (1): 17–21. https://doi.org/10.1080/00031305.1973.10478966.
Cleveland, William S., i Robert McGill. 1984. „Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods“. Journal of the American Statistical Association 79 (387): 531–54. https://doi.org/10.1080/01621459.1984.10478080.
Tufte, Edward R. 2001. The Visual Display of Quantitative Information. 2. izd. Graphics Press.
Wilkinson, Leland. 2005. The Grammar of Graphics. 2. izd. Springer. https://doi.org/10.1007/0-387-28695-0.
Wickham, Hadley. 2016. ggplot2: Elegant Graphics for Data Analysis. 2. izd. Springer. https://doi.org/10.1007/978-3-319-24277-4.
Matejka, Justin, i George Fitzmaurice. 2017. „Same Stats, Different Graphs“. Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems, 1290–94. https://doi.org/10.1145/3025453.3025912.
Ako pravilu dodamo oblik visual, svih šest naslova dobiva jedan i korelacija se više ne može izračunati jer nema razlika u kodu (Anscombe 1973.; Cleveland i McGill 1984.; Tufte 2001.; Wilkinson 2005.; Wickham 2016.; Matejka i Fitzmaurice 2017.). Tekstovi su isti, a mjera se promijenila. Autor poglavlja sastavio je pravilo za potrebe ovog primjera. Zato uz kod navodimo pravilo, osobu koja ga je odredila i tekstove na koje je primijenjen. Kasnije ćemo takve kategorije proučavati u tablicama i razmotriti što se mijenja kada ih dodjeljuje algoritam.
Izbor brojčanog prikaza važan je i kada izvorno imamo brojčana mjerenja. Pearsonova korelacija koristi njihove razmake i sažima linearnu vezu. No dob i minute u našoj anketi mogu se dosljedno kretati u suprotnim smjerovima, a da ne prate pravac. Ako želimo opisati tu dosljednost poretka, trebamo mjeru koja neće tražiti jednake promjene kroz cijeli raspon.
Vrijednosti zamjenjujemo rangovima. Najmanja dobiva prvi rang, sljedeća drugi, a jednake dijele prosječni rang. Zatim na rangovima računamo Pearsonovu korelaciju. Spearmanov koeficijent ranga, označen s \(r_s\), tako mjeri dosljednost kretanja u jednom smjeru, odnosno monotonu vezu. Naziva se i Spearmanovom korelacijom. Rangovi čuvaju poredak, ali ne i izvorne razmake.
Pravilo za vezane rangove možemo vidjeti na namjerno zadanom nizu 10, 20, 20, 50. Rangovi su 1, 2,5, 2,5 i 4. Dvije dvadesetice dijele prosjek drugoga i trećega mjesta. U anketi tako zasebno rangiramo svih 300 dobi i svih 300 vremena, pa povezujemo rangove koji pripadaju istoj osobi.
Na grafu dobi i minuta vidjeli smo strmiji pad među mlađima i izravnavanje poslije, bez odvojene podskupine koja sama stvara odnos. Uz taj graf uspoređujemo Pearsonovu korelaciju -0,56 i Spearmanovu -0,68. Razlika odgovara vidljivoj zakrivljenosti, ali sama je ne bi dokazala. Pearsonova korelacija dobi i logaritma minuta iznosi -0,68 i bliža je Spearmanovoj. To je dodatna provjera ovog simuliranog odnosa, bez općeg pravila za izbor mjere.
Utjecajno opažanje je opažanje čije uključivanje ili uklanjanje znatno mijenja koeficijent. Ne mora svaka krajnja vrijednost biti utjecajna.
Sličnost Pearsonova i Spearmanova koeficijenta može odgovarati približno pravocrtnoj monotonoj vezi, ali ne jamči takav oblik ni otpornost nalaza. Oba koeficijenta može pomaknuti isti neobičan raspored. Njihova razlika također nema jedno objašnjenje. Može nastati zbog zakrivljenosti, utjecajnih točaka, vezanih rangova, podskupina ili suženog raspona. Zato najprije pregledavamo graf i način odabira podataka. Sama razlika nije dovoljan razlog da odaberemo Spearmanovu mjeru.
Ako veza nije monotona, oba koeficijenta mogu biti blizu nule. Zadovoljstvo, primjerice, može biti nisko pri vrlo malom i vrlo velikom opterećenju. Uzlazni i silazni dio tada se u koeficijentu poništavaju, iako graf pokazuje odnos.
Ograničenje raspona i odabir
Uz izbor koeficijenta važno je razmotriti i izbor opažanja jer oba utječu na opis povezanosti. U približno linearnoj vezi sa sličnom raspršenošću ishoda, odabir prema užem rasponu jedne varijable često smanjuje apsolutnu korelaciju. Raspon koji nosi signal postaje manji, dok preostalo rasipanje može ostati slično.
Definicija 3 Ograničenje raspona (range restriction) nastaje kada promatrani uzorak pokriva samo dio mogućih vrijednosti jedne ili obiju varijabli. Ono može oslabiti izmjerenu povezanost, ali smjer promjene ovisi o obliku odnosa i pravilu odabira.
Za čist prikaz slabljenja konstruirajmo 27 parova. Svaku vrijednost x od jedan do devet ponovimo triput, a y dobijemo dodavanjem −2, 0 i 2. Unutar svake vrijednosti x rasipanje je zato isto. Potom zadržimo samo x od četiri do šest. Tako sužavamo raspon uz očuvano pravilo nastanka y.
| Uzorak | n | Najmanji x | Najveći x | r |
|---|---|---|---|---|
| Cijeli raspon | 27 | 1 | 9 | 0,845 |
| Od 4 do 6 | 9 | 4 | 6 | 0,447 |
Manji raspon x uz isto rasipanje oko pravca daje slabiju korelaciju. Sužavanje raspona ne mora uvijek smanjiti koeficijent. U zakrivljenoj vezi možemo izdvojiti dio koji bolje ili slabije prati pravac. Ako odabir ovisi o objema varijablama ili povezanoj trećoj, može se promijeniti i predznak. Zato uspoređujemo grafove prije i nakon odabira te provjeravamo pravilo uključivanja.
U cijeloj simuliranoj anketi korelacija dobi i minuta je -0,56. Najmlađa skupina ima 90 osoba sa sedam različitih dobi, od 18 do 24 godine. Njezina korelacija iznosi 0,18 i ima drugi predznak. To se ne može tumačiti samo kao slabljenje iste linearne veze. Generator razlikuje dobne skupine, ali unutar najmlađe minute ne ovise o točnoj dobi. Populacijska korelacija unutar nje zato je nula, a opaženih 0,18 proizlazi iz promjenjivosti uzorka od 90 osoba.
Nalaz za najmlađu skupinu i veza u cijelom skupu odgovaraju na pitanja različitog obuhvata. Slično, istraživanje jedne studentske generacije opisuje uzak raspon dobi, dok zaključak o cijeloj odrasloj populaciji traži širi obuhvat. Za primljene kandidate, zaposlene radnike ili preživjela poduzeća trebamo provjeriti kako je odabir promijenio raspon, oblik i sastav opažanja.
U primjeru dobivamo koeficijent različit od nule iako je populacijska korelacija unutar skupine nula. U usporedivim uvjetima takva su odstupanja češća u manjim uzorcima. Na koeficijent može snažno utjecati i jedna udaljena točka jer mijenja sredine, standardne devijacije i zajednička odstupanja. Zato uz broj opažanja pregledavamo graf, podskupine i način odabira.
Podskupine i obrat predznaka
Odabirom jedne dobne skupine promijenili smo odnos koji opisujemo. Sada ispitujemo obrnut potez, spajanje različitih skupina u jedan prikaz. Kada podskupine imaju različite razine obiju varijabli, zbirna korelacija može imati suprotan predznak od korelacija unutar podskupina.
To ćemo prikazati konstruiranim podacima o trima odjelima, bez tvrdnje o stvarnoj organizaciji. Unutar svakog odjela zadovoljstvo blago opada sa stažem. Odjeli s iskusnijim zaposlenicima ipak imaju više prosječno zadovoljstvo.
Za svaki odjel generirali smo 60 osoba. Staž je jednoliko raspoređen od 2 do 7 godina u A, od 7 do 12 u B i od 12 do 17 u C. U sredini tih raspona zadovoljstvu zadajemo 3,6, 5,7 i 7,7. Za svaku godinu iznad sredine odjela oduzimamo 0,42 i dodajemo neovisno normalno odstupanje standardne devijacije 0,5. Tako odjel istodobno određuje polazišta staža i zadovoljstva. Zadovoljstvo je ovdje konstruirana kontinuirana vrijednost bez unaprijed ograničenog raspona, a ne odgovor na stvarnu anketnu ljestvicu. Četiri polja sljedećeg grafa pregrupiraju istih 180 generiranih zapisa.
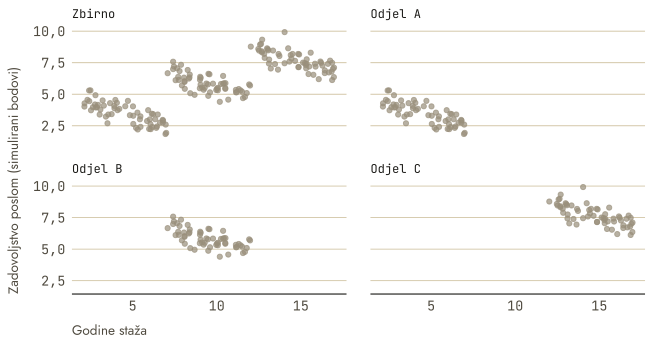
Zbirna korelacija staža i zadovoljstva je pozitivna, 0,76. Unutar odjela iznosi -0,77, -0,66 i -0,71, pa su sve tri negativne. Svaki je račun točan. Zbirni rezultat uključuje i razlike među odjelima, koje su ovdje dovoljno velike da odrede pozitivan predznak.
To je pojava koju je Simpson opisao na frekvencijskim tablicama (Simpson 1951.). Već smo je susreli u Berkeleyjskim stopama prijma, gdje se zbirna razlika promijenila nakon razdvajanja odjela (Bickel i sur. 1975.). Grafovima po skupinama možemo odvojiti razlike među skupinama od odnosa unutar njih.
Simpson, E. H. 1951. „The Interpretation of Interaction in Contingency Tables“. Journal of the Royal Statistical Society, Series B 13 (2): 238–41. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x.
Bickel, P. J., E. A. Hammel, i J. W. O’Connell. 1975. „Sex Bias in Graduate Admissions: Data from Berkeley“. Science 187 (4175): 398–404. https://doi.org/10.1126/science.187.4175.398.
Poseban problem nastaje kada iz korelacije među skupinama zaključujemo o pojedincima. Zemlje, županije ili škole često su dostupne samo kao agregati. Njihovom korelacijom ne dobivamo odnos među ljudima unutar njih. Agregiranje uklanja dio unutarnjih razlika pa koeficijent može biti drukčiji, jači ili drugog smjera. Zaključivanje o pojedincima iz takvih odnosa nazivamo ekološkom pogreškom (ecological fallacy). Za individualni zaključak trebamo podatke i dizajn na individualnoj razini. Odnos među zemljama ostaje nalaz o zemljama.
Država kao jedinica
Na objavljenim pokazateljima možemo provjeriti kako promjena jedinice ograničava tumačenje povezanosti. S pojedinačnih osoba sada prelazimo na države. Eurostat, statistički ured Europske unije, objavljuje pokazatelje kojima uspoređujemo obrazovanje, zaposlenost, siromaštvo, uporabu interneta i dobnu strukturu stanovništva (Eurostat 2026.b, 2026.e, 2026.d, 2026.a, 2026.c, 2026.f). Analiza se ovdje oslanja na objavljene vrijednosti. U izvornoj tablici jedan redak pripada jednom pokazatelju za jednu državu i godinu. Kada pokazatelje spojimo za graf, jedna točka predstavlja državu.
Za Hrvatsku i Francusku u nastavku vidimo po dva izvorna retka. Obrazovanje se odnosi na osobe od 25 do 34 godine, a uporaba interneta na osobe od 16 do 74 godine (Eurostat 2026.d, 2026.c). Povezivanjem redaka iste države dobivamo par vrijednosti za jednu točku na grafu.
| Država | Pokazatelj | Udio (%) |
|---|---|---|
| Francuska | Tercijarno obrazovanje, 25–34 | 55,8 |
| Francuska | Uporaba interneta, 16–74 | 95,0 |
| Hrvatska | Tercijarno obrazovanje, 25–34 | 42,0 |
| Hrvatska | Uporaba interneta, 16–74 | 85,9 |
U tablici su udjeli za čitanje zaokruženi na jednu decimalu. Za graf i izračun povezanosti zadržavamo izvorne brojčane vrijednosti.
Eurostatov izvadak sadržava šest pokazatelja za 27 članica EU-a u 2025., odnosno 162 kombinacije država + godina + pokazatelj i 161 brojčanu vrijednost (Eurostat 2026.b, 2026.e, 2026.d, 2026.a, 2026.c, 2026.f). Nedostaje samo rano napuštanje obrazovanja za Luksemburg (Eurostat 2026.a). Zadržan je zapis : s izvornom oznakom u za nisku pouzdanost, bez oznake povjerljivosti (Eurostat 2026.a). Ne zamjenjujemo ga nulom ni vrijednošću druge godine.
Oznaka kvalitete razlikuje se od nedostajuće vrijednosti. Hrvatska vrijednost ranog napuštanja obrazovanja iznosi 2,1 i također nosi u, ali je objavljena kao broj (Eurostat 2026.a). Oznaku b, koja bilježi prekid vremenske serije, također čuvamo (Eurostat 2026.e, 2026.a). Analiza ipak ostaje presjek jedne godine.
| Oznaka | Značenje | Redaka |
|---|---|---|
| nema | bez objavljene oznake | 150 |
| b | prekid u vremenskoj seriji | 2 |
| d | različita definicija; vidjeti metapodatke | 4 |
| e | procijenjena vrijednost | 1 |
| ep | procijenjena i privremena vrijednost | 1 |
| p | privremena vrijednost | 2 |
| u | niska pouzdanost | 2 |
Za ilustraciju biramo tercijarno obrazovanje i uporabu interneta jer nas zanima odnos obrazovnog i digitalnog sudjelovanja, a oba pokazatelja pokrivaju EU-27 (Eurostat 2026.d, 2026.c). To je istraživački izbor, bez unaprijed registrirane hipoteze. Prvi pokazuje udio osoba od 25 do 34 godine s tercijarnim obrazovanjem, a drugi udio osoba od 16 do 74 godine koje su koristile internet u prethodna tri mjeseca (Eurostat 2026.d, 2026.c). Svaka točka predstavlja državu. Veličina joj prikazuje udio stanovništva od 65 godina naviše, a oblik čuva izvornu oznaku uz taj pokazatelj. Tako prije koeficijenta vidimo odnos i moguću ulogu dobnog sastava.
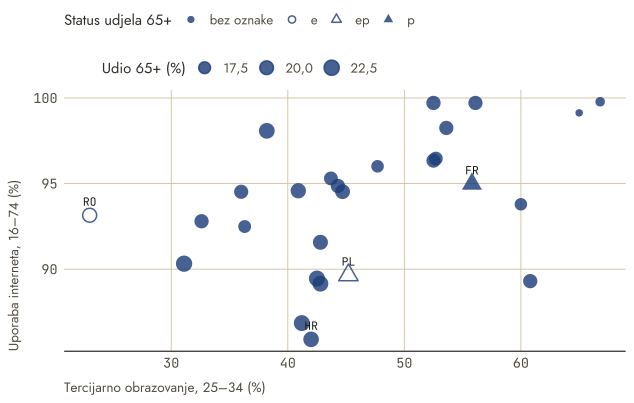
Za 27 država Pearsonova korelacija iznosi 0,45, a Spearmanova 0,51 (Eurostat 2026.d, 2026.c). Bliske su i odgovaraju uglavnom uzlaznom oblaku, ali ne dokazuju linearnost ili otpornost nalaza. U EU-27 tijekom 2025. viši državni udjeli tercijarno obrazovanih osoba od 25 do 34 godine povezani su s višim udjelima uporabe interneta među osobama od 16 do 74 godine (Eurostat 2026.d, 2026.c). To ne pokazuje odnos obrazovanja i uporabe interneta kod pojedine osobe.
Veličina točaka potiče provjeru dobne strukture kao mogućeg trećeg čimbenika (Eurostat 2026.f, 2026.d, 2026.c). Za tu bismo provjeru trebali ispitati odnos dobne strukture s objema glavnim varijablama i razmotriti dizajn koji odvaja moguća objašnjenja. Ovaj presjek ne pokazuje trend, uzrok, odnos među pojedincima ili nalaz izvan EU-27 (Eurostat 2026.f, 2026.d, 2026.c).
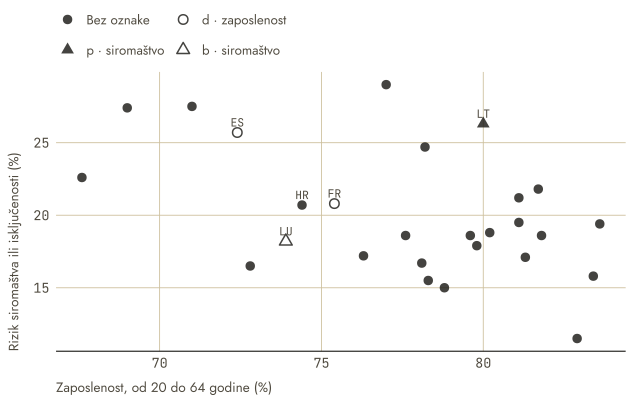
Iste države možemo usporediti prema zaposlenosti te riziku siromaštva ili socijalne isključenosti. Zaposlenost obuhvaća osobe od 20 do 64 godine, a rizik stanovništvo svih dobi (Eurostat 2026.b, 2026.e). Sljedeći graf prikazuje 27 potpunih parova, po jednu točku za državu, uz izvorne oznake obaju pokazatelja (Eurostat 2026.b, 2026.e). Oblaci državnih udjela opisuju razlike među zemljama. Za vezu zaposlenosti i siromaštva pojedine osobe trebali bismo individualne podatke, a za uzročni zaključak odgovarajući dizajn.
Moguća konfundirajuća varijabla mora prethoditi objema pojavama i utjecati na njih. To prosuđujemo prema sadržaju i dizajnu. U konstruiranom primjeru odjel tako oblikuje staž i zadovoljstvo. Razdvajanjem odjela vidimo promjenu povezanosti, ali sama ta promjena ne dokazuje uzročnost. O neizmjerenom čimbeniku koeficijent ne daje izravnu obavijest.
Interakcija — Pogodi korelaciju
Svaki oblak ovdje je novi nastavni skup s 54 para bez mjerne jedinice. Za jednu točku neovisno izvlačimo dvije normalne vrijednosti sa sredinom nula i standardnom devijacijom jedan. Prva postaje \(x\), a \(y\) dobivamo miješanjem dijela prvoga izvlačenja i dijela drugoga. Više zajedničkoga dijela znači jaču vezu, a negativan predznak zajedničkoga dijela silaznu vezu. Generator zadaje četiri različite populacijske korelacije, dok koeficijent svakog konačnog oblaka računamo iz njegovih 54 para. Uzorački koeficijenti pritom mogu odstupati od zadanih populacijskih vrijednosti. Točke ostaju iste dok čitatelj iskušava vlastite procjene.
Četiri raspršena oblaka omogućuju usporedbu smjera i jačine povezanosti. Najprije promatramo oblik svakog oblaka. Tablica koja slijedi donosi Pearsonove korelacije i zadane procjene, pa se može provjeriti koliko su procjene blizu izračunanim vrijednostima.
Što isprobati.
- Procijenite samo znak svake povezanosti i provjerite jesu li klizači na pravoj strani nule.
- Usporedite oblake A i D te procijenite koji je odnos bliže savršenoj povezanosti.
- Fino namjestite procjene za slabije oblake B i C bez mijenjanja prvih dviju.
- Otvorite rješenje, usporedite četiri odstupanja i opišite koji je oblak bilo najteže procijeniti.
Predznak je lakše uočiti nego točnu jačinu veze. Pri usporedbi oblaka A i D trebamo i jednake ljestvice. Uz dobro procijenjen koeficijent potreban je i pregled oblika oblaka.
Vrijeme uz ekran i dobrobit. U istraživanju s početka poglavlja povezanost uporabe digitalne tehnologije i dobrobiti adolescenata bila je u cjelini negativna i mala, a usporedba mnogih opravdanih analiza pokazala je zašto zaključak treba čitati uz odabrane mjere i postupke (Orben i Przybylski 2019.). To nam daje određeniji odgovor od tvrdnje da su „ekrani štetni”. Govorimo o odnosu izmjerenih obilježja u obuhvaćenim skupovima podataka. Za razumijevanje nečije večeri trebali bismo znati i što je osoba radila, s kim je bila u kontaktu te kako se osjećala prije toga.
Orben, Amy, i Andrew K. Przybylski. 2019. „The association between adolescent well-being and digital technology use“. Nature Human Behaviour 3 (2): 173–82. https://doi.org/10.1038/s41562-018-0506-1.
Takva povezanost sama ne govori koliko bi se dobrobit iste osobe promijenila kad bi smanjila uporabu. Za to trebamo usporedbu koja razdvaja promjenu navike od drugih mogućih objašnjenja. U poglavlju o dvjema grupama upoznat ćemo pokus s deaktivacijom Facebooka. On će postaviti uže pitanje o određenoj intervenciji, određenim korisnicima i određenom razdoblju. Razlika između tih pitanja pomoći će nam povezati opis navika s dokazom o njihovoj promjeni.
U simuliranoj anketi od 300 osoba provjeravamo odnos dobi i dnevnih minuta na društvenim mrežama. Asistentu je postavljeno pitanje o cijelom uzorku. Vratio je ovaj račun.
Za provjeru su dostupni isti sažeci koje smo usporedili uz raspršeni dijagram. Pearsonov koeficijent u tablici opisuje linearnu povezanost.
| Uključene osobe | Broj osoba | Pearsonov koeficijent |
|---|---|---|
| Cijeli simulirani uzorak | 300 | −0,56 |
| Osobe od 18 do 24 godine | 90 | 0,18 |
Račun daje korelaciju 0,18 uz 90 ispitanika. Prema tome, dob i vrijeme korištenja nisu negativno povezani u cijelom simuliranom uzorku.
Pridružite ispis jednom retku tablice. Označite mjesto na kojem se odgovor udaljio od postavljenog pitanja i napišite zamjenski zaključak koji opisuje oba obuhvata. Sačuvajte točan rezultat asistentova računa.
Razrađeni primjer
U odnosu dobi i dnevnog vremena korištenja već smo vidjeli zašto koeficijent trebamo čitati uz graf. Sada te provjere povezujemo u jedno izvješće o simuliranoj anketi. Graf pokazuje oblik odnosa. Pearsonov koeficijent sažima koliko odnos prati pravac, a Spearmanov koliko dosljedno slijedi silazni poredak. Zaključak se odnosi na te simulirane podatke.
Prikaži kod
# A tibble: 1 × 3
      n pearson spearman
  <int>   <dbl>    <dbl>
1   300  -0.559   -0.680
Za oba opisa koristimo iste parove dobi i minuta. Poziv summarise, koji već poznajemo, okuplja sažetke, a funkcija cor računa korelaciju dvaju stupaca. Zadana je Pearsonova korelacija. Odabirom Spearmanove u argumentu method mijenjamo način sažimanja odnosa, dok osobe i njihove vrijednosti ostaju iste.
Graf pokazuje da se pad vremena s dobi poslije izravnava. Pearsonova vrijednost -0,56 opisuje linearnu vezu, a Spearmanova -0,68 dosljednost silaznog poretka. Razlika je spojiva sa zakrivljenošću koju smo vidjeli, ali bez grafa ne bi bila dovoljna za taj zaključak.
Rezultat možemo navesti ovako. U simuliranom uzorku od 300 ispitanika dob i dnevno vrijeme korištenja negativno su povezani. Graf pokazuje zakrivljen silazni odnos, uz Spearmanovu korelaciju -0,68 i Pearsonovu -0,56, manjeg apsolutnog iznosa. Ne zaključujemo o uzroku jer je skup simuliran i presječan, bez istraživačke intervencije ili zabilježenog vremenskog redoslijeda.
Od odnosa do tvrdnje
Na Eurostatovu presjeku pratimo kako od izvornog retka dolazimo do rečenice o povezanosti i što usput treba provjeriti.
| Revizijsko pitanje | Primjena na Eurostatov odnos |
|---|---|
| Koja je jedinica? | nakon spajanja pokazatelja, jedna država članica EU-a u 2025. |
| Tko ili što nedostaje? | pojedinci unutar država, zemlje izvan EU-27 i druga razdoblja nisu jedinice ovoga presjeka |
| Koji je cilj tvrdnje? | Pearsonov i Spearmanov koeficijent opisuju povezanost dvaju državnih udjela |
| Gdje je neizvjesnost? | statusne oznake prenose upozorenja izvora. Koeficijenti ne mjere uzoračku ni mjernu nesigurnost, a presjek ne pokazuje promjenu kroz vrijeme |
| Koje drugo objašnjenje ostaje? | druga dobna skupina ili pokazatelj, rangovi umjesto vrijednosti ili drukčije opravdano postupanje sa statusnim oznakama |
| Tko snosi posljedice? | pogrešan opis stanovnika ili država može dovesti do neutemeljene uredničke ili javne odluke |
Promjena jedinice mijenja i ono što procjenjujemo, moguća objašnjenja te posljedice zaključka. Statusna oznaka također traži prosudbu. O uključivanju retka odlučujemo prema značenju oznake. Pravilo unaprijed obrazlažemo i navodimo u izvještaju.
Granica tvrdnje o povezanosti ovisi o jedinici, obuhvatu i načinu mjerenja. Sljedeća tablica pokazuje koje vrste tvrdnji ti podaci podupiru.
| Dimenzija tvrdnje | Što ovaj dokaz dopušta |
|---|---|
| opis | opis vrijednosti i izvornih statusnih oznaka za šest pokazatelja u EU-27 2025. |
| povezanost | odnos državnih udjela tercijarnoga obrazovanja i uporabe interneta u istom presjeku |
| generalizacija | nije poduprta izvan država, godine i dobnih obuhvata koje izvori navode |
| predviđanje | nije poduprto jer nijedno prediktivno pravilo nije izgrađeno ni provjereno na doista novim opažanjima |
| uzročnost | nije poduprta jer vremenski redoslijed i konkurentska objašnjenja nisu razdvojeni |
| odluka | poduprta je omeđena urednička odluka o poštenoj formulaciji nalaza, ali ne obrazovna ili digitalna politika |
Eurostat. 2026.b. „Employment and labour force by sex and age - annual data“. https://doi.org/10.2908/LFSI_EMP_A.
Eurostat. 2026.e. „Persons at risk of poverty or social exclusion by age and sex“. https://doi.org/10.2908/ILC_PEPS01N.
Eurostat. 2026.f. „Population structure indicators at national level“. https://doi.org/10.2908/DEMO_PJANIND.
Za ovaj presjek možemo reći da su dva državna udjela u EU-27 2025. pozitivno povezana (Eurostat 2026.d, 2026.c). Iz toga ne izvodimo zaključak o pojedincima, uzrocima, budućnosti ili drugim zemljama.
Za samoprovjeru možemo odgovoriti na četiri pitanja. Što predstavlja točka Eurostatova grafa? Zašto je Luksemburg uključen u glavni odnos, ali ne i u odnos s ranim napuštanjem obrazovanja? Zašto prije usporedbe koeficijenata pregledavamo graf? Koje tri vrste zaključka ovaj presjek ne podupire i što bi nam za njih trebalo?
Tri pogrešna tumačenja iz ovoga dijela knjige možemo provjeriti istim redom. Najprije ustanovimo što je doista u podacima, zatim usporedimo tvrdnju s odgovarajućim prikazom i na kraju odredimo granicu zaključka. Tako se provjere tablice, grafa i koeficijenta nadovezuju jedna na drugu.
| Provjera | Sažetak u poglavlju o sažimanju | Graf u poglavlju o vizualizaciji | Povezanost u ovom poglavlju |
|---|---|---|---|
| Pogrešan zaključak | spoj po godini valjan je jer se zbroj prikazanih redaka može izračunati | treći stupac može biti širi radi optičke ravnoteže | povezanost u jednoj dobnoj podskupini određuje smjer veze u cijelom uzorku |
| Što gledamo | jedinicu retka, puni ključ, broj redaka i zbroj prije i nakon spajanja | jednake širine stupaca, os od nule i čitljivost bez boje | filtrirani uzorak, cijeli oblak točaka i oblik veze |
| Gdje je provjera | tablica kontrole spajanja i oznaka dostupnosti metrike | usporedba dviju osi i tablica izbora prikaza | raspršeni dijagram dobi i minuta te koeficijenti za cijeli uzorak |
| Granica | opis vrijedi za uključeni DigiKatov korpus | graf ne nadomješta provjeru podataka i uredničkoga pitanja | povezanost ne pokazuje uzrok ni populacijski doseg |
Sažetak
Od zajedničkih odstupanja dviju varijabli izgradili smo kovarijancu, a standardizacijom Pearsonovu korelaciju, mjeru linearne veze između minus jedan i plus jedan koja ne ovisi o mjernim jedinicama. Kada vrijednosti zamijenimo rangovima, Spearmanovim koeficijentom opisujemo monotonost, pri čemu gubimo izvorne razmake. Graf nam pomaže protumačiti obje mjere jer pokazuje podskupine, utjecajna opažanja i oblik koji se može promijeniti sužavanjem raspona. Na rezultat utječu i pravilo kojim tekst pretvaramo u brojčane oznake te izbor jedinice, pa povezanost među državama ne prenosimo na pojedince. Za uzročni zaključak i dalje trebamo odgovarajući dizajn. U sljedećem dijelu vjerojatnost će nam pomoći razumjeti kakve obrasce može proizvesti sam slučajni postupak.
Pojmovi
- kovarijanca
- covariance
- korelacija
- correlation
- Pearsonova korelacija
- Pearson correlation
- linearnost
- linearity
- oblik odnosa
- shape of a relationship
- matrica korelacija
- correlation matrix
- kodirana kategorija teksta
- coded text category
- Spearmanov koeficijent ranga
- Spearman rank correlation
- monotona veza
- monotonic relationship
- utjecajno opažanje
- influential observation
- ograničenje raspona
- range restriction
- ekološka pogreška
- ecological fallacy
- konfundirajuća varijabla
- confounder
- granica tvrdnje o povezanosti
- boundary of an association claim
Zadaci
Konceptualni
Vratite se u poglavlje o sažimanju podataka i primijenite ondje uvedena pravila o jedinici retka, ključu i odsutnoj vrijednosti na Eurostatov izvadak iz ovoga poglavlja. Objasnite zašto glavni odnos tercijarnoga obrazovanja i uporabe interneta zadržava Luksemburg i 27 država, zašto bi odnos koji uključuje rano napuštanje obrazovanja imao najviše 26 potpunih parova te zašto hrvatska vrijednost 2,1 sa statusom u ostaje broj, dok luksemburški zapis : s istim statusom ne postaje nula (Eurostat 2026.d, 2026.c, 2026.a). Predajte tablicu s tri retka, odlukom o uključivanju i razlogom, zatim jednu poštenu rečenicu o glavnom odnosu na razini država.
Eurostat. 2026.a. „Early leavers from education and training by labour status“. https://doi.org/10.2908/EDAT_LFSE_14.
Računski
Upotrijebite tablicu korelacija triju varijabli simulirane ankete. Za svaki od triju parova zapišite smjer Pearsonove veze. Za par dobi i minuta zatim prema raspršenom dijagramu procijenite bi li se Spearmanova vrijednost razlikovala i u kojem smjeru. Za preostala dva para zapišite zašto se to ne može prosuditi bez njihovih dijagrama i što bi na njima trebalo pregledati. U digitalnom izdanju unesite četiri procjene u interakciju i otvorite rješenje. Za svaki oblak izračunajte apsolutno odstupanje procjene. Predajte tablicu sa sedam redaka i jednom rečenicom obrazloženja u svakom. Postupak za ponavljanje izračuna nad cijelim skupom nalazi se u praktikumu.
Kritički
Usporedite objavljene Eurostatove tablice o tercijarnome obrazovanju i uporabi interneta s prikazom u ovom poglavlju (Eurostat 2026.d, 2026.c). Imenujte jedinicu analize i napišite dopuštenu rečenicu na razini država. Zatim objasnite zašto iste tablice ne podupiru tvrdnju „Tercijarno obrazovanje povećava individualnu uporabu interneta”. Pronađite ekološki i uzročni skok te postavite pitanje o dobnoj strukturi kao mogućem trećem čimbeniku. Navedite kakvi bi podaci i dizajn bili potrebni za tvrdnju o pojedincu i uzroku. Predajte odlomak s presudom i jednom poštenom zamjenom sporne rečenice.
Eurostat. 2026.d. „Persons aged 25–34 with tertiary educational attainment level“. https://doi.org/10.2908/SDG_04_20.
Eurostat. 2026.c. „Individuals - internet use“. https://doi.org/10.2908/ISOC_CI_IFP_IU.
Revizija modela
Ocijenite analizu iz okvira o pogrešci. Imenujte što je u pozivu ispravno izvedeno, redak koda koji mijenja ciljnu skupinu, razlog zbog kojeg dobiveni koeficijent ne odgovara na pitanje o cijelom rasponu dobi i napišite ispravljenu rečenicu izvještaja.