| Izvor | Broj osoba | Zbroj ocjena | Sredina |
|---|---|---|---|
| portal | 227 | 1117 | 4,921 |
| tisak | 73 | 406 | 5,562 |
Logika testiranja
Što p-vrijednost govori — i što ne govori
Šaljete prijavu za prvi posao i čekate odgovor. Ako poziv izostane, teško možete znati je li presudilo iskustvo, obrazovanje ili nešto što poslodavac zaključuje već iz vašeg imena. Vlastita prijava pokazuje samo jedan ishod. Ne možete vidjeti što bi se dogodilo s drukčijim imenom na usporedivu životopisu.
U terenskom pokusu u Bostonu i Chicagu istraživači su na oglase za posao slali izmišljene životopise. Nasumično su im dodjeljivali imena odabrana da zvuče bjelački ili afroamerički, a zatim bilježili pozive na razgovor (Bertrand i Mullainathan 2004.). Tako su mogli usporediti reakcije poslodavaca na nasumično dodijeljen signal percipirane rasne pripadnosti (Bertrand i Mullainathan 2004.).
Ako jednoj skupini prijava stigne više poziva, koliko bi takva razlika bila uvjerljiv dokaz da je ime utjecalo na odgovor?
Procjena s intervalom već nam govori koliku smo razliku našli i koliko smo je precizno odredili. U istraživačkim izvještajima uz nju često stoji i p-vrijednost. Da bismo taj broj mogli pročitati, trebamo promijeniti pitanje. Umjesto traženja raspona za nepoznatu veličinu, pitat ćemo kakve bi rezultate proizvodio određeni model u kojem nema povezanosti koju istražujemo.
Pitanje iz pokusa odnosi se na razliku udjela poziva. Logiku usporedbe s nultim modelom najprije ćemo pratiti na poznatim simuliranim podacima, gdje možemo vidjeti svaki korak premještanja oznaka. Pri procjeni povjerenja promatrali smo populaciju kao cjelinu. Sada nas zanima koliko se prosječno povjerenje razlikuje između čitatelja tiska i portala te koliko je ta procjena nesigurna.
Uzorak od 300 čitatelja tiska i portala izvlačimo zasebno iz nastavne populacije populacija_medija, nakon ograničavanja na ta dva izvora. Svaki redak predstavlja zamišljenu osobu s izvorom vijesti i povjerenjem na ljestvici od jedan do deset, bez tvrdnje o stvarnim stanovnicima. Najprije ćemo prikazati razliku i njezin interval. Potom ćemo pretpostaviti jednaku raspodjelu povjerenja među skupinama i provjeriti što bismo očekivali kada oznake izvora ne bi bile povezane s odgovorima.
I u ovoj usporedbi ponavljamo postupak, ali drukčije nego pri uzorkovanju ili bootstrapu. Ocjene ostaju zabilježene, a oznake skupina nasumično premještamo među osobama. Svaki takav raspored daje novu razliku. Iz njihove raspodjele možemo procijeniti koliko su česta odstupanja barem toliko velika kao opaženo, uz pretpostavke koje dopuštaju premještanje. Tek nakon te provjere imenovat ćemo nultu hipotezu, testnu statistiku i p-vrijednost.
Odluka na temelju testa može biti pogrešna na dva načina. Možemo prijaviti razliku koje nema ili propustiti razliku koja postoji. Prag odluke utječe na obje mogućnosti, a neodbacivanje hipoteze ne potvrđuje njezinu istinitost. Pitanje o vjerojatnosti hipoteze zahtijeva drugi račun i dodatne pretpostavke, kakve ćemo upoznati u kratkoj usporedbi s Bayesovim pristupom. Pri čitanju nalaza zato odvajamo ono što test kaže o podacima od procjene veličine razlike, njezine važnosti i mogućeg uzroka.
Sudnica i njezina asimetrija
Prije testa trebamo prikazati veličinu opažene razlike i njezinu nesigurnost. Trebamo razmotriti i posljedice pogrešne odluke. Hoće li veći problem biti prijaviti razliku koje nema ili propustiti onu koja postoji? Ta pitanja određuju kako ćemo koristiti rezultat.
Usporedba podataka s početnom pretpostavkom ima sličnost sa suđenjem. Dokazi se procjenjuju u odnosu na pretpostavku nevinosti. Ako optužba nije dokazana, time ne mora biti dokazana nevinost. Slično vrijedi za test. Kada nemamo dovoljno dokaza za odbacivanje početne hipoteze, još nismo pokazali da je ona istinita.
Usporedba sa suđenjem ima granice. Statističke stope pogreške opisuju kako bi se postupak ponašao kroz mnogo ponavljanja. One nisu vjerojatnosti da je odluka u pojedinom istraživanju pogrešna.
Zato prije uvida u podatke zapisujemo nulti model, mjeru odstupanja i prag odluke. Za tako određen postupak možemo procijeniti stopu pogreške. Ako postupak prilagođavamo dobivenim rezultatima, ta stopa više nije zajamčena. Posljedice takvih prilagodbi razmotrit ćemo u poglavlju o krizi i obnovi.
Kako se gradi svijet bez učinka
Uzorak od 300 čitatelja tiska i portala zadržava izvorne oznake skupina. Njihove ocjene povjerenja najprije čitamo prije bilo kakva premještanja.
Odabir smo najprije ograničili na osobe kojima je glavni izvor tisak ili portal, a iz njih izabrali 300 zapisa bez vraćanja. Druge izvore nismo prekodirali u te dvije skupine. U uzorku je 73 čitatelja tiska i 227 korisnika portala. Ocjene zbrajamo zasebno i dijelimo odgovarajućim brojem osoba.
Od sredine za tisak oduzimamo sredinu za portal. Račun zadržava izvorni raspored opažanja, pa razlika opisuje upravo te skupine.
Najprije navodimo procjenu. Čitatelji tiska imaju u prosjeku 0,64 boda više povjerenja, uz interval pouzdanosti od 0,17 do 1,11. Testom ćemo zatim provjeriti koliko su podaci uskladivi s određenim modelom bez razlike.
Taj 95-postotni interval koristimo kao normalnu približnu procjenu za razliku neovisnih sredina. Standardnu pogrešku računamo kao \(\sqrt{s_T^2/n_T+s_P^2/n_P}\), gdje su \(s_T\) i \(s_P\) uzoračke standardne devijacije tiska i portala, a \(n_T\) i \(n_P\) njihove brojnosti. Razlici dodajemo i od nje oduzimamo \(1,96\) standardnih pogrešaka. Račun traži neovisne osobe i dovoljno stabilnu približno normalnu raspodjelu razlike. Interval se temelji na tom približnom računu standardne pogreške. Premještanje oznaka upotrijebit ćemo za test. Za manje uzorke poglavlje o dvjema grupama razvija t-prilagodbu i Welchove stupnjeve slobode.
Pretpostavimo da je cijela raspodjela povjerenja jednaka među čitateljima tiska i portala. Pod tom pretpostavkom oznake izvora vijesti zamjenjive su u odnosu na ishod. Možemo ih nasumično premjestiti među osobama, ponovno izračunati razliku sredina i to ponoviti mnogo puta. Dobivene razlike pokazuju što bismo mogli očekivati pod modelom u kojem oznaka nije povezana s ishodom.
U tablici je prvih šest osoba iz uzorka od 300 čitatelja tiska i portala prije i nakon prvoga nasumičnog preslagivanja svih 300 oznaka. Ocjena prvog retka ostaje 6, a uz nju sada stoji oznaka „portal”. Za novi račun grupiramo ocjene prema desnom stupcu, pa se mijenjaju skupni zbrojevi, ali ne ukupan zbroj ocjena ni brojnost tiska i portala.
| Redak | Povjerenje | Prije | Poslije |
|---|---|---|---|
| 1 | 6 | tisak | portal |
| 2 | 10 | portal | portal |
| 3 | 2 | portal | tisak |
| 4 | 4 | portal | tisak |
| 5 | 3 | portal | tisak |
| 6 | 5 | tisak | portal |
Iz svih 300 redaka nakon toga preslagivanja dobivamo razliku 0,080 boda. To je jedna vrijednost nulte raspodjele. Za sljedeću ponovno preslažemo isti skup oznaka uz iste ocjene.
Početnu pretpostavku sada možemo imenovati.
Definicija 1 Nulta hipoteza je precizan model postupka koji je proizveo podatke, sastavljen tako da u njemu nema razlike ni veze koju istražujemo.
Alternativna hipoteza ovdje obuhvaća odstupanja od nultog modela. Nulti model daje raspodjelu s kojom uspoređujemo opaženi rezultat. Test stoga ne računa koja je od dviju hipoteza vjerojatnija.
Takvo nasumično premještanje oznaka čini osnovu permutacijskog testa.
Nulti model ovog postupka pretpostavlja jednakost cijelih raspodjela, uključujući njihove sredine, raspršenosti i oblike. Pretpostavljamo i da su osobe neovisne jedinice opažanja. Izvor vijesti nije nasumično dodijeljen, pa zamjenjivost oznaka ovdje prihvaćamo kao pretpostavku modela. Iz rezultata ne možemo zaključiti da čitanje određenog izvora uzrokuje povjerenje.
Da bismo usporedili izvorni i premještene rasporede, trebamo isti sažetak za svaki od njih. Taj broj treba pratiti upravo odstupanje koje nas zanima.
Definicija 2 Testna statistika je jedan broj izračunat iz podataka koji sažima odstupanje od nultog modela u obliku usporedivom s odstupanjima koja taj model proizvodi.
Kao testnu statistiku koristimo razliku sredina. Zanimaju nas oba smjera, pa uspoređujemo apsolutnu opaženu razliku s apsolutnim razlikama nakon premještanja. Ova jednostavna permutacija ispituje opisani model jednakosti cijelih raspodjela, koji uključuje i njihove oblike i raspršenosti. Slika prikazuje razlike iz četiri tisuće premještanja i razliku iz izvornog rasporeda oznaka.
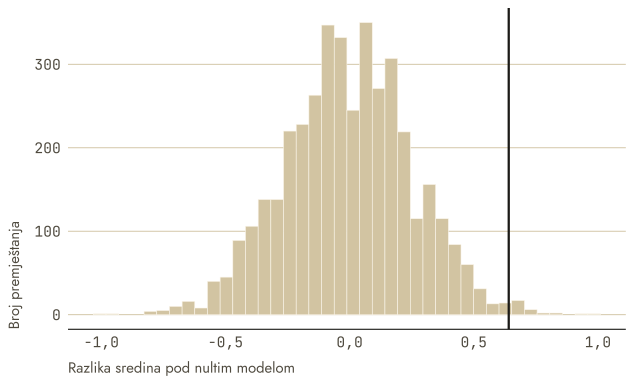
Nulta raspodjela ima sredinu u nuli i standardnu devijaciju od 0,26 boda. U 95 % premještanja apsolutna razlika ne prelazi 0,50 boda. Opažena razlika od 0,64 boda veća je od te granice.
Prebrojimo sada premještanja u kojima je apsolutna razlika barem toliko velika kao opažena. Njihov udio koristimo za procjenu p-vrijednosti.
Definicija 3 P-vrijednost je udio rezultata koje nulti model proizvodi, a koji su s njime u najmanju ruku jednako neusklađeni kao opaženi rezultat.
U 4 000 preslagivanja nalazimo 64 apsolutnih razlika barem toliko velikih kao opažena. Dodavanjem izvornog rasporeda brojniku i nazivniku račun postaje \((64 + 1)/(4\,000 + 1)\). Sva su preslagivanja valjana jer se brojnost obiju skupina čuva.
U uzorku od 300 čitatelja tiska i portala p-vrijednost iznosi 0,016. To znači da, uz iste opažene ishode i veličine skupina, nulti model daje apsolutnu razliku ovoliku ili veću u otprilike 1,6 % simuliranih rasporeda oznaka. U tumačenju moramo zadržati uvjet da vrijedi nulti model.
Kad bismo pregledali sva moguća premještanja, izračunali bismo točan udio, uključujući opaženi raspored. Ovdje uzimamo samo konačan broj nasumičnih premještanja. Ako njihov broj označimo s \(B\), a broj apsolutnih razlika barem toliko velikih kao opažena s \(b\), procjenjujemo p-vrijednost kao \((b + 1)/(B + 1)\). Dodavanje opaženog rasporeda sprječava rezultat nula i daje valjanu procjenu za nasumično uzorkovana premještanja.
Interakcija — Simulator p-vrijednosti
U početnim postavkama sljedećeg modela dvije skupine imaju po 60 osoba, a pojedinačni ishodi normalnu raspodjelu sa standardnom devijacijom jedan. Pod nulom obje sredine iznose nula. U scenariju s vezom druga je sredina viša za 0,35. Jedna studija uspoređuje dvije uzoračke sredine i dijeli njihovu razliku poznatom standardnom pogreškom \(\sqrt{2/60}\). Simulacija izravno generira tako standardizirani rezultat, što je u ovom modelu jednako generiranju svih pojedinačnih ishoda i računanju iz njih. Digitalni prikaz počinje s 2 000 ponavljanja po scenariju i dopušta promjenu veličine skupina, učinka i broja ponavljanja. Tiskani prikaz zadržava po 60 osoba i razliku 0,35 te koristi 4 000 ponavljanja po scenariju. Svako ponavljanje daje jednu p-vrijednost. Svi rezultati ulaze u prikaz.
Dosad smo za jedan uzorak premještali oznake i promatrali raspodjelu razlika. Sada promatramo p-vrijednosti iz ponovljenih zamišljenih studija. U prvom scenariju učinka nema, a u drugome postoji. Koristimo normalne ishode s poznatom varijabilnošću i obostrani z-test. Neovisnost skupina znači da se varijance njihovih sredina zbrajaju i kada računamo razliku sredina. Standardna pogreška razlike korijen je toga zbroja. P-vrijednost obostranog testa zbroj je površina u oba repa standardne normalne raspodjele, izvan opaženog apsolutnog z-rezultata. P-vrijednosti ovaj put računamo iz poznate normalne raspodjele, pa korekcija za konačan broj premještanja nije potrebna. Razliku izražavamo u standardnim devijacijama, što ćemo podrobnije objasniti u sljedećem poglavlju.
Što isprobati.
- Postavite stvarnu razliku na nulu i opišite oblik gornje raspodjele.
- Podignite stvarnu razliku na 0,35 uz nepromijenjen uzorak.
- Povećajte uzorak bez promjene razlike i usporedite udio rezultata ispod praga.
- Spustite prag s 0,05 na 0,01 i pogledajte obje raspodjele.
Kada vrijedi nulti model ove simulacije, p-vrijednosti su ravnomjerno raspoređene između nule i jedinice. Jednako široki rasponi oko 0,03 i 0,53 zato su jednako vjerojatni. Prag od 0,05 izdvaja donjih pet posto raspodjele. Upravo taj dugoročni udio odbacivanja pod nultim modelom prag ograničava.
Dvije vrste pogreške
Prag je u prethodnom prikazu izdvojio i neke rezultate nastale bez učinka. Ako na temelju njih odbacimo istinitu nultu hipotezu, činimo pogrešku prve vrste. U drugoj simulaciji učinak postoji, ali dio p-vrijednosti ostaje iznad praga. Pogreška druge vrste nastaje kada tako ne odbacimo nultu hipotezu iako je lažna. Isti postupak odlučivanja stoga trebamo procijeniti u oba uvjeta.
Definicija 4 Pogreška prve vrste je odbacivanje nulte hipoteze koja je istinita. Pod pretpostavkama modela postupak ograničava dugoročni udio takvih odbacivanja odabranim pragom.
Istraživački tim, primjerice, treba odlučiti hoće li poduprijeti tvrdnju da se skupine razlikuju. Pogreška prve vrste dovela bi do neutemeljene usporedbe skupina. Pogreška druge vrste mogla bi prikriti postojeću razliku i zaustaviti njezino daljnje istraživanje. Posljedice snose i čitatelji i osobe o kojima se zaključuje. Tim zato treba objasniti koju je pogrešku smatrao ozbiljnijom pri izboru praga.
Stopu pogreške prve vrste možemo provjeriti simulacijom u kojoj nulti model sigurno vrijedi. Iz poznate populacije svaki put uzimamo 300 ishoda, pa im nasumično dodjeljujemo jednako mnogo oznaka A i B. Oznaka je neovisna o ishodu. Tako obje skupine nastaju iz iste pune raspodjele povjerenja.
Sada jedno vanjsko ponavljanje sadrži cijeli test. Odaberemo novih 300 ishoda, nasumično im dodijelimo po 150 oznaka A i B, a zatim za taj uzorak provedemo 300 unutarnjih permutacija i izračunamo jednu p-vrijednost. Ponavljamo to 800 puta i broj p-vrijednosti ispod 0,05 dijelimo s 800. Drugi scenarij uzima nove uzorke iz podskupa tiska i portala s njihovim postojećim oznakama, u kojem veza postoji. To mijenja i sastav skupina, čije brojnosti nisu unaprijed izjednačene. U oba niza sva su ponavljanja definirana i nijedno nije izostavljeno.
Na osamsto takvih uzoraka permutacijski postupak odbacuje nultu hipotezu uz prag 0,05 u 4,9 % slučajeva. Zbog konačnog broja premještanja i slučajnog kolebanja među uzorcima udio ne mora biti točno pet posto. Ovdje provjeravamo postupak u uvjetima koji zadovoljavaju njegovu pretpostavku zamjenjivosti.
| Pitanje | Stvarna razlika u populaciji | Broj odbacivanja | Udio odbacivanja |
|---|---|---|---|
| Nasumično dodijeljena oznaka | 0,00 | 39 | 4,9 % |
| Razlika po izvoru vijesti | 0,74 | 636 | 79,5 % |
Drugi redak tablice pokazuje što se događa kada razlika postoji. U populaciji razlika prema izvoru vijesti iznosi 0,74 boda. Postupak je otkriva u 79,5 % uzoraka. U preostalih 20,5 % ne bismo imali dovoljno dokaza za odbacivanje nulte hipoteze, iako razlika postoji.
Na zajedničkoj osi prikazane su raspodjela pod nultim modelom i raspodjela procijenjene razlike kada učinak postoji. Prva premješta oznake u istom uzorku od 300 čitatelja tiska i portala, a druga nastaje novim izvlačenjima iz iste podpopulacije. Iste granične crte određuju odluku u oba slučaja.
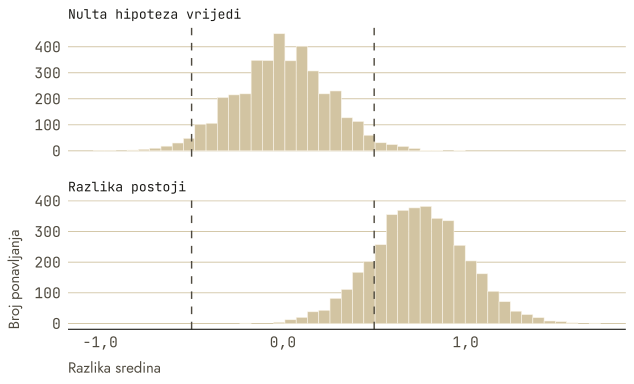
Pomaknemo li granične crte prema van, rjeđe odbacujemo istinitu nultu hipotezu. Istodobno veći dio raspodjele s postojećim učinkom ostaje između crta, pa češće propuštamo razliku. Pri istom pragu veći uzorak ili preciznije mjerenje mogu smanjiti pogrešku druge vrste, uz zadržano ograničenje pogreške prve vrste. S više informacija možemo razmotriti i stroži prag, ali trebamo ponovno procijeniti odnos obiju pogrešaka.
Površine na slici objašnjavaju odnos pogrešaka, ali nisu izmjerene stope iz tablice. Gornja raspodjela prikazuje 4 000 premještanja oznaka iz glavnoga uzorka, a donja 4 000 novih uzoraka iz populacije u kojoj razlika postoji. Snaga postupka ovisi o veličini učinka, varijabilnosti, veličini i nacrtu uzorka, testnoj statistici i pragu odluke.
Referentna oznaka nije isto što i istina
Stope pogrešaka mogli smo prebrojiti jer smo u simulaciji zadali kako podaci nastaju. Pri procjeni algoritama susrest ćemo srodno, ali drukčije pitanje, slaže li se predviđena kategorija s referentnom oznakom, primjerice ručno dodijeljenom kategorijom. Ta oznaka, za razliku od poznate istine simulacije, može biti pogrešna. Ovisi o mjerenju, uputama za označavanje i načinu rješavanja spornih slučajeva.
Neslaganje s referencom zato može potjecati i od postupka koji ispitujemo i od same reference. U izvještaju navodimo kako su referentne oznake nastale i jesu li neslaganja ponovno pregledana. To će biti posebno važno pri procjeni algoritama. Uz precizno izračunatu stopu neslaganja potrebna je i provjera kvalitete same reference.
Vratimo se prijavama za posao. U objavljenom pokusu životopisi s imenima prepoznatima kao bjelačka dobivali su više poziva na razgovor od životopisa s imenima prepoznatima kao afroamerička (Bertrand i Mullainathan 2004.). Nulta pretpostavka bez učinka dodijeljenog imena dopuštala bi razlike nastale samom nasumičnom dodjelom. Test bi pitao koliko su odstupanja barem toliko velika kao opaženo česta pod takvim postupkom. Račun mora pritom pratiti stvarnu dodjelu prijava i njihovo slanje na iste oglase, umjesto da sve retke automatski smatra neovisnima.
Bertrand, Marianne, i Sendhil Mullainathan. 2004. „Are Emily and Greg More Employable Than Lakisha and Jamal? A Field Experiment on Labor Market Discrimination“. American Economic Review 94 (4): 991–1013. https://doi.org/10.1257/0002828042002561.
Nasumična dodjela daje osnovu da razliku u odgovorima povežemo s dodijeljenim imenima. Izmjereni ishod ipak je bio poziv na razgovor na obuhvaćenim oglasima, a ne kasnije zaposlenje ili plaća (Bertrand i Mullainathan 2004.). Za osobu koja traži posao i ta je prva prepreka važna. Zaključak o njoj zahtijeva zajedno opis pokusa, veličinu razlike i njezinu nesigurnost. Mala p-vrijednost sama ne bi opravdala tvrdnju o svakom poslodavcu ili o drugom tržištu rada.
Prag je konvencija, a ne mjera
Rezultat nazivamo statistički značajnim kada mu p-vrijednost ne prelazi unaprijed odabrani prag.
Koristimo prag značajnosti 0,05, ali moguće je odabrati i 0,01 ili 0,10. Izbor određuje dopuštenu dugoročnu stopu odbacivanja istinite nulte hipoteze. Treba ga obrazložiti stručnim običajima i posljedicama pogreške. Stroži prag ima smisla kada je lažni nalaz osobito skup, uz uvažavanje povećanog rizika da propustimo postojeći učinak.
Rezultati neposredno ispod i iznad praga daju gotovo jednaku količinu dokaza. P-vrijednosti 0,048 i 0,052 ne opravdavaju zaključke da u prvom slučaju učinak postoji, a u drugom ga nema. Zato Američko statističko udruženje traži da znanstveni zaključak ne ovisi samo o prelasku praga (Wasserstein i Lazar 2016.).
Izjava u šest načela objašnjava da p-vrijednost opisuje neusklađenost podataka s određenim modelom. Ne daje vjerojatnost hipoteze, vjerojatnost da je rezultat „nastao slučajno” ni veličinu ili važnost učinka. Za zaključivanje su potrebni potpuno izvještavanje, transparentnost i drugi znanstveni dokazi (Wasserstein i Lazar 2016.).
Kada izvještaj sve svede na oznaku „statistički značajan”, čitatelj lako izgubi veličinu procjene, njezinu nesigurnost i posljedice odluke. Te informacije trebaju ostati vidljive bez obzira na položaj p-vrijednosti u odnosu na prag.
P-vrijednost pridonosi znanstvenom argumentu zajedno s procjenom učinka, kvalitetom nacrta i ostalim dokazima. U našem izvještaju zato najprije navodimo procjenu i interval, objašnjavamo pretpostavke i razmatramo posljedice obiju pogrešaka.
P-vrijednost se mijenja i kada ponavljamo potpuno isti postupak. Na osamsto uzoraka iz naše populacije, uz uvijek jednaku stvarnu razliku, polovica p-vrijednosti bila je ispod 0,007, četvrtina iznad 0,037, a desetina iznad 0,137. Vrijednosti su se protezale preko dva reda veličine. U 12,9 % uzoraka bile su veće od 0,10.
Uzoračka promjenjivost ostaje prisutna i u rezultatu prikazanom na tri decimale. S uzorkom se mijenjaju i procjena i njezin interval. Stavljamo ih na prvo mjesto jer izravno odgovaraju na pitanje kolika je razlika i koliko smo je precizno procijenili.
Što p-vrijednost nije
Za kalibraciju zasebno uzimamo 300 vrijednosti povjerenja iz cijele simulirane populacije i nasumično im dodjeljujemo oznake A i B. Te oznake nisu izvori vijesti. Razlika iznosi -0,09 boda, interval ide od -0,54 do 0,36, a p-vrijednost je 0,70. U ovoj simulaciji znamo da nulti model vrijedi jer oznake nastaju neovisno o ishodu.
Ipak, sam rezultat testa ne dokazuje da razlike nema. Interval obuhvaća vrijednosti u oba smjera, među kojima neke mogu biti sadržajno važne. Velika p-vrijednost govori da podaci ne daju snažan razlog za odbacivanje nultog modela.
Kod male p-vrijednosti česta je obrnuta pogreška. Vrijednost 0,016 odnosi se na rezultate pod pretpostavljenim modelom. Ne daje vjerojatnost modela nakon što smo vidjeli podatke. To su različite uvjetne vjerojatnosti, kakve smo razdvojili u poglavlju o vjerojatnosti.
P-vrijednost ne daje ni vjerojatnost da je nalaz „slučajan”. Račun pretpostavlja određeni nulti model i ne utvrđuje uzrok opaženog rezultata. Također ne mjeri veličinu učinka. Uz dovoljno velik uzorak i mala, praktično nevažna razlika može dati malu p-vrijednost.
Drugo pitanje i drugi račun
Ponekad nas zanima koliko je određena veličina učinka vjerojatna nakon uvida u podatke. Test iz ovog poglavlja ne odgovara na to pitanje. On uspoređuje podatke s preciznim nultim modelom i omogućuje procjenu dugoročnog ponašanja unaprijed određenog postupka. Nulti model posebno je koristan kada odsutnost razlike ili zadana referentna vrijednost ima jasno značenje za odluku.
Bayesovski pristup povezuje početnu raspodjelu vjerojatnosti učinka s modelom koji opisuje podatke pri različitim vrijednostima učinka. Dobivamo ažuriranu raspodjelu vjerojatnosti. Iz nje možemo, uz prihvaćene pretpostavke, procijeniti vjerojatnost da je učinak veći od nule ili neke sadržajno važne granice.
U oba pristupa trebamo navesti pretpostavke. Bayesovski zaključak ovisi o početnoj raspodjeli i modelu podataka, pa izvještavamo koliko je osjetljiv na te izbore. Frekvencijski zaključak ovisi o modelu uzorkovanja ili dodjele, testnoj statistici i unaprijed zadanom postupku. Pristupi postavljaju različita pitanja i drukčije provjeravaju posljedice svojih pretpostavki.
U sljedećim poglavljima nastavljamo s frekvencijskim postupcima. Bayesovski pristup ovdje samo ukratko upoznajemo, a ponovno ćemo ga spomenuti uz regresiju. U oba pristupa veličina učinka i njezina nesigurnost ostaju važne za tumačenje rezultata.
Mala p-vrijednost pred uredničkom odlukom. Pretpostavimo da redakcija dobije istraživački izvještaj o razlici u povjerenju između dviju skupina čitatelja. Autor navodi malu p-vrijednost i predlaže naslov prema kojem je dokazao svoje objašnjenje razlike. Urednik treba odlučiti što od toga može prenijeti publici. Uz točnost prepisanog broja urednik treba utvrditi što je njime provjereno.
Takve je prijelaze lakše prepoznati kad ih vidimo na konkretnim tumačenjima. Jedan pregled okuplja dvadeset pet pogrešnih tumačenja p-vrijednosti, intervala i snage, kao pomoć pri čitanju i pisanju istraživačkih zaključaka (Greenland i sur. 2016.). Među njima je zamjena vjerojatnosti podataka pod pretpostavljenim modelom vjerojatnošću da je sama hipoteza istinita. Mala p-vrijednost ne daje postotak sigurnosti u autorovo objašnjenje (Greenland i sur. 2016.).
Urednik bi zato u našem zamišljenom slučaju najprije trebao potražiti procijenjenu razliku i njezin interval. Zatim treba pročitati kako su čitatelji odabrani, što test uzima kao nulti model i jesu li skupine samo opažene ili je provedena nasumična dodjela. Ako je usporedba opažačka, uvjerljivo odstupanje od nultog modela još ne pokazuje što je uzrokovalo razliku.
Važan je i put do objavljenog rezultata. Autori pregleda upozoravaju da biranje analiza prema dobivenim p-vrijednostima može proizvesti male vrijednosti čak i kada provjeravana nulta hipoteza vrijedi (Greenland i sur. 2016.). Redakcija zato ima razlog zatražiti podatak je li prikazana usporedba bila unaprijed određena i koje su druge analize provedene. Takva provjera razjašnjava postupak odabira analize, uz otvoreno pitanje razloga autorovih odluka.
Nakon toga vijest može prenijeti opaženu razliku, njezinu nesigurnost i ograničenje objašnjenja. Ako te informacije nedostaju, urednik može odgoditi snažan naslov. Test je usporedio podatke s određenim modelom, dok predloženi naslov tvrdi nešto o tome zašto se ljudi razlikuju. Između te dvije rečenice mora stajati dokaz koji sama p-vrijednost ne sadrži.
Provjerite odlomak o razlici povjerenja između čitatelja tiska i portala u poznatoj simuliranoj populaciji. U uzorku je procjena razlike tisak minus portal 0,64 boda, uz 95 % interval od 0,17 do 1,11. Osobe su zasebne jedinice opažanja.
Za test se zadaje nulti model jednake pune raspodjele povjerenja, pod kojim su oznake skupina zamjenjive. Asistentov zapis postupka glasi ovako.
Od 4.000 premještanja njih 64 daje apsolutnu razliku barem toliko veliku kao opažena. Korigirani račun zato daje 65 / 4.001, približno 0,016. U izvještaju je asistent napisao sljedeće.
Pod zadanim nultim modelom opažena je razlika neuobičajena. Skupine su promatračke, pa rezultat ne pokazuje uzrok razlike. P-vrijednost 0,016 znači da je vjerojatnost da između skupina nema razlike 1,6 %.
Povežite brojnik 65 s onim što je postupak prebrojio. Zatim uredite posljednju rečenicu, uz jasno imenovan uvjet pod kojim se vjerojatnost računa. Sačuvajte procjenu razlike, njezinu nesigurnost i ograničenje uzročnog tumačenja.
Razrađeni primjer
Na istom uzorku od 300 čitatelja tiska i portala usporedbu povjerenja provodimo od opažene razlike do njezina položaja u nultoj raspodjeli. Najprije računamo razliku sredina s izvornim oznakama. Zatim zadržavamo ocjene, premještamo oznake skupina i svaki put računamo istu razliku. Prebrojavanjem odstupanja barem toliko velikih kao opaženo procjenjujemo koliko je naš rezultat neobičan pod nultim modelom.
Prikaži kod
[1] 0,640939Prikaži kod
(b + 1) / (B + 1)[1] 0,01624594U ovom pozivu sample bez dodatnih argumenata nasumično mijenja poredak oznaka, dok replicate ponavlja račun i sprema razlike. Za razliku od bootstrap izvlačenja osoba, ovdje svako premještanje zadržava iste ocjene i iste veličine skupina. Ne zadajemo parametarski oblik raspodjele, ali i dalje pretpostavljamo neovisne jedinice i zamjenjivost oznaka pod nultim modelom jednake pune raspodjele. Brojimo odstupanja u oba repa jer je test obostran. Jedinicu dodajemo brojniku i nazivniku radi korekcije za konačan broj nasumičnih premještanja.
U izvještaju povezujemo veličinu razlike s rezultatom testa. Čitatelji tiska imaju u prosjeku 0,64 boda više povjerenja od čitatelja portala, uz interval od 0,17 do 1,11. Nulti model daje apsolutnu razliku ovoliku ili veću u 1,6 % simuliranih rasporeda opaženih oznaka. Te brojke opisuju samo naš simulirani uzorak. U stvarnoj anketi takva bi usporedba pokazivala razliku među skupinama. Za zaključak da čitanje tiska mijenja povjerenje trebali bismo i odgovarajući istraživački nacrt.
Uzročni zaključak zahtijevao bi istraživački nacrt koji razdvaja moguća objašnjenja razlike. Zasebno procjenjujemo koliko je razlika važna za istraživačko pitanje te opravdava li neku odluku.
Sažetak
Testom smo opaženi rezultat usporedili s raspodjelom nultog modela, koju smo ovdje izgradili premještanjem oznaka. P-vrijednost opisuje udio odstupanja barem toliko velikih kao opaženo, uz zadržan uvjet da vrijedi taj model, pa ne dobivamo vjerojatnost hipoteze ni važnost učinka. Izbor praga povezuje dvije moguće pogreške jer stroži prag smanjuje stopu prve, ali pri istim podacima povećava stopu druge, dok više informacija može smanjiti drugu pri istom pragu. Simulacijom s nasumičnim oznakama provjerili smo postupak kada nulti model vrijedi, a uz postojeću razliku od 0,74 boda vidjeli smo da je propušta u 20,5 % uzoraka. Ta nas propuštanja vode pitanju kako prije prikupljanja podataka planirati uzorak za učinak koji vrijedi uočiti. U sljedećem poglavlju odgovorit ćemo na njega pomoću veličine učinka i snage.
Pojmovi
- nulta hipoteza
- null hypothesis
- nulti model
- null model
- obostrani test
- two-sided test
- testna statistika
- test statistic
- p-vrijednost
- p-value
- pogreška prve vrste
- Type I error
- pogreška druge vrste
- Type II error
- prag značajnosti
- significance threshold
- permutacijski test
- permutation test
- referentna oznaka
- reference label
Zadaci
Konceptualni
Objasnite u jednom odlomku zašto p-vrijednost nije vjerojatnost nulte hipoteze, tako da napišete dvije rečenice koje se razlikuju samo po tome što je uvjet, a što zaključak. Imenujte podatak koji bi bio potreban da se od prve dođe do druge.
Računski
Nulta raspodjela iz ovog poglavlja ima sredinu nula i standardnu devijaciju 0,26 boda. Primijenite pravilo područja iz poglavlja o vjerojatnosti i procijenite granice koje su dvije standardne devijacije udaljene od nule. Prije računa imenujte testnu statistiku i postupak kojim je nulta raspodjela izgrađena, pa procjenu usporedite s graničnom vrijednošću 0,50. Zatim pretpostavite da je isti uzorak prikupljen dobrovoljnom poveznicom na jednom portalu. Pozivajući se na razliku između slučajnosti uzorkovanja i selekcije iz poglavlja o uzorkovanju, odredite koju tvrdnju o populaciji ni mala p-vrijednost ne bi mogla opravdati. Na kraju u HTML widgetu postavite stvarnu razliku na nulu i zabilježite približan udio uzoraka ispod praga.
Kritički
Prosudite zašto je jednom strukovnom udruženju trebalo objaviti izjavu o pojedinačnom statističkom postupku, a skupini statističara popis od dvadeset pet pogrešnih tumačenja (Wasserstein i Lazar 2016.; Greenland i sur. 2016.). Predajte kratku uredničku bilješku i navedite jedno pravilo izvještavanja koje bi uklonilo najviše pogrešaka odjednom. Dodajte tko u glavnom primjeru snosi posljedice svake vrste pogreške i zašto procijenjena stopa pogreške prema referentnim oznakama ne dokazuje da su te oznake nepogrešive.
Wasserstein, Ronald L., i Nicole A. Lazar. 2016. „The ASA’s Statement on p-Values: Context, Process, and Purpose“. The American Statistician 70 (2): 129–33. https://doi.org/10.1080/00031305.2016.1154108.
Greenland, Sander, Stephen J. Senn, Kenneth J. Rothman, i sur. 2016. „Statistical Tests, P Values, Confidence Intervals, and Power: A Guide to Misinterpretations“. European Journal of Epidemiology 31 (4): 337–50. https://doi.org/10.1007/s10654-016-0149-3.
Revizija modela
Ocijenite analizu iz okvira o pogrešci. Imenujte korake koji su provedeni ispravno, redak koda iz kojeg izlazi izvještajna brojka, rečenicu koja iz nje ne slijedi i njezinu ispravljenu inačicu.