Vizualizacija kao argument
Graf pokazuje ono što brojčani sažetak ne može
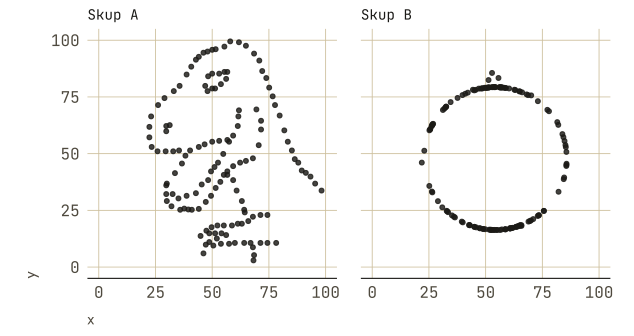
Netko vam pošalje sažetke dvaju skupova, svakog sa 142 para vrijednosti. Zaokružene na jednu decimalu, sredine su u oba skupa 54,3 za \(x\) i 47,8 za \(y\), a standardne devijacije 16,8 i 26,9 (Matejka i Fitzmaurice 2017.). Upravo smo naučili čitati te mjere. Kakav raspored točaka zamišljate iza njih?
Brojevi dolaze iz primjera Datasaurus Dozen, u kojem su podaci namjerno konstruirani da bi ispitali koliko se možemo osloniti na sažetke (Matejka i Fitzmaurice 2017.). Nijedna točka ne predstavlja stvarnu osobu. Prije nego što pogledate graf, pokušajte skicirati dva rasporeda koja bi odgovarala tim brojevima. Koliko različiti smiju biti?
Na slici je svaki par prikazan jednom točkom, na jednakim osima u oba polja. Pogledajte što možemo prepoznati u rasporedu, a što nismo mogli naslutiti iz navedenih sredina i standardnih devijacija.
Dinosaur i prsten stanu iza gotovo istih brojčanih sažetaka. Podaci su namjerno oblikovani za tu demonstraciju (Matejka i Fitzmaurice 2017.), pa iz njih ne izvodimo tvrdnju o stvarnoj populaciji. U razrađenom primjeru vratit ćemo se istom pitanju kroz Anscombeov kvartet. Ondje ćemo vidjeti kako zakrivljenost i pojedino izdvojeno opažanje mogu promijeniti čitanje veze koju smo saželi brojevima (Anscombe 1973.).
U poglavlju o sažimanju birali smo mjeru prema obliku raspodjele i pitanju koje nas zanima. Pred grafom nas čeka slična odluka. Prikaz prosjeka može olakšati usporedbu skupina, ali sakriti razlike među osobama. Prikaz svih opažanja čuva te razlike, no može otežati čitanje. Želimo naučiti odabrati prikaz iz kojega se tražena usporedba doista može vidjeti.
Uz Datasaurus ćemo upoznati i Anscombeove skupove kao provjeru onoga što brojčani sažetak izostavlja (Anscombe 1973.). To su namjerno konstruirani parovi brojčanih vrijednosti. Jedna točka predstavlja jedan takav konstruirani par. Služe nam za ispitivanje prikaza, a doseg zaključka ograničen je na taj nastavni primjer. Usporedbom tablica i grafova provjerit ćemo što možemo previdjeti kada preuzmemo samo gotove sažetke.
Vraćamo se poznatoj tablici simulirane ankete o društvenim mrežama, anketa_mreze, koju smo upoznali pri sažimanju podataka. Svaki redak i dalje opisuje jednu zamišljenu osobu. Sada ćemo njihove dnevne minute na mrežama prikazati po dobnim skupinama. Uz tu tablicu čitat ćemo i prikaze stvarnih zbirnih podataka projekta DigiKat, vodeći računa o njihovu obuhvatu (Šikić i sur. 2026.). Primjeri se mijenjaju jer nas zanima ista odluka u različitim situacijama. Prije čitanja oznake trebamo znati predstavlja li ona osobu, skupinski sažetak ili zbroj objava.
Izbor prikaza obrazlažemo tako da čitatelj može provjeriti graf i bez programa kojim je nacrtan. Ljestvica, oznake i opis trebaju pokazati obrazac koji podaci podupiru te upozoriti na ono što je sažeto ili izostavljeno.
Gramatika grafike
Grafom odlučujemo što ćemo uspoređivati položajem, duljinom, površinom ili bojom. Izbor zato počinje pitanjem. Za raspodjelu jedne brojčane varijable trebamo vidjeti oblik, za usporedbu kategorija zajedničku osnovicu, a za odnos dviju brojčanih varijabli pojedinačna opažanja. Uredan graf neće pomoći ako skriva ono što trebamo usporediti.
Nazivi poput stupčanog ili raspršenog dijagrama označuju uobičajene kombinacije odluka. Svaki graf možemo rastaviti na te odluke i zasebno ih provjeriti.
Definicija 1 Gramatika grafike opisuje od čega je graf sastavljen. Određuje što predstavlja oznaka, koja joj je varijabla pridružena, koji je račun prethodio crtanju i kako se vrijednosti prenose u vizualne veličine.
Iz te je ideje razvijen sustav za sastavljanje grafova (Wilkinson 2005.). Jedna od njegovih poznatih programskih izvedbi jest ggplot2 (Wickham 2016.). Istim se načinom razmišljanja možemo služiti pri čitanju tiskanog grafa, bez programiranja.
Najprije provjeravamo jedinicu. Točka može predstavljati ispitanika, državu, godinu ili stranku. Ako umjesto pojedinaca prikažemo skupinske prosjeke, graf odgovara na drugo pitanje. Zato promjenu jedinice treba jasno navesti.
Geometrija određuje oblik oznake, primjerice točku, stupac ili liniju. Varijable zatim povezujemo s položajem na osima, bojom, veličinom ili oblikom oznake.
Definicija 2 Pridruživanje (aesthetic mapping) je odluka o tome koja se varijabla prikazuje kojim vizualnim obilježjem. Time određujemo što će čitatelj moći neposredno usporediti.
Ako skupine razlikujemo bojom u istom polju, lako ih uspoređujemo na zajedničkim osima. Ako ih rasporedimo u zasebna polja, lakše pratimo obrazac svake skupine. Različitim rasporedom istih podataka naglašavamo različite usporedbe.
Treba provjeriti i što je izračunato prije crtanja. Stupac koji prikazuje prosjek skriva raspodjelu. Okvir s brkovima ne pokazuje broj njezinih vrhova, a izglađena linija dodaje procijenjeni model. Graf zato može biti sažetak koji gubi dio podataka, baš kao brojčana mjera. Anscombeovi skupovi pokazuju zašto treba pogledati što je sažimanjem izostavljeno (Anscombe 1973.).
Ljestvica određuje kako se broj pretvara u vizualnu veličinu. Raspon osi, prekid, logaritamska transformacija ili sredina ljestvice boja mijenjaju prostor koji razlika zauzima. Koordinatni sustav određuje kako su položaji raspoređeni. Polarne koordinate, primjerice, uvode kut i mogu otežati usporedbu koju bismo na ravnoj osi lakše očitali.
Pri čitanju grafa zato tražimo jedinicu oznake, pridružene varijable, prethodni račun i pravilo ljestvice. Ta pitanja možemo postaviti svakom grafu, bez pristupa programu u kojem je izrađen.
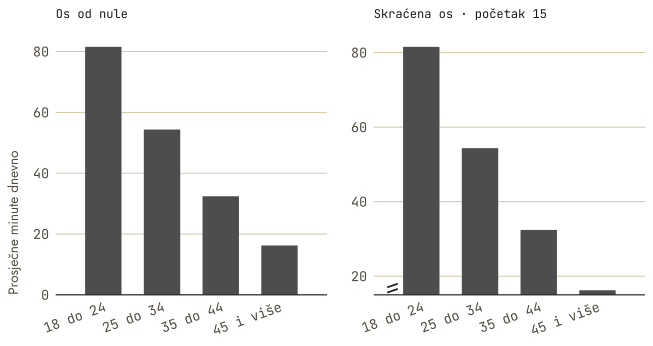
Na sljedećem prikazu jedan stupac predstavlja dobnu skupinu iz simulirane ankete anketa_mreze. Vodoravni položaj označuje skupinu, a okomiti položaj vrha prosječne dnevne minute, izračunate prije crtanja. Stupac zato sažima više osoba i ne pokazuje raspodjelu njihovih odgovora. Lijevo os počinje od nule, a desno je skraćena. Uspoređujemo iste prosjeke, ali promjena ljestvice mijenja dojam njihovih razlika.
Što oko može očitati
Grafička percepcija jest način na koji iz položaja, duljina i drugih oznaka očitavamo podatke. Neke vizualne usporedbe čitamo točnije od drugih. Pokusi s očitavanjem grafova potvrdili su prednost položaja pred duljinom i kutom (Cleveland i McGill 1984.). Povezivanjem tih rezultata s ranijim istraživanjima nastao je prijedlog šireg poretka vizualnih kanala (Cleveland i McGill 1984.). Prema tom se poretku najtočnije očitava položaj na zajedničkoj osi, zatim na istovjetnim, ali neporavnatim osima, pa duljina, kut, nagib i površina. Obujam, zakrivljenost i zasićenost boje nalaze se pri dnu (Cleveland i McGill 1984.). Cijeli taj poredak predstavlja sintezu više izvora, s različitim stupnjem izravne pokusne provjere pojedinih usporedbi.
Za usporedbu koja određuje zaključak zato biramo kanal koji se lakše očitava. Boja ili površina mogu poslužiti za razlike kod kojih je dovoljna gruba procjena. Udjele ćemo točnije usporediti stupcima na zajedničkoj osi nego kutovima kružnog dijagrama (Cleveland i McGill 1984.). Ako trebamo samo prepoznati nekoliko izrazito različitih udjela, ta prednost može biti manje važna.
Trodimenzionalna perspektiva može otežati usporedbu ravnih podataka jer duljinu kombinira s površinom i prividnim obujmom, slabijim kanalima u predloženom poretku (Cleveland i McGill 1984.). Zato prije dodavanja treće dimenzije provjeravamo donosi li novu informaciju ili samo mijenja dojam.
Pri oblikovanju grafa korisno je za svaki element razmotriti koju informaciju prenosi (Tufte 2001.). Sjene, obrubi i preljevi mogu odvlačiti pozornost bez korisnog dodatka. Rešetka, razdjelna crta ili oznaka, s druge strane, mogu olakšati čitanje. Uklanjanjem elementa možemo provjeriti otežava li njegov izostanak usporedbu ili snalaženje na grafu.
Tufteov faktor laži uspoređuje relativnu promjenu prikazanu geometrijom s relativnom promjenom u podacima (Tufte 2001.). Kada duljina ili površina izravno predstavlja količinu, omjer blizu jedan pokazuje razmjerno kodiranje. Poštenost cijeloga grafa zahtijeva i provjeru ostalih odluka pri prikazu. Skraćena os, perspektiva ili zamjena duljine površinom mogu povećati dojam i uz točne brojčane oznake. Doseg te mjere ograničen je na određene geometrijske usporedbe.
Prikaz prema tvrdnji
Prednost zajedničke osi pomaže nam izabrati način usporedbe, ali još trebamo odlučiti koje podatke graf mora sačuvati. Za oblik raspodjele trebamo drukčiji prikaz nego za usporedbu skupinskih prosjeka. Sljedeća tablica povezuje ta pitanja s brojem i vrstom varijabli te pokazuje što pojedini izbor izostavlja.
| Što se prikazuje | Uobičajeni izbor | Što prikaz čuva, a što odbacuje |
|---|---|---|
| jedna brojčana varijabla | histogram, krivulja gustoće | čuva oblik cijele raspodjele, gubi pojedinačno opažanje |
| jedna kategorijalna varijabla | stupci na zajedničkoj osi | čuva učestalosti kategorija, izostavlja pojedinačne zapise i njihova druga obilježja |
| brojčana po skupinama | okvir s brkovima | čuva medijan, kvartile i izdvojena opažanja, odbacuje broj vrhova i položaj većine opažanja |
| dvije brojčane varijable | raspršeni dijagram | čuva svako opažanje, teško podnosi velik broj točaka |
| dvije kategorijalne varijable | grupirani ili složeni stupci | čuva odnos udjela, otežava usporedbu unutar složenih stupaca |
Svaki prikaz zadržava dio informacija i izostavlja ostale. Okvir s brkovima sažima medijan i kvartile, pa može izgledati jednako za raspodjelu s jednim ili dvama vrhovima. Histogram raspoređuje opažanja u razrede i prikazuje njihove učestalosti, zbog čega lakše otkriva oblik. Više skupina, međutim, može biti teže usporediti histogramima.
Za dvije kategorijalne varijable možemo izabrati stupce jedan uz drugi, složene stupce ili stupce jednake ukupne visine koji prikazuju udjele. Usporedni stupci pokazuju apsolutne brojeve. Stupci udjela pokazuju sastav, ali skrivaju razliku između skupine od dvadeset i skupine od dvjesto osoba. Za usporedbu brojnosti uz udjele trebamo navesti i veličine skupina.
Kod složenih stupaca samo najdonji segment ima zajedničku osnovicu. Ostali počinju na različitim visinama, ovisno o prethodnim segmentima. Njihove su duljine točne, ali ih je teže usporediti bez zajedničkog početka (Cleveland i McGill 1984.). Ako zaključak ovisi o jednom takvom segmentu, korisno ga je prikazati zasebno.
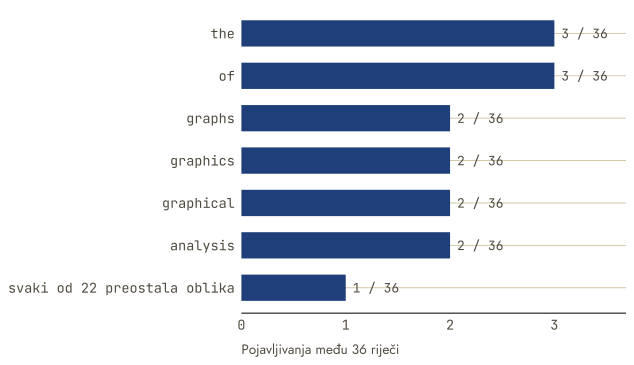
I riječi možemo uspoređivati kao kategorije, ali tek nakon što odredimo što ćemo smatrati istom riječju. Usporedit ćemo riječi u namjerno odabranim naslovima. Za širi zaključak o literaturi o vizualizaciji ili znanstvenom pisanju trebali bismo odgovarajući izbor tekstova. U šest odabranih naslova o vizualizaciji ukupno je 36 riječi i 28 različitih oblika (Anscombe 1973.; Cleveland i McGill 1984.; Tufte 2001.; Wilkinson 2005.; Wickham 2016.; Matejka i Fitzmaurice 2017.). Do tih brojeva dolazimo tako da sva slova pretvorimo u mala i uklonimo interpunkciju. Riječi ne svodimo na zajednički korijen, pa su graphs, graphical i graphics različite jedinice. Stupci će zato uspoređivati učestalost točnih oblika koje smo tako odredili.
Primjer pretvorbe daje naslov The Grammar of Graphics (Wilkinson 2005.). Nakon pretvorbe u mala slova i razdvajanja dobivamo četiri zapisa, the, grammar, of i graphics. Svaki dodaje jedan svome brojaču. Kad tako obradimo svih šest odabranih naslova, jedinica brojanja postaje pojedino pojavljivanje riječi. U Wickhamovu naslovu o paketu ggplot2 uklanjamo dvotočku, ali zadržavamo ggplot2 kao jedan oblik (Wickham 2016.).
Graf izdvaja šest oblika koji se ponavljaju. U zadnjem retku navedena je učestalost koja vrijedi za svaki od preostala dvadeset dva oblika zasebno.
Tufte, Edward R. 2001. The Visual Display of Quantitative Information. 2. izd. Graphics Press.
Wilkinson, Leland. 2005. The Grammar of Graphics. 2. izd. Springer. https://doi.org/10.1007/0-387-28695-0.
Wickham, Hadley. 2016. ggplot2: Elegant Graphics for Data Analysis. 2. izd. Springer. https://doi.org/10.1007/978-3-319-24277-4.
Matejka, Justin, i George Fitzmaurice. 2017. „Same Stats, Different Graphs“. Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems, 1290–94. https://doi.org/10.1145/3025453.3025912.
Pri tumačenju zato navodimo jedinicu, obradu teksta, nazivnik i obuhvat. Iste ćemo odluke ponovno razmotriti kada tekst postane ulaz algoritma.
Dvije varijable u istom prostoru
Stupcima smo uspoređivali količine po kategorijama. Kada želimo sačuvati odnos dviju brojčanih varijabli za svaku jedinicu, trebamo drugi raspored oznaka. Raspršeni dijagram može prikazati svako opažanje kao točku. Iz rasporeda čitamo smjer i zakrivljenost veze, podskupine i izdvojena opažanja. Zato njime počinjemo provjeru odnosa.
Ako se mnoge točke preklapaju, ne vidimo koliko opažanja stoji na istom mjestu. Djelomično prozirne točke mogu pokazati gušća područja tamnijima. Kod diskretnih vrijednosti pomaže blago razmicanje točaka, a za vrlo mnogo opažanja možemo izravno prikazati procijenjenu gustoću.
Izglađenu liniju na raspršenom dijagramu dobivamo procjenom modela odnosa iz opaženih podataka. Njezin oblik ovisi o postupku procjene i može djelovati uvjerljivo čak i kad podaci ne podupiru stabilan obrazac. Uvijek je zato čitamo uz oblak točaka. U poglavlju o regresiji razradit ćemo kako se takve linije dobivaju i provjeravaju.
Poštena ljestvica
Vraćamo se simuliranoj anketi anketa_mreze iz poglavlja o sažimanju. Prikazujemo prosječne dnevne minute na društvenim mrežama po dobnim skupinama. Raspon osi može znatno promijeniti dojam. Prosjeci se ovdje razlikuju za 65,3 minuta, odnosno 80,1 % najvećeg prosjeka. Ta je razlika stalna, ali njezina veličina na stranici ovisi o osi.
anketa_mreze. Izrada autora.
| Dobna skupina | Broj ispitanika | Prosjek | Medijan |
|---|---|---|---|
| 18 do 24 | 90 | 81,5 | 68,5 |
| 25 do 34 | 84 | 54,4 | 46,0 |
| 35 do 44 | 66 | 32,4 | 26,0 |
| 45 i više | 60 | 16,2 | 15,0 |
Tablica skupinskih sažetaka čuva vrijednosti za račun, a usporedba dviju osi pokazuje koliko dojam o istoj razlici ovisi o početku osi.
Oba prikaza koriste iste četiri vrijednosti. Desni im dodjeljuje uži raspon osi. Kod stupaca duljina predstavlja vrijednost, pa odsijecanje nule narušava tu razmjernost. U linijskom ili raspršenom grafu uspoređujemo položaje, zbog čega os može pratiti raspon podataka ako je jasno označena.
Stupce zato crtamo od nule. Oznaka skraćene osi otkriva zahvat, ali ne vraća ispravan odnos duljina. Za linije i točke uži raspon može pomoći čitanju, uz jasno vidljiv početak i ljestvicu osi.
Za sljedeći prikaz vraćamo se istim zapisima iz DigiKatove tablice internetskih domena koju smo upoznali pri sažimanju podataka. Svaki redak sadrži ukupan broj objava jedne domene u odabranom korpusu. Opisujemo samo domene u ovom korpusu, bez zaključivanja o svim hrvatskim medijima, korisnicima ili pojedinačnim objavama. Tablica ima 3 604 domene i 551 712 objava (Šikić i sur. 2026.). Medijan je 4 objave po domeni, a najveći broj 56 500. Na linearnoj bi osi većina domena bila stisnuta uz početak. Logaritamska os omogućuje da se bolje vide i manje vrijednosti jer jednak prostor dodjeljuje jednakim omjerima.
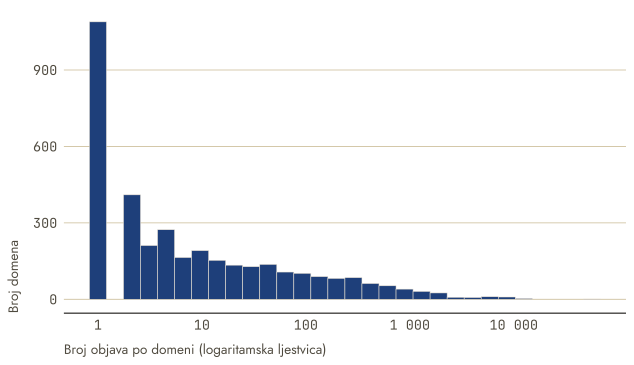
Na logaritamskoj osi pomak od 10 do 100 jednak je pomaku od 100 do 1.000. Uspoređujemo omjere, dok apsolutne razlike nisu jednako velike. Promjena osi ne mijenja zapise, ali mijenja vizualni oblik raspodjele, pa je treba označiti.
Mala višestruka polja
Kada je na grafu mnogo skupina, linije se mogu preklapati i tražiti stalno provjeravanje legende. Tada isti oblik grafa možemo ponoviti u zasebnom polju za svaku skupinu.
Definicija 3 Mala višestruka polja (small multiples) niz su prikaza istoga oblika i iste ljestvice, po jedan za svaku skupinu, tako da se razlike među skupinama očitavaju usporedbom položaja između polja.
Za usporedbu razina polja trebaju zajedničku ljestvicu. Ako svako ima svoj raspon, male i velike razlike mogu izgledati jednako. Različite osi mogu biti prikladne za usporedbu oblika, ali tu odluku treba jasno navesti.
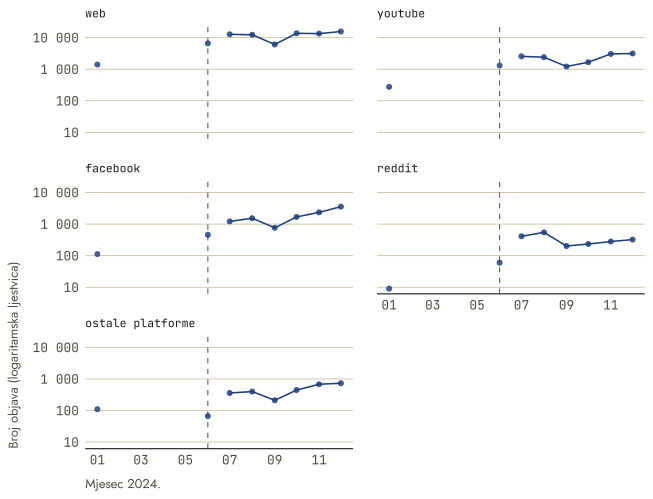
Iz iste mjesečne tablice projekta DigiKat izdvajamo zapise za promatranje prekida u mjerenju. U DigiKatovu mjesečnom izvatku za 2024. nedostaju retci od veljače do svibnja. Siječanj je djelomičan, a lipanj donosi promjenu metode i obuhvata (Šikić i sur. 2026.). Prazninu ne pretvaramo u nule niti linijom spajamo siječanj i lipanj. U tablici zadržavamo svih 12 mjeseci kako bi nedostajanje bilo vidljivo.
| Mjesec | Objave | Udio weba | Status |
|---|---|---|---|
| 01. 2024. | 1 911 | 73,5 % | djelomičan mjesec |
| 02. 2024. | — | — | nema retka |
| 03. 2024. | — | — | nema retka |
| 04. 2024. | — | — | nema retka |
| 05. 2024. | — | — | nema retka |
| 06. 2024. | 8 477 | 77,7 % | lom metode |
| 07. 2024. | 17 291 | 73,7 % | nakon promjene obuhvata |
| 08. 2024. | 17 194 | 71,6 % | nakon promjene obuhvata |
| 09. 2024. | 8 458 | 71,7 % | nakon promjene obuhvata |
| 10. 2024. | 17 725 | 77,3 % | nakon promjene obuhvata |
| 11. 2024. | 19 771 | 67,9 % | nakon promjene obuhvata |
| 12. 2024. | 23 404 | 66,9 % | nakon promjene obuhvata |
Brojem objava opisujemo mjesečnu količinu, a udjelom weba njezin sastav. Nazivnik u mjesečnoj tablici zbroj je svih platformi tog mjeseca. Ne koristimo 551.712 iz datoteke domena jer ona ima drugu jedinicu i nema zajednički ključ. U malim višestrukim poljima prikazujemo broj objava za četiri platforme s najviše objava u dostupnim mjesecima 2024. i za objedinjeni ostatak. Sva polja imaju istu logaritamsku os.
Šikić, Luka i sur. 2026. „Prikaz i analiza katoličke tematike u digitalnom medijskom prostoru“. Hrvatsko katoličko sveučilište. https://github.com/lusiki/DigiKat/tree/278a127f9170c1aca82035a4a8357b8a995f91d8.
Linije ostavljaju četveromjesečnu prazninu, a lipanjska točka odvojena je od kasnijeg niza. Zbog nepotpunog siječnja i promjene metode ne zaključujemo o trendu, rastu ili učinku promjene nakon lipnja. Možemo usporediti dostupne brojeve uz vidljiva ograničenja zapisa.
Graf pred čitateljem
Zajednička ljestvica omogućuje usporedbu samo ako čitatelj može razaznati oznake i njihov smisao. Pri izradi grafa zato treba predvidjeti crno-bijeli tisak, čitače zaslona i različite sposobnosti razlikovanja boja.
Razliku među skupinama zato uz boju označujemo oblikom točke, vrstom linije ili izravnim nazivom. Tako značenje ostaje čitljivo i bez boje. Paleta knjige koristi i razlike u svjetlini kako bi se kategorije mogle razlikovati u sivim tonovima.
Alternativni tekst treba prenijeti nalaz osobi koja ne vidi graf. Navodimo varijable, smjer veze i najizraženije obilježje obrasca. Opis konkretizira odnos, primjerice njegov smjer i oblik, kako bi čitatelj mogao razumjeti nalaz.
Pristupačnost prikaza znači da podatke može pročitati i osoba kojoj boja ili sitan tekst nisu dostupni. Izravnim oznakama uz podatke smanjujemo potrebu za traženjem naziva u legendi. Pomaže i smislen redoslijed kategorija. Kada želimo usporediti veličine, poredak po vrijednosti olakšava čitanje više od abecednog.
Iste odluke provjeravamo i pri čitanju grafa. Primijenimo ih na desno polje u Slika 2.
Jedan stupac predstavlja dobnu skupinu i služi zaključivanju na toj razini. Za opis pojedinog ispitanika trebali bismo njegove odgovore. Skupina određuje vodoravni položaj, a prosjek duljinu stupca. Boja i širina su jednake jer ne prikazuju dodatnu varijablu.
Prije crtanja izračunat je prosjek svake skupine, čime je skriven oblik raspodjele i njezin dugi desni rep. Stupac od 81,5 minuta prikazuje prosjek, dok medijan iste skupine iznosi 68,5 minuta. Os uz to ne počinje od nule, što je u nastavnom primjeru označeno.
Prosjek skriva raspodjelu, a skraćena os prikazuje neprimjerene odnose duljina. Brojevi su točni, ali graf može navesti na pretjeran dojam razlike i pogrešno shvaćanje tipičnog ispitanika. Oznaka zahvata omogućuje da problem uočimo, ali ga ne uklanja.
Histogram grupira brojčane vrijednosti u razrede. Visina stupca ovdje broji opažanja u razredu jednake širine, a drukčija širina razreda može promijeniti dojam o obliku. Krivulja gustoće zaglađuje raspodjelu, pa njezina visina nije broj osoba. Kutijasti prikaz čuva medijan i srednjih 50 % opažanja između prvoga i trećega kvartila. U sljedećem prikazu brkovi sežu do najudaljenijih opažanja unutar 1,5 interkvartilnog raspona od kutije. Udaljenija opažanja prikazuju se zasebno. Takva točka nije automatski pogreška.
Sažimanje u dvije sredine skriva razlike među pojedincima. Zasebno pitanje jest nesigurnost procjene populacijske sredine. Nju procjenjujemo prema načinu odabira opažanja, što ćemo razraditi uz uzorkovanje i procjenu.
Interakcija — Isti podaci, četiri grafa
Za ovu ilustraciju stvaramo zaseban skup od 72 opažanja, po 36 u dvjema skupinama. U svakoj ravnomjerno rasporedimo vrijednosti \(x\) od 1 do 10. Polazište ishoda je \(1,5 + 0,55x\), skupini B dodajemo 0,8, a svakoj točki neovisno normalno odstupanje sa sredinom nula i standardnom devijacijom 0,85. Na primjer, pri \(x=1\) polazište je 2,05 za A i 2,85 za B, prije slučajnog odstupanja. Varijable nemaju stvarnu mjernu jedinicu. Četiri grafa prikazuju isti skup od 72 zapisa.
Isti simulirani podaci prikazani su na četiri načina. Svaki graf olakšava jednu usporedbu i skriva dio drugih informacija. Raspršeni dijagram čuva odnos dviju varijabli, dok prikaz sredina sažima razliku među skupinama. Izbor ovisi o pitanju na koje želimo odgovoriti.
Što isprobati.
- Odaberite raspršeni dijagram i opišite odnos varijabli bez sažimanja po skupinama.
- Prijeđite na histogram i utvrdite koja je prethodna informacija nestala.
- Usporedite raspodjelu po skupinama s prikazom njihovih sredina.
- Odaberite graf za tvrdnju o razlikama među tipičnim ishodima i obrazložite izbor.
Kružni dijagram pred konkretnim zadatkom. Pretpostavimo da kulturna ustanova priprema prikaz posjećenosti svojih programa. Treba pokazati koji programi okupljaju sličan udio publike, a koji se jasno izdvajaju. Netko predlaže kružni dijagram jer svaki program zauzima dio ukupne posjećenosti. Drugi ga odbacuje pozivajući se na pravilo da se takvi grafovi nikada ne koriste. Prije izbora valja razjasniti što čitatelj treba moći usporediti.
Točnost očitavanja može se provjeriti pokusom. U jednom takvom istraživanju sudionici su procjenjivali omjer dviju istaknutih vrijednosti na grafu (Cleveland i McGill 1984.). Položaj na zajedničkoj osi omogućavao je preciznije usporedbe od kuta (Cleveland i McGill 1984.). Nalaz daje razlog za izbor prikaza, ali taj je razlog vezan uz određeni zadatak.
U našem zamišljenom izvještaju osobito nas zanimaju programi s bliskim udjelima. Na kružnici bismo uspoređivali slične kutove u različitim položajima. Na poredanim stupcima s istom početnom osi možemo usporediti njihove završetke, a uz oznake pročitati i točne udjele. Takav izbor olakšava upravo usporedbu zbog koje pripremamo izvještaj. Iz samoga grafa ipak ne saznajemo zašto neki program privlači više ljudi ni zaslužuje li zato više sredstava.
Kad bi nam namjera bila samo pokazati da jedan program zauzima približno polovinu cjeline, zahtjev za preciznošću bio bi drukčiji. Clevelandov i McGillov pokus ne predstavlja ispitivanje svake moguće uporabe, pamćenja ili razumijevanja grafa u stvarnom izvještaju (Cleveland i McGill 1984.). Zato iz njega ne izvodimo zabranu koja bi zamijenila prosudbu o publici i svrsi prikaza.
Ustanova može izabrati stupce i objasniti zašto ih bira. Pritom treba imenovati broji li posjete ili različite posjetitelje, jer dobar oblik grafa ne popravlja nejasnu jedinicu. Prikladnost grafa procjenjujemo prema tome koliko jasno prikazuje usporedbu važnu za naše pitanje.
Za izvještaj treba usporediti udjele triju kategorija. U ovoj konstruiranoj vježbi kategorijama A, B i C pripada 30 %, 40 % i 30 % iste cjeline. Asistent je iz tih podataka nacrtao sljedeći prijedlog. Pregledajte odnos između oznaka, visina i izgleda stupaca.
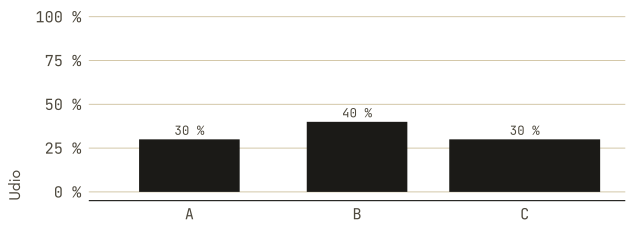
Odluka o širini vidi se i u dijelu poziva kojim je prijedlog izrađen.
Os počinje od nule, sve kategorije imaju oznaku i vrijednosti su prikazane. Šira treća kategorija samo popravlja optičku ravnotežu i ne mijenja dojam o odnosu udjela.
Usporedite posebno A i C. Pripremite uputu osobi koja uređuje graf, s jednom potrebnom izmjenom i dvjema odlukama koje treba zadržati. Objasnite na kojem dijelu prikaza temeljite izmjenu. Ne trebate pisati kod.
Razrađeni primjer
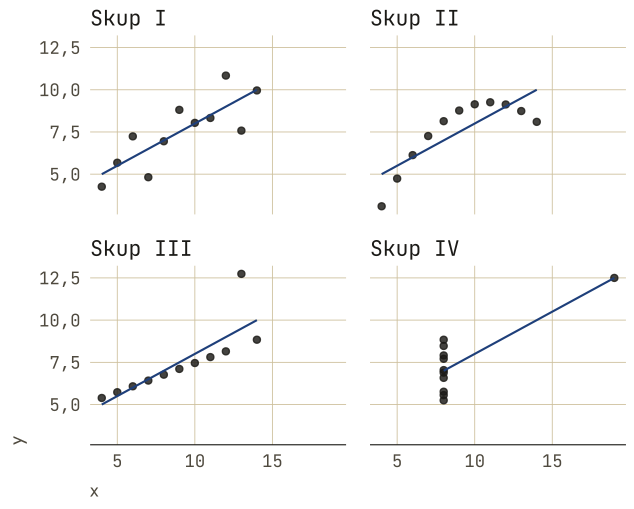
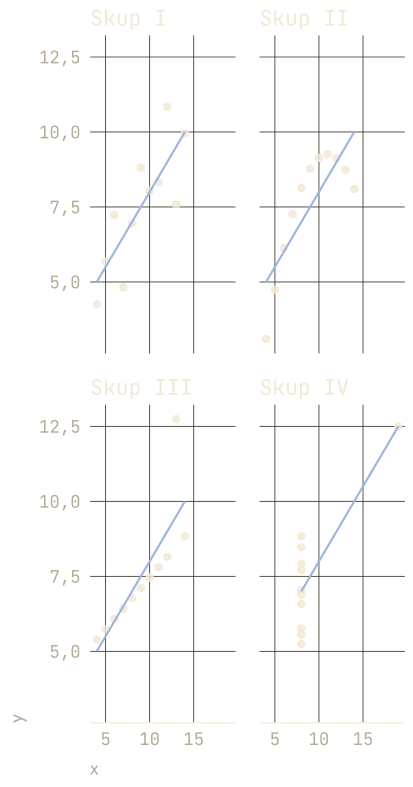
Datasaurus nas je iznenadio oblicima koje sažeci nisu otkrili. Sada ćemo istu pouku provjeriti na Anscombeovu kvartetu, četirima konstruiranim skupovima s gotovo jednakim sažecima (Anscombe 1973.). Njihove ćemo točke rasporediti u mala višestruka polja i provjeriti što zajedničke osi otkrivaju. R-ovi ugrađeni podaci anscombe reproduciraju taj objavljeni primjer.
U svakom od četiriju skupova ima 11 parova. Prva tri para iz prvih dvaju skupova pokazuju da ista vrijednost \(x\) može biti povezana s drukčijim \(y\).
| Redak | x I | y I | x II | y II |
|---|---|---|---|---|
| 1 | 10 | 8,04 | 10 | 9,14 |
| 2 | 8 | 6,95 | 8 | 8,14 |
| 3 | 13 | 7,58 | 13 | 8,74 |
U prvom retku oba skupa imaju \(x=10\), ali ishode 8,04 i 9,14. Za sredinu prvoga skupa zbrajamo svih 11 ishoda, dobivamo 82,51 i dijelimo s 11. Isti račun ponavljamo za ostala tri skupa, a grafovima zadržavamo svaki izvorni par.
Kod u ovom primjeru koristi pakete ggplot2, dplyr i tibble, učitane u pripremi knjige. Njihova je priprema opisana u mrežnom R praktikumu. Najprije provjeravamo sažetke. Zaokružene na dvije decimale, sve četiri sredine ishoda iznose 7,50, a standardne devijacije 2,03. Iz tih se vrijednosti razlike u obliku ne mogu prepoznati.
Prikaži kod
anscombe_dugo <- bind_rows(
  tibble(skup = "Skup I", x = anscombe$x1, y = anscombe$y1),
  tibble(skup = "Skup II", x = anscombe$x2, y = anscombe$y2),
  tibble(skup = "Skup III", x = anscombe$x3, y = anscombe$y3),
  tibble(skup = "Skup IV", x = anscombe$x4, y = anscombe$y4)
)

p_anscombe <- ggplot(anscombe_dugo, aes(x, y)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~ skup, ncol = 2)
U prvom dijelu postupka svaki par vrijednosti dobiva vlastiti redak, kako bi u drugome mogao postati jedna točka. Poziv aes određuje koja vrijednost ide na koju os, a geom_point crta te točke. Da bismo usporedili oblik podataka s njihovim linearnim sažetkom, geom_smooth dodaje procijenjeni odnos, dok facet_wrap odvaja skupove u zasebna polja. Upisom p_anscombe prikazujemo pohranjeni graf. Dodani pravci gotovo se podudaraju, kao u izvornom primjeru (Anscombe 1973.). U kasnijim je primjerima dovoljno prepoznati koju od tih odluka pojedini naziv provodi.
Uz gotovo jednake sažetke četiriju skupova (Anscombe 1973.), graf koristi jednake osi i gotovo podudarne pravce. Tako razlike među poljima proizlaze iz rasporeda opažanja.
Anscombe, F. J. 1973. „Graphs in Statistical Analysis“. The American Statistician 27 (1): 17–21. https://doi.org/10.1080/00031305.1973.10478966.
Prvi skup približno prati pravac, a drugi zakrivljenu vezu. U trećem i četvrtom izdvojeno opažanje snažno utječe na pravac. Brojčani sažetak zato čitamo zajedno s oblikom podataka koje sažima.
Sažetak
Graf počinje od usporedbe koju želimo omogućiti, pa jedinicu oznake, varijable, prethodni račun i ljestvicu biramo zajedno. Tim izborom dio podataka pokazujemo, a dio sažimamo ili izostavljamo, kao što su gotovo jednaki Anscombeovi sažeci skrivali različite oblike. Položaj i drugi vizualni kanali ne omogućuju jednako precizno očitanje (Cleveland i McGill 1984.), pa zajedničke osi, prikladno razdvajanje skupina i oznake uz boju pomažu da tražena usporedba ostane čitljiva. Kada prikazujemo riječi, isto obrazloženje obuhvaća pravilo brojanja i izbor tekstova. U poglavlju o povezanosti krenut ćemo od raspršenog dijagrama i provjeriti koliko njegova oblika možemo sažeti jednim koeficijentom.
Cleveland, William S., i Robert McGill. 1984. „Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods“. Journal of the American Statistical Association 79 (387): 531–54. https://doi.org/10.1080/01621459.1984.10478080.
Pojmovi
- gramatika grafike
- grammar of graphics
- pridruživanje
- aesthetic mapping
- geometrija grafa
- geom
- ljestvica
- scale
- grafička percepcija
- graphical perception
- prikaz učestalosti riječi
- word-frequency plot
- logaritamska ljestvica
- logarithmic scale
- skraćena os
- truncated axis
- mala višestruka polja
- small multiples
- pristupačnost prikaza
- visualization accessibility
- alternativni tekst
- alternative text
- Anscombeov kvartet
- Anscombe’s quartet
- utjecajno opažanje
- influential observation
Zadaci
Konceptualni
Odaberite prikaz za raspodjelu jedne varijable, usporedbu kategorija i odnos dviju brojčanih varijabli. Za svaki obrazložite izbor i navedite što izostavlja. Za jedan graf napišite alternativni tekst koji prenosi nalaz te provjerite je li nalaz razumljiv i bez boje.
Računski
Iz tablice skupinskih sažetaka uzmite najveći i najmanji prosjek dnevnih minuta. Izračunajte njihovu razliku, a zatim je podijelite s većim prosjekom i pretvorite u postotak. Usporedite dobiveni postotak s dvama prikazima osi i objasnite zašto se brojčana razlika nije promijenila, premda se promijenio vizualni dojam. Predajte račun, postotak i dvije rečenice prosudbe. Svi potrebni podaci nalaze se u tablici.
Kritički
Pronađite objavljeni graf sa skraćenom osi i prosudite je li odsjecanje opravdano. Odredite koliki bi udio visine osi zauzela razlika kada bi donja granica bila nula, a gornja ostala ista, je li prekid vidljivo označen i mijenja li se zaključak teksta uz graf. Predajte odlomak s presudom i s uvjetom pod kojim bi presuda bila suprotna.
Revizija modela
Provjerite prijedlog grafa iz okvira o pogrešci. Navedite ispravne grafičke odluke i izdvojite onu koja obmanjuje. Opišite što treba promijeniti da udio ponovno bude prikazan samo duljinom stupca. Opis predajte bez pisanja ili popravljanja koda.