| Dobna skupina | Ispitanika | Minuta dnevno | Povjerenje (bodovi) |
|---|---|---|---|
| 18 do 24 | 90 | 81,5 | 6,38 |
| 25 do 34 | 84 | 54,4 | 5,56 |
| 35 do 44 | 66 | 32,4 | 4,89 |
| 45 i više | 60 | 16,2 | 4,50 |
Vaše prvo istraživanje
Od pitanja do provjerljivog zaključka
Tim ima tri tjedna za završni projekt, zanimljivu temu i datoteku koju još treba pripremiti. Jedan član želi odmah procijeniti model, drugi prvo provjeriti mjerenje, a treći predlaže da posao ubrzaju slanjem datoteke javnom asistentu.
Prije toga trebaju razjasniti što predstavlja redak, odakle podaci dolaze i koje pitanje žele postaviti. Trebaju provjeriti i sadrži li datoteka informacije po kojima se ljudi mogu prepoznati.
Kako provesti prvo istraživanje tako da druga osoba može pratiti odluke i provjeriti zaključak?
U završnom projektu iskustvo čitanja tuđih zaključaka primjenjujemo na vlastito istraživanje. Postupak trebamo sastaviti tako da ga druga osoba može pratiti. Pitanje, mjerenje, priprema podataka, graf i model moraju se odnositi na istu istraživačku namjeru. Te odluke povezujemo u jednom istraživanju i ostavljamo zapis koji omogućuje provjeru rezultata.
Vraćamo se istim zapisima svih 300 zamišljenih osoba iz skupa anketa_mreze, koje poznajemo iz sažimanja, vizualizacije i povezanosti. Svaki redak predstavlja jednu zamišljenu osobu s dobi, dnevnim minutama na društvenim mrežama i povjerenjem u tamošnji sadržaj. To je zaseban skup od populacije iz koje smo izvlačili uzorke u inferencijalnim poglavljima. Istražit ćemo jesu li duže dnevno korištenje mreža i veće povjerenje povezani te kako se procjena mijenja kada uvažimo dob. Time vježbamo istraživanje odnosa, bez tvrdnje da smo prikupili dokaze o stvarnim korisnicima ili uzroku njihova povjerenja.
Za svaki poznati postupak sada trebamo objasniti zašto ga koristimo. Odredit ćemo pitanje i granicu nacrta, pregledati zapise i dokumentirati pripremu, a zatim opisati raspodjele i nacrtati odnos. Regresijsku procjenu s intervalom usporedit ćemo s opravdanom alternativom. Razlike među rezultatima vratit će nas na odluke o tome što model uspoređuje. Iz tog ćemo rada sastaviti izvještaj koji se može razumjeti bez otvaranja računalnog zapisa, uz sačuvan trag za ponavljanje računa.
Postupak ćemo potom provjeriti na stvarnim parlamentarnim rečenicama iz ParlaSenta, gdje ćemo umjesto osobnih odgovora pratiti izbor tekstova i nastanak oznaka (Mochtak i sur. 2023., 2024.). Za nove podatke oblikovat ćemo pitanje koje odgovara njihovoj jedinici i načinu nastanka.
U oba primjera odlučivat ćemo što povjeriti asistentu, kako provjeriti njegov rad i što smijemo dijeliti. Na kraju treba biti jasno kako smo od pitanja i podataka došli do zaključka i za koje odluke odgovaramo. Zato rad počinjemo od pitanja koje zaista možemo istražiti.
Pitanje prije podataka
Tema određuje područje interesa, a pitanje određuje što ćemo istražiti. Medijske navike, angažman na mrežama ili formati naslova tek su početak. Za istraživačko pitanje trebamo imenovati populaciju, jedinicu, mjere i usporedbu.
U tablici su tri moguća smjera semestralnog rada. Razlikuju se prema izvoru podataka i zaključcima koje nacrt dopušta.
| Smjer rada | Odakle podaci | Što dizajn dopušta |
|---|---|---|
| Anketa među kolegama | vlastito prikupljanje | opis skupine i povezanosti unutar nje |
| Analiza javno dostupnih objava | postojeći zapis | opis i predviđanje, bez uzročne tvrdnje |
| Usporedba dviju verzija poruke | nasumična dodjela uvjeta | usporedba koja uz očuvanu dodjelu podnosi ograničen uzročni jezik |
Prva dva smjera promatraju postojeće podatke, a treći nasumično dodjeljuje uvjete. Kasnija analiza ne može promijeniti njihov dokazni doseg. I kod randomizacije uzročni zaključak ovisi o očuvanoj dodjeli, mjerenju, pridržavanju uvjeta, osipanju i mogućem utjecaju jedne skupine na drugu.
U vođenoj analizi skupa anketa_mreze ishod je povjerenje u sadržaj na društvenim mrežama na ljestvici od jedan do deset, a prediktor dnevno vrijeme uporabe u minutama. Dob ćemo uključiti kako bismo usporedili osobe jednakih godina. Time naše pitanje o vezi vremena i povjerenja dobiva određene varijable i usporedbu koju možemo izračunati.
Naše pitanje odnosi se na povezanost. Razlikujemo ga od opisa podataka, prijenosa na populaciju, predviđanja novih opažanja, procjene uzroka i odluke o postupanju. Regresiju ćemo tumačiti u okviru odabranog pitanja o povezanosti.
Već na početku dogovaramo što će drugoj osobi trebati da razumije i provjeri naš rad. Samostalan izvještaj treba prenijeti pitanje i zaključak, a ponovljiv zapis postupka pokazati kako je nastala svaka tablica i graf. Uz njih predajemo podatke koje smijemo dijeliti, kratko izlaganje i osvrt. Zapis može biti skripta ili dokumentirana povijest rada s izvozom iz alata bez koda. Izlaganjem ćemo dodatno provjeriti možemo li rezultat objasniti vlastitim riječima.
Definicija 1 Paket dokaza je provjerljiva cjelina koja povezuje putovnicu skupa podataka, zapis izvora i verzije, dnevnik transformacija, analizu, provjeru osjetljivosti, granicu tvrdnje, zapis o uporabi asistenta i objavu.
Svaki dio te cjeline odgovara na određeno pitanje. Najprije nas putovnica skupa podataka vraća izvoru, verziji i obuhvatu podataka kako bismo znali od čega je istraživanje počelo. Put od tog izvornika do redaka koje analiziramo čuva dnevnik transformacija. U njemu možemo slijediti svaku promjenu i ponoviti pripremu tablice.
Razloge zbog kojih smo odabrali upravo te korake povezuje trag odluka. Važan je i trenutak u kojem je odluka donesena. Za potvrđujuću analizu pitanje i glavne postupke zapisujemo prije uvida u ishode. U izvještaju zato možemo odvojiti unaprijed planirane odluke od onoga što su nam tek podaci sugerirali. Kada nas opaženi obrazac potakne na novo pitanje, provodimo istraživačku analizu i jasno je tako označujemo.
Da bismo vidjeli ovisi li zaključak o pojedinoj odluci, dodajemo provjeru osjetljivosti. Primarnu analizu uspoređujemo s obranjivom alternativom i bilježimo što se promijenilo u procjeni, intervalu i tumačenju. Uz te rezultate navodimo i granicu tvrdnje, kako čitatelj ne bi morao nagađati što podaci i nacrt podupiru, a što ostaje nedostupno.
Kada druga osoba može od istoga izvora ponoviti promjene i dobiti naše rezultate, ostvarili smo reproducibilan tijek rada. Time joj otvaramo račun za provjeru, ali još trebamo objasniti njegovo značenje. To čini pošten izvještaj, u kojem uz procjenu i interval navodimo jedinice, dosegnutu populaciju i ograničenje koje bi moglo promijeniti zaključak.
Provjerljivost rada traži i dogovor o podacima i pomoći koju ćemo koristiti. U projektu zato primjenjujemo minimizaciju podataka, prema kojoj koristimo najmanji opseg podataka potreban za opravdanu svrhu. Da bi bilo jasno tko je pomogao u kojem koraku i kako je njegov rad provjeren, prilažemo i objavu uporabe asistenta. To su dijelovi datirane politike kolegija, a ne opća pravna tumačenja.
Dizajn određuje granicu zaključka
Presječna anketa bilježi vrijeme uporabe i povjerenje u istom trenutku, pa njihov vremenski redoslijed ostaje otvoren. Ista povezanost mogla bi nastati zato što uporaba povećava povjerenje, zato što povjerenje povećava uporabu ili zato što obje varijable ovise o trećoj.
Način uključivanja ispitanika određuje na koga se rezultat može odnositi. Prigodna anketa među kolegama sa studija nema sama po sebi osnovu za zaključak o svim studentima ili mladima. Veći broj odgovora iz istog ograničenog kruga ne rješava selekciju.
Mjere biramo prije prikupljanja. Dnevnu uporabu možemo mjeriti samoprocjenom, očitati iz izvještaja uređaja ili približno opisati brojem otvaranja aplikacije. Svaka mjera zahvaća uporabu na drukčiji način. Samoprocjenu je lako prikupiti, a veličinu i obrazac njezine pogreške trebamo zasebno provjeriti. U izvještaju zato jasno opisujemo način mjerenja.
Veličinu uzorka planiramo prema željenoj preciznosti i pretpostavkama o podacima. Potom provjeravamo izvedivost. Ako traženi broj nije dostupan, prilagodimo plan ili doseg pitanja prije prikupljanja.
U jednostavnom hipotetskom planu za srednju ocjenu povjerenja pretpostavimo standardnu devijaciju od 2 boda i ciljnu marginu od 0,5 boda za 95-postotni interval. Normalna aproksimacija daje \(n \approx (1,96 \times 2 / 0,5)^2 = 61,47\), pa početni plan traži najmanje 62 potpuna odgovora. Taj račun pretpostavlja neovisni slučajni uzorak i zadanu standardnu devijaciju. Neodaziv i prigodni odabir traže zasebnu procjenu.
U planu unaprijed zapisujemo glavno pitanje, model i postupanje s nedostajućim odgovorima. Naknadne odluke također su dopuštene, ali ih u izvještaju označujemo kao istraživačke.
Možemo isprobati i analizu koju nismo planirali. Zapis nam omogućuje da je jasno razlikujemo od prvotnog postupka, kako smo naučili u poglavlju o krizi i obnovi.
Podaci i zapis odluka
Uz podatke bilježimo izvor, verziju, licencu, datum preuzimanja ili prikupljanja i način uključivanja jedinica. Taj zapis omogućuje provjeru podrijetla i obuhvata rezultata.
Prije procjene modela spremamo konačnu analitičku tablicu i opis njezina nastanka. Za naš simulirani primjer zapis izgleda ovako.
| Odluka | Provedba u glavnoj studiji | Na što bi drukčija odluka utjecala |
|---|---|---|
| jedinica | jedna simulirana osoba | nazivnike, ovisnost redaka i smisao procjene |
| prihvatljivost | svih 300 jedinica iz generatora | skup ljudi koje rezultat opisuje |
| spajanja | nema spajanja tablica | broj i identitet redaka |
| prekodiranja | dob je sažeta u četiri skupine samo za opis i prikaz | položaj skupina na grafu, ne primarni model s dobi |
| transformacije | nagib po minuti prikazuje se kao razlika povezana s 30 dodatnih minuta | mjerilo, ali ne i prilagodbu modela |
| isključenja | nema isključenih redaka | doseg uzorka i moguću procjenu |
| nedostajuće vrijednosti | nema ih. U stvarnom radu naveli bismo broj po varijabli i pravilo postupanja | uzorak koji ulazi u svaki račun |
Izvornu datoteku čuvamo neizmijenjenu. Popravke, preimenovanja i isključenja provodimo u odvojenim, dokumentiranim koracima koje možemo ponoviti. Tako se svaka vrijednost može pratiti do izvora.
Na početku pregledavamo imena, kontakte, adrese, otvorene odgovore i kombinacije obilježja koje mogu otkriti osobu. Odlučujemo jesu li potrebni i kako ih smijemo koristiti. Pravila ovog projekta povezana su s poglavljem o mjerenju i Dodatkom F.
Pri čišćenju za svaku promjenu zapisujemo razlog.
- Provjeravamo nedostajuće vrijednosti i bilježimo koliko ih je i gdje su.
- Tražimo nemoguće vrijednosti, dakle dob od dvjesto godina ili udio veći od sto posto.
- Za svaku izvedenu varijablu zapisujemo iz čega je nastala i po kojem pravilu.
- Za svako isključeno opažanje zapisujemo razlog prije nego što smo vidjeli kako to isključenje mijenja rezultat.
Vraćamo se na istih 300 zapisa iz opisnih poglavlja, bez novog izvlačenja. Generator određuje četiri dobne skupine i unutar njih zasebno stvara minute i povjerenje. Pri povratku na istraživačko pitanje zadržavamo izvorne zapise. Provjera pripreme zato uspoređuje izvorne vrijednosti s dopuštenim rasponima i potvrđuje da je u analizu ušlo svih 300 osoba.
Simulirana anketa ima 300 ispitanika, bez nedostajućih vrijednosti. Svi su odgovori u dopuštenim rasponima. Dnevno vrijeme ide od 3 do 248 minuta. Provjeru bilježimo i kada ne pronađemo problem.
Za nedostajuće odgovore unaprijed određujemo postupak. Brisanje svih nepotpunih redaka smanjuje uzorak i može promijeniti njegov sastav. Ne pretpostavljamo da odgovori nedostaju slučajno. Ako analiziramo samo potpune retke, prikazujemo koliko vrijednosti nedostaje po varijabli i navodimo tu odluku. Takva analiza može ostati pristrana i opisivati uži skup, što treba prenijeti u zaključak.
Opis i graf prije modela
Nakon provjere zapisa najprije opisujemo sastav simuliranog uzorka te raspodjele vremena i povjerenja. Taj će nam pregled pomoći protumačiti odnos vremena i povjerenja prije nego što ga sažmemo jednim koeficijentom. Primjerice, za minute zbrajamo svih 300 odgovora i dobivamo 15 019. Dijeljenjem s 300 nastaje sredina, dok medijan dobivamo iz 150. i 151. vrijednosti nakon poredanja. U tablici po dobi ponavljamo isti postupak unutar svake skupine, koristeći njezin broj osoba kao nazivnik.
Prosječna dob iznosi 34,5 godina. Dnevno vrijeme ima prosjek 50,1 minuta i medijan 39. Prosječno povjerenje iznosi 5,45 boda, uz standardnu devijaciju 1,79.
Prosjek vremena veći je od medijana jer je raspodjela desno asimetrična. Manjina visokih vrijednosti podiže prosjek. Zato prikazujemo obje mjere.
Po dobnim skupinama vidi se dodatni obrazac. Dnevno vrijeme pada s 81,5 minuta među najmlađima na 16,2 među najstarijima. Povjerenje pada s 6,38 na 4,50 boda. Obje mjere povezane su s dobi.
Grafom provjeravamo oblik odnosa, utjecaj krajnjih opažanja i promjene raspršenosti. Time započinjemo dijagnostiku, ali još nismo provjerili sve pretpostavke višestrukog modela.
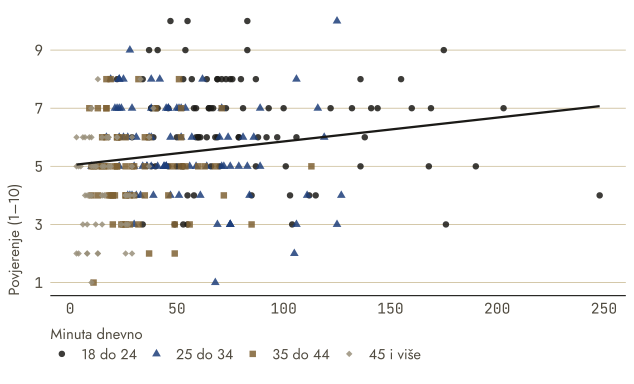
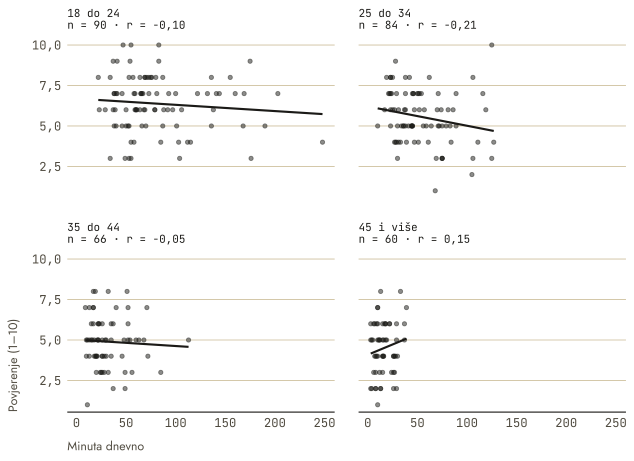
Zbirni pravac blago raste. Dobne oznake pokazuju da su mlađi uglavnom desno i više, a stariji lijevo i niže. Unutar dobnih skupina nema istog uzlaznog obrasca. Zasebne korelacije kreću se od -0,21 do 0,15.
Sličan smo odnos unutar skupina i ukupno vidjeli u poglavljima o povezanosti i regresiji. Ovdje ga graf otkriva prije modela i pomaže nam odabrati smislenu usporedbu.
Zasebni paneli omogućuju da zbirni obrazac usporedimo s odnosom unutar svake skupine. Koristimo iste osi, a naslov svakog panela daje broj osoba i Pearsonovu korelaciju. Pravac je procijenjen zasebno u svakom panelu.
Model i promjena procjene
Na grafu smo vidjeli zašto zbirni odnos vremena i povjerenja treba usporediti s odnosom pri jednakoj dobi. U primarnom modelu zato zadržavamo ranije postavljeno pitanje, s povjerenjem kao ishodom i dnevnim vremenom kao glavnim prediktorom. Dob uključujemo prema unaprijed obrazloženoj pretpostavci da je povezana s objema mjerama. Tako ćemo moći odvojeno pročitati zbirnu i dobno prilagođenu procjenu.
Prikaži kod
primarni <- lm(povjerenje ~ minute_dnevno + dob,
               data = anketa_mreze)
bez_prilagodbe <- lm(povjerenje ~ minute_dnevno,
                    data = anketa_mreze)

rbind(
  primarni = c(
    Procjena = coef(primarni)[["minute_dnevno"]],
    confint(primarni)["minute_dnevno", ]
  ),
  osjetljivost = c(
    Procjena = coef(bez_prilagodbe)[["minute_dnevno"]],
    confint(bez_prilagodbe)["minute_dnevno", ]
  )
)
Procjena 2,5 % 97,5 %
primarni -0,0002774402 -0,006211828 0,005656947
osjetljivost 0,0082048533 0,003088870 0,013320837Prije sažetka nagiba možemo pogledati predviđanja za tri postojeća retka simulirane ankete. Predviđanja obaju modela dobivamo uvrštavanjem istih minuta, a u primarnom modelu i dobi. Predviđanja su rezultat modela pridružen postojećim odgovorima ispitanika.
| Osoba | Dob | Minute | Opaženo | Zbirni | Uz dob |
|---|---|---|---|---|---|
| I001 | 22 | 69 | 6 | 5,60 | 6,00 |
| I002 | 22 | 53 | 8 | 5,47 | 6,00 |
| I003 | 24 | 83 | 10 | 5,72 | 5,90 |
Primarni model trećoj osobi pridružuje 5,90 umjesto opaženih 10 bodova. Opaženo minus predviđeno daje rezidual 4,10. Taj rezidual i preostalih 299 reziduala ulaze u račun prilagodbe i nesigurnosti koeficijenata. Interval za nagib po minuti nastaje dodavanjem i oduzimanjem standardne pogreške 0,0030 pomnožene kritičnom t-vrijednošću uz 297 stupnjeva slobode. Množitelj t čitamo kao u poglavlju o dvjema grupama. On određuje granicu središnjih 95 % referentne raspodjele pri tim stupnjevima slobode. Taj račun pretpostavlja prikladan linearni model i zajedničku rezidualnu varijancu. Njihovu primjerenost procjenjujemo zasebnim dijagnostičkim pregledom.
Prvi model uključuje dob, a drugi pokazuje kako se procjena mijenja kada je izostavimo. Poziv rbind spaja njihove rezultate u dva retka, dok confint daje granice intervala. Taj ispis izražava razliku po jednoj dodatnoj minuti. U sljedećoj tablici i procjenu i obje granice množimo s trideset kako bismo ih čitali za pola sata više dnevnog vremena, bez promjene samih modela.
| Model | Razlika u bodovima | 95 % interval | R², udio varijance |
|---|---|---|---|
| Primarni model s linearnom prilagodbom za dob | -0,01 | -0,19 do 0,17 | 10,8 % |
| Provjera osjetljivosti samo s vremenom | 0,25 | 0,09 do 0,40 | 3,2 % |
Primarna analiza uspoređuje modelom predviđeno povjerenje pri jednakoj dobi, uz linearnu i aditivnu prilagodbu. Kao što smo vidjeli u regresiji, takav zapis ne uparuje ljude niti nasumično dodjeljuje uporabu mreža. Uz trideset minuta više dnevnog vremena procijenjena razlika iznosi -0,01 boda, uz 95 % interval od -0,19 do 0,17. Interval dopušta male razlike u oba smjera.
Za provjeru osjetljivosti izostavljamo dob i vraćamo se zbirnoj usporedbi, u kojoj se s vremenom na mrežama može mijenjati i dobni sastav. Procjena tada iznosi 0,25 boda, uz 95 % interval od 0,09 do 0,40, bez nule. Isti podaci o 300 osoba daju drukčiju usporedbu. Alternativa pokazuje važnost uključivanja dobi za tumačenje. Zadržavamo je uz primarnu analizu kako bi čitatelj mogao usporediti oba pitanja i rezultata.
Ovdje opisujemo povezanost uz prilagodbu za dob. Predviđanje novih osoba tražilo bi zasebnu provjeru na odvojenim podacima, a uzročno tumačenje nacrt koji razdvaja moguća objašnjenja. Naša analiza ostaje u okviru presječne povezanosti.
Izostavljanjem dobi ispitali smo njezinu važnost. Sada dodajemo ciljanu provjeru prikladnosti linearnoga dobnog člana. Dob zamjenjujemo dobnim skupinama koje koristi generator. Svaka skupina dobiva vlastiti odsječak, a nagib uz minute ostaje zajednički. Ta provjera koristi poznato pravilo nastavnih podataka. U stvarnom istraživanju takvo pravilo ne bismo znali unaprijed.
Sljedeća tablica zadržava iste osobe i pokazuje promjenu procjene pri zamjeni linearnoga dobnog člana skupinama. Oba intervala i dalje počivaju na modelu sa zajedničkom rezidualnom varijancom.
| Prilagodba | Procjena | Donja | Gornja |
|---|---|---|---|
| Linearna dob | -0,008 | -0,186 | 0,170 |
| Dobne skupine | -0,160 | -0,343 | 0,024 |
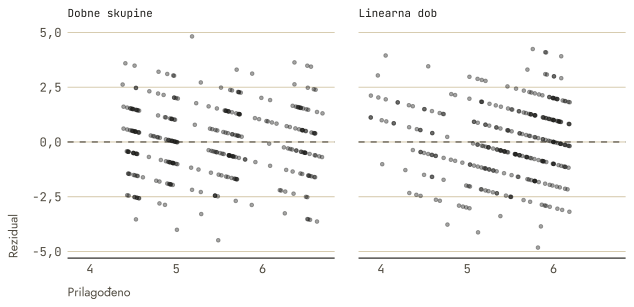
Reziduale obaju modela također uspoređujemo. Sustavno zakrivljenje ili promjena raspršenosti upozorili bi da sama zamjena dobnog člana nije dovoljna. Prikaz je dijagnostička provjera, a ne dokaz da su pretpostavke ispunjene.
Koeficijent \(R^2\) iz ranije tablice izračunat je kao \(1-\sum_i(y_i-\hat y_i)^2/\sum_i(y_i-\bar y)^2\). Brojnik je zbroj kvadrata reziduala, a nazivnik zbroj kvadrata odstupanja od ukupne sredine. On opisuje prilagodbu ovim podacima, ne uzročni udio ni uspjeh predviđanja novih osoba. Ovaj završni primjer namjerno prati jedan regresijski model i njegovu dokumentaciju. Ne pokušava primijeniti svaki postupak iz knjige.
U dijagramima ostataka kose usporedne trake nastaju zato što povjerenje ima cjelobrojne vrijednosti od jedan do deset. Za svaku od njih ostatak je ta vrijednost umanjena za predviđanje. Dobne skupine bolje prate poznato pravilo nastanka ovih simuliranih podataka. Razlika dviju procjena za minute pokazuje koliko linearna prilagodba dobi može ostaviti dio skupnog obrasca u tom koeficijentu. Ni jedan model time nije postao uzročna analiza.
Zaključak koji uzorak podnosi
Zaključak povezuje oba računa. U zbirnom modelu trideset minuta više dnevne uporabe povezano je s 0,25 boda višim povjerenjem, uz 95 % interval od 0,09 do 0,40. Uz linearnu prilagodbu za dob razlika iznosi -0,01 boda, uz interval od -0,19 do 0,17.
Istu linearnu procjenu drugdje prikazujemo na tri decimale, -0,008. Prikazi −0,01 i −0,008 potječu iz istog računa, uz različit broj decimala pri zaokruživanju.
Nesigurnost navodimo uz brojku. Prilagođeni interval isključuje razlike veličine zbirne procjene u oba smjera, ali dopušta male pozitivne i negativne vrijednosti. Uzorak od 300 osoba zato ne dokazuje potpunu odsutnost povezanosti.
Ograničenje treba napisati jasno. Umjesto niza riječi „možda” i „eventualno”, navodimo procjenu, interval i pretpostavku o kojoj zaključak ovisi.
Procjena blizu nule može biti koristan rezultat. Uzak interval može isključiti razlike veće od unaprijed opravdanoga sadržajnog praga, dok širok može pokazati da preciznost za tu odluku nije dovoljna. U ovome primjeru takav prag nismo zadali, pa blizinu nule ne proglašavamo sadržajnom nevažnošću. Ta dva ishoda razlikujemo prema veličinama koje interval dopušta.
U simulaciji znamo da generator nema izravnu vezu vremena i povjerenja. Obje mjere ovise o dobi. Prilagođeni interval uskladiv je s tim pravilom. Zbirni odnos postoji, ali njegovo tumačenje kao izravne veze zanemarilo bi dob.
Znanje o generatoru dobili smo izvan samog računa. Model je dao raspon uskladivih vrijednosti, bez dokaza da je koeficijent točno nula. U stvarnom radu zato uz rezultat trebamo nacrt, teoriju i prethodna mjerenja.
Izvještaj počinjemo pitanjem i njegovom vrstom. Opisujemo uzorak, prikupljanje i mjere, zatim podatke i analizu s procjenama i intervalima. Završavamo tumačenjem i granicama prijenosa. Tablice i grafovi trebaju jasne oznake, jedinice, izvore i broj opažanja na koji se odnose. Skraćenu os izričito označujemo.
Uz izvještaj predajemo dopuštene podatke, njihovo podrijetlo, ponovljiv postupak za tablice i grafove te zapis o asistentu. Reprodukciju provjeravamo u čistoj R sesiji ili novom projektu alata bez koda, po mogućnosti na drugom računalu.
Za petnaestominutno izlaganje izdvajamo pitanje, način prikupljanja, jedan važan graf, procjenu s intervalom i glavno ograničenje. Detaljne koeficijente i čišćenje ostavljamo u izvještaju. Cilj je da publika razumije rezultat i bez čitanja cijelog rada.
Na kraju zapisujemo što bismo promijenili u sljedećem istraživanju. Korisno je imenovati konkretnu odluku, primjerice prebrzo odabranu mjeru ili prekasno planiran uzorak, i objasniti kako bismo je drukčije riješili.
Provjera na stvarnim podacima
Simulacija nam je dopustila da zaključak usporedimo s poznatim pravilom nastanka podataka. Kako ćemo provjeriti vlastiti postupak kada to pravilo nemamo? Vraćamo se stvarnim rečenicama iz hrvatskog dijela skupa podataka ParlaSent 1.0, dostupnog u repozitoriju Instituta Jožef Stefan (Mochtak i sur. 2023., 2024.). Svaki redak predstavlja jednu parlamentarnu rečenicu s oznakom tona, pa trebamo drukčije pitanje od prethodnog odnosa vremena i povjerenja. Provjerit ćemo kako su rečenice odabrane i označene, opisati raspodjelu oznaka i odrediti što iz njih možemo zaključiti.
Mochtak, Michal, Peter Rupnik, Katja Meden, i Nikola Ljubešić. 2023. The Multilingual Sentiment Dataset of Parliamentary Debates ParlaSent 1.0. http://hdl.handle.net/11356/1868.
Mochtak, Michal, Peter Rupnik, i Nikola Ljubešić. 2024. „The ParlaSent Multilingual Training Dataset for Sentiment Identification in Parliamentary Proceedings“. Proceedings of the 2024 Joint International Conference on Computational Linguistics, Language Resources and Evaluation (LREC-COLING 2024) (Torino, Italia), svibanj, 16024–36. https://aclanthology.org/2024.lrec-main.1393/.
| Polje putovnice | Opis podataka |
|---|---|
| izvor i verzija | ParlaSent 1.0, hrvatski izvadak pripremljen 18. kolovoza 2026. |
| prava | CC BY-SA 4.0. Atribucija, oznaka promjena i obveza dijeljenja pod istim uvjetima putuju uz izvedenu datoteku |
| jedinica | jedna odabrana i označena parlamentarna rečenica |
| obuhvat | 2 698 redaka iz 2 499 dokumenata. Nije uzorak svih parlamentarnih rečenica, govornika ni stavova |
| put oznake | 1 362 redaka ima dva koderska glasa i usklađenje, a 1 336 jedan uvježbani koderski zapis |
| razdvajanje | 1 090 redaka za učenje, 272 za provjeru i 1 336 za ispitivanje. Preklopljeni dokumenti uklonjeni su s ulaznih podataka prije razdvajanja |
| nedostajanje | nedostupni drugi koder, usklađenje i izvorna podjela u ispitnim redcima nose izričit marker, a ne prazninu ili nulu |
| provjerljivi put |
data/parlament_oznake.csv, data/parlament_tekst/PUTOVNICA.md i data/parlament-oznake.LICENCA.md vode do izvora. Ista CSV datoteka služi radu u R-u i bez koda te pripremi tiskanog izdanja |
Dnevnik bilježi izbor redaka HR, uklanjanje 25 redaka iz 20 dokumenata koji se pojavljuju i u ispitnom dijelu te ponovljivu podjelu preostalih dokumenata. Zadržano je svih 1.336 izvornih ispitnih redaka. Paket ne spaja podatke o govornicima, strankama, mandatima ili datumima. Sadrži rečenice, izvorne ključeve, oznake i njihov nastanak, pa zaključke ograničavamo na te podatke.
Za ovaj opis ponovno koristimo svih 2.698 pripremljenih rečenica, a ne samo 272 iz usporedbe pragova u prethodnom poglavlju o algoritmima. Svaka oznaka Negative povećava brojač negativnih za jedan, neovisno o podjeli za učenje ili provjeru. Podjela prema putu oznake poslije razdvaja ta ista brojanja prema tome je li oznaku dao jedan koder ili dva kodera uz usklađenje.
Brojimo 1 212 negativnih, 979 neutralnih i 507 pozitivnih oznaka. Nazivnik je svih 2 698 redaka paketa. Ti brojevi opisuju oznake odabranih rečenica. Za zaključak o raspoloženju parlamenta trebali bismo opravdati drukčiji cilj mjerenja i odgovarajući odabir građe.
Kao provjeru osjetljivosti razdvajamo načine označavanja. U dijelu s dva kodera i usklađenjem negativno je 652 od 1 362 redaka, odnosno 47,9 % redaka. U dijelu s jednim uvježbanim koderom negativno je 560 od 1 336 redaka, odnosno 41,9 %. Zbirni udio tako objedinjuje dva mjerna postupka. Njihova usporedba istodobno uključuje razlike u broju kodera, dokumentima i odabiru, pa doprinos samog broja kodera ostaje nerazdvojen.
Ovo je opis konačnog odabranog paketa. Nismo zadali model slučajnog odabira neovisnih rečenica, pa uz te postotke ne prikazujemo binomne intervale niti procijenjenu uzoračku nesigurnost za širu populaciju.
Možemo provjeriti podrijetlo, nastanak oznaka i prelazak dokumenata među skupovima. Ne možemo ocijeniti pogreške klasifikatora, njegove podskupine, promjene izvedbe ni posljedice praga jer nemamo takav model, predviđanja i odluke iz primjene. Za budući red ljudskog pregleda trebali bismo unaprijed odrediti prag, posljedice pogreške, nadzor novih i izostavljenih rečenica te prigovor i ispravak. Asistent može provjeriti brojnosti i dosljednost, ali ne određuje opravdani cilj ili prihvatljive posljedice.
Zaključak se ograničava na oznake, njihove nazivnike i dva načina nastanka unutar odabranog paketa. Ne prenosi se na sav parlamentarni govor i ne provjerava novi klasifikator, uzrok tona ni institucionalnu odluku. Uz putovnicu, dnevnik, alternativnu analizu i zapis o asistentu druga osoba može pregledati dokaze i ponoviti račun u R-u ili alatu bez koda.
U ovom empirijskom primjeru asistentu su dane samo javne zbirne brojnosti i polja putovnice. Pojedinačne rečenice nisu poslane. Zapis uporabe prilažemo putovnici i dnevniku. Podatkovnom trakom označujemo koje okruženje smije primiti podatke s obzirom na njihovu osjetljivost. Prvo procjenjujemo podatke, a zatim biramo alat koji ih smije primiti.
| Polje objave | Zapis za primjer s ParlaSentom |
|---|---|
| sustav, inačica i datum | Codex, GPT-5, 19. kolovoza 2026. |
| delegirani zadatak | provjera zbrojeva po oznaci i putu označivanja te nacrt granice tvrdnje |
| podatkovna traka | javni alat. Samo objavljeni agregati iz paketa s provjerenim pravima uporabe |
| zadržani rezultat | aritmetička provjera zbrojeva. Granicu tvrdnje odgovorna je osoba ponovno napisala |
| neovisna provjera | lokalni račun iz data/parlament_oznake.csv, usporedba s putovnicom i otvaranje obaju citiranih izvora |
| što je ostalo neprovjereno | valjanost oznake, uzvodna selekcija rečenica i prijenos izvan pripremljenoga paketa |
| odgovorna osoba i mjesto objave | autor koji potpisuje paket. Zapis uz putovnicu, dnevnik i izvještaj |
U oba primjera završni izvještaj treba jasno pokazati što je procijenjeno i pod kojim uvjetima.
Izvještaj s procjenom u prvom planu. Na kraju našega nastavnog istraživanja trebamo napisati sažetak koji čitatelj može razumjeti bez otvaranja računalnog ispisa. Mogli bismo ga svesti na rečenicu da je zbirna veza bila značajna, a nakon prilagodbe za dob više nije. Time bismo izostavili ono što smo istraživanjem doznali o veličini razlike i usporedbi koju pojedini model provodi.
Pristup poznat kao nova statistika stavlja procjenu učinka, njezin interval i povezivanje dokaza u središte izvještavanja (Cumming 2014.). Primijenimo taj prijedlog na naš simulirani skup, bez tvrdnje da smo otkrili ponašanje stvarnih korisnika. Za dodatnih pola sata dnevnog korištenja mreža zbirni model procjenjuje razliku od 0,25 boda povjerenja. Nakon prilagodbe za dob procjena je -0,008 boda, uz 95 % interval od -0,186 do 0,170 boda.
Drugi račun uspoređuje osobe jednake dobi pod pretpostavkama modela. Njegov interval obuhvaća nulu, ali je dovoljno uzak da isključi razlike veličine zbirne procjene u oba smjera. Zaključak zato temeljimo na veličinama koje interval dopušta. Male razlike u oba smjera ostaju spojive s podacima i modelom.
To mijenja i odgovor koji bismo dali zamišljenom naručitelju zainteresiranom za povjerenje. Iz ove analize ne slijedi da bi skraćivanje vremena na mrežama promijenilo povjerenje. Za takvu odluku nedostaje uzročno opravdanje, a naš skup povrh toga služi nastavi. Usmjerenost na procjenu pomaže prikazati ono što smo procijenili. Interval ne može nadoknaditi ograničenje podataka i nacrta.
Završni izvještaj zato povezuje veličinu u razumljivim jedinicama, nesigurnost, usporedbu i granicu primjene. Čitatelj može vidjeti zašto smo promijenili početno tumačenje, a sljedeći istraživač što bi još trebalo provjeriti. To je više informacija od završne oznake značajnosti, čak i kada konačna odluka ostaje otvorena.
Rad s asistentom
Račun i neke provjere možemo delegirati, ali za predani rad odgovara autor. Koristimo sljedećih šest koraka, povezanih s pravilima u Dodatku F.
- Specificiramo pitanje, vrstu tvrdnje, jedinicu, granicu podataka, dopušten zaključak i provjerljivi izlaz.
- Delegiramo samo omeđeni račun, nacrt koda ili kritiku za koju su ulaz i očekivani oblik izlaza poznati.
- Reproduciramo svaki račun u čistoj lokalnoj sesiji ili novom projektu alata bez koda, od učitavanja dopuštenih podataka do posljednje tablice.
- Osporavamo rezultat jednom obranjivom alternativom i uspoređujemo procjenu, interval, sadržajni zaključak i dosegnutu populaciju.
- Dokumentiramo što je asistent vratio, što je provjereno, kako je provjereno i što je ostalo neprovjereno.
- Objavljujemo sustav, inačicu, datum, zadatak, podatkovnu traku, zadržani rezultat i odgovornu osobu, sve prema pravilima kolegija ili časopisa.
Zapis uporabe treba pokazati što je alat napravio i kako smo to provjerili. Potvrda u nastavku čitljiva je i bez koda, neovisno o korištenom alatu.
| Polje potvrde | Zapis za ovaj projekt |
|---|---|
| što je zatraženo | prijedlog analize i nacrt izvještaja za presječnu povezanost vremena i povjerenja |
| što je vraćeno | kod za dva modela i nacrt zaključka |
| što je provjereno | broj redaka, procjene, intervali, podrijetlo podataka i granica tvrdnje |
| kako je provjereno | čista lokalna sesija, usporedba s tablicom i otvaranje svakoga navedenog izvora |
| uloga asistenta | pomaže u računu i nacrtu uz ljudsku provjeru. Predmet je istraživanja samo kada proučavamo sam sustav |
| što je ostalo neprovjereno | valjanost mjere izvan generatora i prijenos na ljude izvan simuliranoga skupa |
| odgovorna osoba | osoba koja potpisuje pitanje, provjeru i objavljenu tvrdnju |
Dodajemo ime sustava, dostupnu inačicu ili napomenu da nije poznata, datum, podatkovnu traku i dio rezultata koji smo zadržali.
Alat biramo prema osjetljivosti podataka i dopuštenim uvjetima uporabe. Kao primjer služi politika kolegija uz ovaj udžbenik, inačica 1.0 od 4. kolovoza 2026. Puni uvjeti nalaze se u Dodatku F.
Prije slanja podataka asistentu zastanemo i provjerimo što smijemo podijeliti. U ovom primjeru javnom alatu možemo poslati dopuštene javne, simulirane ili zbirne podatke. Ako radimo s dopuštenim podacima u kojima su imena zamijenjena šiframa, trebamo alat s ugovorenom zaštitom podataka. Ograničeni podaci ostaju u lokalnom okruženju koje je odobrila ustanova. Odabir zato vežemo uz podatke koje imamo i pravila svojega zadatka i ustanove.
Ta datirana politika nije propis Hrvatskoga katoličkog sveučilišta ni pravno tumačenje. Uklanjanje imena samo po sebi ne potvrđuje da osobu nije moguće prepoznati.
Prije predaje provjerimo kako asistent povezuje rezultate s pitanjem istraživanja. Završni odlomak treba ostati provjerljiv prema istom paketu podataka, odluka i izračuna.
Prije predaje završnog izvještaja usporedite asistentov sažetak s rezultatima dvaju modela na istih 300 simuliranih osoba. Oba procjenjuju razliku u povjerenju povezanu s trideset minuta više dnevnog vremena na društvenim mrežama. Prilagodba za dob bila je unaprijed određena kao primarna analiza.
| Analiza | Procjena u bodovima | 95 % interval |
|---|---|---|
| Bez dobi | 0,25 | od 0,09 do 0,40 |
| Uz linearnu prilagodbu za dob | −0,01 | od −0,19 do 0,17 |
Asistent je vratio sljedeći sažetak.
U simuliranom uzorku, nakon linearne prilagodbe za dob, trideset minuta više dnevnog vremena povezano je s procijenjenom razlikom od -0,01 boda u povjerenju. Zaključak ovisi o linearnoj, aditivnoj prilagodbi za dob. Drukčiji oblik dobnoga odnosa mogao bi promijeniti procjenu. 95 % interval od -0,19 do 0,17 obuhvaća nulu, pa u ovom skupu nema povezanosti vremena i povjerenja.
Pripremite konačan odlomak koji možete potpisati. Zadržite točne brojke i ograničenje oblika modela, objasnite što usporedba dviju analiza pokazuje i zamijenite nepoduprtu tvrdnju. Dodajte jednu provjeru koju biste proveli prije predaje, uz objašnjenje zašto je tražite.
Završna revizija paketa dokaza
U završnoj provjeri razlikujemo svih šest vrsta tvrdnji. Za svaku navodimo postoji li opravdanje ili ostaje izvan dosega projekta.
| Dimenzija | Što završni paket podupire ili omeđuje |
|---|---|
| opis | opisuje 300 simuliranih osoba te brojnosti i put oznake 2.698 odabranih rečenica |
| povezanost | procjenjuje prilagođenu povezanost vremena i povjerenja. Razliku udjela po putu oznake ne tumači kao njegov učinak |
| generalizacija | ne prelazi sa simuliranoga skupa na stvarne korisnike ni s odabranoga korpusa na sav parlamentarni govor |
| predviđanje | nema zaključanoga prediktivnog pravila ni rezultata na doista novim opažanjima |
| uzročnost | presječna anketa i odabrani korpus ne podupiru intervencijsku tvrdnju |
| odluka | ne opravdava postavljeni sustav. Buduća bi odluka morala imenovati prag, teret pogrešaka, nadzor i put prigovora |
Zatim odgovaramo na šest revizijskih pitanja.
| Revizijsko pitanje | Gdje je odgovor |
|---|---|
| Koja je jedinica? | osoba u glavnoj studiji. Odabrana rečenica u ParlaSentu |
| Tko ili što nedostaje? | stvarni ljudi i simulirane jedinice izvan zadanoga skupa te rečenice izvan odabira i bez hrvatske oznake |
| Koji je cilj tvrdnje? | dobno prilagođena razlika u povjerenju povezana s 30 minuta više dnevnog vremena. Opis oznaka i puta mjerenja unutar paketa |
| Gdje je neizvjesnost? | interval kvantificira uzoračku varijaciju pod pretpostavljenim linearnim modelom. Oblik modela, mjerenje, selekcija, kodiranje i odluka ostaju zasebni |
| Koje drugo objašnjenje ostaje? | izostavljanje dobi. Odvojeno čitanje dvaju putova nastanka oznake |
| Tko snosi posljedice? | na ljude o kojima bi se neopravdano generaliziralo te na autore rečenica koje bi se slale u ljudski pregled |
U putovnici i analitičkoj tablici navodimo jedinicu, način odabira i izostavljene podatke. Uz udjele navodimo nazivnike, a uz procjene nesigurnost i njezina ograničenja. Posljedice pogreške povezujemo s odlukom i prigovorom, podrijetlo s izvorom i dnevnikom, a tumačenje s izvještajem i provjerom asistentova nacrta.
Dokumentacija omogućuje drugoj osobi da prati istraživanje od početnog pitanja i pripreme podataka do analize i izvještaja. Naša studija ne uključuje sustav koji donosi odluke u praksi. Kada bismo uveli sustav za odabir rečenica za pregled, trebali bismo unaprijed odrediti kako ćemo pratiti nove tekstove, pogreške i prigovore.
Sljedeća tablica razlikuje četiri aktivnosti i pitanja na koja odgovaraju.
| Aktivnost | Pitanje koje postavlja ovaj paket |
|---|---|
| statistika | što dizajn, procjena i interval opravdavaju vjerovati? |
| znanost o podacima | može li se od izvora i verzije ponoviti svaka transformacija i tablica? |
| strojno učenje | postoji li zaključan obrazac provjeren na doista novim opažanjima? Ovdje ne postoji |
| sustav umjetne inteligencije | kako bismo pratili odluke, pogreške i posljedice nakon primjene? Ovdje takav sustav još ne postoji |
U završnom projektu koristimo četiri vještine razvijene kroz knjigu. Provjeravamo tuđu tvrdnju, opisujemo i prikazujemo vlastite podatke, tumačimo i reproduciramo procjene te surađujemo s asistentom uz provjeru. Ne trebamo poznavati svaki statistički postupak. Trebamo znati što rezultat znači, koje su mu granice i kako ga druga osoba može provjeriti.
Prije dijeljenja paketa s parlamentarnim rečenicama primjenjujemo pravila zaštite osoba iz poglavlja o mjerenju i dizajnu. Javna dostupnost zapisa ne uklanja mogućnost identifikacije ni štetu od povezivanja s drugim podacima. Provjeravamo svrhu dijeljenja, nužnost pojedinih obilježja i prikladnost alata za osjetljivost podataka. Pravila kolegija dodatni su uvjet u nastavi. Odgovornost prema osobama o kojima podaci govore ostaje na nama.
Sažetak
Prvo istraživanje završavamo izvještajem i dokumentima koji drugoj osobi omogućuju da od našeg pitanja ponovno dođe do rezultata. Pitanje i nacrt određuju doseg zaključka, pa prije modela provjeravamo jesmo li analitičku tablicu, opis i grafove oblikovali tako da možemo odgovoriti na postavljeno pitanje. Primarnu analizu zatim uspoređujemo s opravdanom alternativom po procjeni, intervalu i značenju, kao što smo učinili pri uključivanju i izostavljanju dobi. Simulacija nam je omogućila provjeru poznatog pravila, a stvarni podaci pokazali su kako izbor rečenica i nastanak oznaka ograničavaju njihovo tumačenje. Asistent može ubrzati dio posla, dok provjera, objava uporabe i odgovornost ostaju na autoru. Uz svaku tvrdnju zato ostavljamo podrijetlo, nesigurnost i granicu dokaza kako bi čitatelj mogao prosuditi i rezultat i put kojim smo do njega došli.
Pojmovi
- paket dokaza
- evidence package
- putovnica skupa podataka
- dataset passport
- dnevnik transformacija
- transformation log
- trag odluka
- decision trail
- potvrđujuća analiza
- confirmatory analysis
- istraživačka analiza
- exploratory analysis
- provjera osjetljivosti
- sensitivity analysis
- granica tvrdnje
- claim boundary
- reproducibilan tijek rada
- reproducible workflow
- pošten izvještaj
- honest report
- minimizacija podataka
- data minimization
- objava uporabe asistenta
- AI-use disclosure
Zadaci
Konceptualni
Vratite se temama zavaravajućih brojki, uzorkovanja, krize i obnove te statistike u doba algoritama. Za primjer s hrvatskim rečenicama iz ParlaSenta odgovorite na šest revizijskih pitanja. U odgovorima upotrijebite barem po jedan dokaz o zavaravajućem nazivniku, selekciji, analitičkoj fleksibilnosti i teretu odluke. Pokažite kako nazivnik, izbor rečenica, analitičke odluke i posljedice pogreške ograničavaju zaključak. Zatim napišite jednu tvrdnju koju paket podupire i jednu koju ne podupire. Sam regresijski model iz ovoga poglavlja nije dovoljan za te odgovore.
Računski
Iz tablice opisa po dobnim skupinama izračunajte razliku u prosječnom dnevnom vremenu i razliku u prosječnom povjerenju između najmlađe i najstarije skupine. Zatim iz neprilagođenoga nagiba u provjeri osjetljivosti od 0,0082 boda po minuti izračunajte koliko bi razlike u povjerenju taj model pripisao dobivenoj razlici u vremenu. Usporedite taj broj s opaženom razlikom u povjerenju među skupinama i predajte oba rezultata s jednom rečenicom o tome zašto račun ne zamjenjuje primarnu analizu uz dob.
Kritički
Pronađite studentski ili novinski izvještaj o anketi koji navodi postotke bez broja ispitanika ili bez opisa načina prikupljanja. Prosudite ga prema redoslijedu izvještavanja koji procjenu i njezin raspon stavlja u prvi plan (Cumming 2014.). Predajte popis podataka koji nedostaju i jednu rečenicu o tome koji je zaključak zbog toga neprovjerljiv.
Cumming, Geoff. 2014. „The New Statistics: Why and How“. Psychological Science 25 (1): 7–29. https://doi.org/10.1177/0956797613504966.
Revizija modela
Ocijenite asistentov kratki sažetak iz okvira o pogrešci prema standardu poštene rečenice. Prepišite točne brojke, imenujte jedini pogrešan prijelaz, napišite ispravljeni zaključak te ispunite sedam polja potvrde provjere. Na kraju navedite što biste delegirali u sljedećem krugu, a koju odluku ne biste.