| Dob | Portal | Mreže | TV | Radio | Tisak | Ukupno |
|---|---|---|---|---|---|---|
| 18 do 29 | 66 | 83 | 24 | 11 | 13 | 197 |
| 30 do 44 | 91 | 88 | 56 | 39 | 22 | 296 |
| 45 do 59 | 53 | 23 | 44 | 32 | 20 | 172 |
| 60 i više | 23 | 3 | 61 | 18 | 30 | 135 |
| Ukupno | 233 | 197 | 185 | 100 | 85 | 800 |
Kategorički podaci
Od frekvencija u ćelijama do obrazaca povezanosti
Sumnja u pravednost Berkeleyjskih upisa tražila je usporedbu prijava i ishoda za muškarce i žene (Bickel i sur. 1975.). Zbirne i odjelne stope otvorile su različita pitanja, iako su nastale iz istih zapisa. Izbor usporedbe određivao je što se iz tablice moglo zaključiti.
Kad jednom odaberemo usporedbu, preostaje procijeniti koliko se opaženi raspored razlikuje od onoga koji bismo očekivali bez povezanosti. Bi li sam nalaz povezanosti bio dovoljan za zaključak o pravednosti upisa?
Isti zapisi prijava i odluka o prijmu na Sveučilište Berkeley, prema spolu i odjelu, pokazali su koliko tumačenje postotka ovisi o nazivniku i okolnostima nastanka podataka (Bickel i sur. 1975.). Za analizu kategorija trebamo povezati taj uvid s opisom raspodjele i povezanosti, procjenom nesigurnosti te razlikom između statističke značajnosti i veličine učinka.
Takve podatke često susrećemo u društvenim znanostima. Zanima nas koji izvor vijesti osoba bira, kojoj obrazovnoj skupini pripada ili podržava li neki prijedlog. Brojanjem dobivamo polazište za usporedbe koje odgovaraju na istraživačko pitanje. Ako mlađi i stariji biraju različite izvore vijesti, kako ćemo opisati tu razliku i procijeniti što nam uzorak govori o populaciji?
Logika zaključivanja koju smo dosad usvojili ostaje ista. Najprije postavljamo nulti model u kojem dvije varijable nisu povezane. Zatim uspoređujemo opažene podatke s onime što bismo pod tim modelom očekivali. Ovdje ćemo tu usporedbu provesti na frekvencijama u kontingencijskoj tablici. Uz rezultat testa i dalje trebamo pokazati veličinu razlike, njezinu nesigurnost i nazivnike na kojima se temelje prikazani udjeli.
Usporedbom tiska i portala procjenjivali smo razliku u povjerenju i njezinu nesigurnost. Sada nas zanima kako se sam izbor izvora vijesti razlikuje s dobi.
Za tu usporedbu zasebno izvlačimo uzorak od 800 osoba iz poznate nastavne populacije populacija_medija. Svaki zapis pripada zamišljenoj osobi s dobnom skupinom i glavnim izvorom vijesti. Nalaz ostaje opis računalno stvorene populacije, bez zaključka o stvarnim stanovnicima.
Najprije ćemo prebrojiti odgovore i usporediti postotke unutar skupina. Potom ćemo izračunati očekivane frekvencije pod pretpostavkom nezavisnosti i hi-kvadrat testom procijeniti ukupno odstupanje od toga modela. Reziduali će nam pomoći pronaći ćelije s izraženim odstupanjima, a Cramérovo V opisati jačinu povezanosti. Razmotrit ćemo i kako se analiza mijenja kada raspodjelu uspoređujemo s unaprijed zadanim udjelima ili kada su očekivani brojevi u ćelijama mali.
Izbor kategorija i usporedbe oblikuje zaključak. Pri opisu povezanosti dobi i izvora vijesti zato ćemo navesti i što nam još treba za njezino objašnjenje.
Brojanje prije testiranja
Kategoričke varijable razvrstavaju jedinice u skupine. Dobna skupina, izvor vijesti, obrazovanje i regija primjeri su takvih varijabli. Analiza počinje brojanjem jedinica u svakoj kategoriji, pa prvo trebamo provjeriti što smo i koga prebrojili.
Frekvencija je broj jedinica u kategoriji. Za udio trebamo i uvjetni nazivnik, skupinu unutar koje računamo postotak. Tvrdnja da četrdeset posto ispitanika bira društvene mreže može se odnositi na cijeli uzorak, samo najmlađu dobnu skupinu ili samo osobe koje su odgovorile. Jasno naveden nazivnik omogućuje čitatelju da provjeri na koju se skupinu postotak odnosi.
Prije brojanja određujemo kategorije. Dob možemo podijeliti na različite skupine, a portal i društvene mreže promatrati zajedno ili odvojeno. To je dio operacionalizacije. Test zatim uspoređuje raspored unutar tih kategorija. Njihovu sadržajnu prikladnost obrazlažemo prema pojavi koju istražujemo.
Definicija 1 Kontingencijska tablica je tablica frekvencija u kojoj svaka ćelija sadrži broj jedinica koje istovremeno pripadaju jednoj kategoriji retka i jednoj kategoriji stupca.
U našoj će tablici retci predstavljati dobne skupine, a stupci izvore vijesti. Ćelija na sjecištu najmlađe skupine i televizije pokazat će koliko najmlađih bira televiziju. Zbroj cijelog retka obuhvatit će sve osobe te dobi, neovisno o njihovu izvoru, a zbroj stupca sve korisnike televizije, neovisno o dobi. Takvi rubni zbrojevi daju raspodjelu svake varijable zasebno, dok unutarnje ćelije čuvaju njihove kombinacije.
Prijelaz od zapisa do tablice možemo provjeriti na najmlađoj skupini. Svaka od njezinih 197 osoba ulazi u točno jednu ćeliju. Među njima 83 bira društvene mreže, pa njihov udio računamo kao 83 podijeljeno s 197. Ostale retke gradimo istim prebrojavanjem.
Postoci po retku pokazuju kako su izvori vijesti raspoređeni unutar dobne skupine. Postoci po stupcu pokazuju dobni sastav korisnika pojedinog izvora. Ovdje koristimo postotke po retku jer želimo usporediti izbor izvora među dobnim skupinama različitih veličina. Kad bi nas umjesto toga zanimalo koji dio televizijske publike čine najstariji, koji bismo nazivnik trebali odabrati? Sada bismo broj najstarijih korisnika televizije dijelili brojem svih korisnika televizije. Promijenilo se pitanje, pa isti zapisi traže postotak po stupcu. Duljine stupaca na sljedećoj slici ipak prikazuju prvo pitanje, udjele izvora unutar svake dobne skupine.
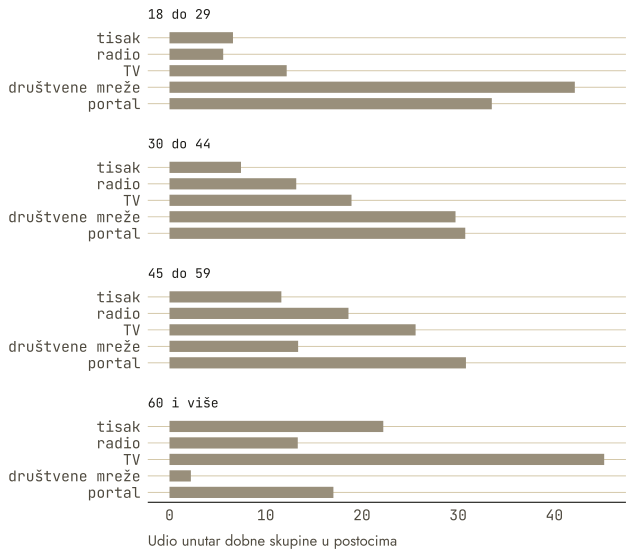
Društvene mreže bira 42,1 % osoba od 18 do 29 godina, a 2,2 % osoba od 60 i više godina. Televiziju bira 12,2 % najmlađih i 45,2 % najstarijih. Obrazac je jasan u uzorku. Sada trebamo provjeriti koliko bi takav raspored bio neobičan kada u populaciji ne bi bilo veze.
Očekivano pod nezavisnošću
Opažene razlike među dobnim skupinama sada trebamo usporediti s rasporedom u kojem dobi i izvoru vijesti ne bismo pripisali povezanost. Pritom zadržavamo broj osoba u svakoj dobnoj skupini i ukupan broj korisnika svakog izvora. Iz tih rubnih zbrojeva možemo izračunati očekivane frekvencije pod pretpostavkom nezavisnosti.
Ako televiziju bira petina cijelog uzorka, pod nezavisnošću bismo očekivali isti udio u svakoj dobnoj skupini. Očekivani broj u ćeliji dobivamo primjenom udjela stupca na broj osoba u retku.
Definicija 2 Očekivana frekvencija ćelije je umnožak zbroja njezina retka i zbroja njezina stupca podijeljen ukupnim brojem jedinica, dakle broj koji bi se u toj ćeliji nalazio kad bi dvije varijable bile nezavisne uz nepromijenjene rubne zbrojeve.
Oznaka \(E_{ij}\) predstavlja očekivanu frekvenciju u i-tom retku i j-tom stupcu. Oznaka \(n_{i\cdot}\) predstavlja zbroj i-tog retka, \(n_{\cdot j}\) zbroj j-tog stupca, a \(n\) ukupan broj jedinica.
\[E_{ij} = \frac{n_{i\cdot} \times n_{\cdot j}}{n}\]
U istoj tablici televiziju bira ukupno 185 od 800 osoba. Za najmlađe zato očekujemo \(197 \times 185 / 800 = 45,56\) korisnika televizije, a opažamo ih 24. Očekivani broj smije imati decimale jer nastaje iz modela kao referenca za usporedbu s opaženim brojem osoba.
Prije nastavka možemo dopuniti isti račun za najstariju skupinu. U njoj je 135 osoba, a zajednički udio korisnika televizije i dalje iznosi 185 podijeljeno s 800. Koji broj dobivamo kada taj udio primijenimo na veličinu najstarije skupine i zašto u nazivnik ne stavljamo samo broj najstarijih? Vrijedi zapisati račun prije čitanja objašnjenja u sljedećem odlomku.
Dobivamo 31,22 očekivanih korisnika televizije. Udio iz cijelog uzorka određuje referencu pod nezavisnošću, a broj najstarijih određuje na koliko osoba primjenjujemo tu referencu. Kad bismo umjesto toga uzeli opaženi udio televizije među najstarijima, samo bismo rekonstruirali opaženi broj i izgubili usporedbu s nultim modelom.
Nezavisnost znači da se raspodjela izvora vijesti ne mijenja s dobnom skupinom. To privremeno pretpostavljamo kako bismo izračunali očekivanja i usporedili ih s podacima.
Najmanja očekivana frekvencija iznosi 14,3. U našoj tablici nema vrlo rijetkih očekivanih ćelija. Očekivana frekvencija manja od pet uobičajen je znak za dodatnu provjeru hi-kvadrat aproksimacije (Cochran 1954.). Taj prag služi kao upozorenje, a ne kao jamstvo valjanosti ili najava smjera pogreške. Poslije ćemo provjeriti kako se postupak ponaša uz rijetke ćelije.
Cochran, William G. 1954. „Some Methods for Strengthening the Common \(\chi^2\) Tests“. Biometrics 10 (4): 417–51. https://doi.org/10.2307/3001616.
Za sljedeći prikaz trebamo dvije sažete mjere. Hi-kvadrat statistika zbraja doprinose \((O-E)^2/E\) svih ćelija, pa veći broj označuje veće odstupanje od nezavisnosti uz zadane rubove. Cramérovo V dijeli tu statistiku veličinom uzorka i dimenzijom tablice prije vađenja korijena. Za tablicu dva puta dva vrijedi \(V=\sqrt{\chi^2/n}\). Tako razdvajamo količinu dokaza od veličine povezanosti. Nakon prikaza razvijamo opće formule i njihove pretpostavke.
Interakcija — Očekivano i opaženo
Za ovaj prikaz konstruiramo novu tablicu dviju skupina A i B s odgovorima „da” i „ne”. Ona ne nastaje izvlačenjem osoba iz prethodnog uzorka. Svaka skupina ima zadani broj osoba, a ukupno je jednako odgovora „da” i „ne”. Ako svaka skupina ima 20 osoba, nezavisnost daje po 10 u svakoj ćeliji. Pomak od 20 % dodaje dva odgovora ćelijama A–da i B–ne, a oduzima dva preostalima. Dobivamo retke 12 i 8 te 8 i 12, uz nepromijenjene rubne zbrojeve. Njihov doprinos računamo kao \((12-10)^2/10=0,4\) za prvu ćeliju, a isto pravilo vrijedi za ostale tri. Zbroj je \(4\times0,4=1,6\), uz \(n=40\), pa je \(V=\sqrt{1,6/40}=0,20\). Ako sve frekvencije pomnožimo s četiri, doprinos svake ćelije i hi-kvadrat postaju četiri puta veći, dok V ostaje 0,20. Prikaz uspoređuje unaprijed zadane tablice i ne procjenjuje stopu pogreške kroz slučajne uzorke. Kontrole digitalnog izdanja mijenjaju zadani raspored.
Najprije u svakom retku uspoređujemo opaženu i očekivanu frekvenciju. Puni krug označuje opaženu vrijednost. Prazni romb označuje očekivanu, a broj uz oznake doprinos ćelije.
Što isprobati.
- Postavite opažene frekvencije jednake očekivanima i pogledajte doprinose.
- Pomaknite opažanja u oba smjera i provjerite ostaju li rubni zbrojevi jednaki.
- Povećajte pomak i pratite koliko brže raste ukupno odstupanje od pomaka.
- Zadržite pomak u postocima i usporedite mali s velikim rubnim zbrojem.
Prije usporedbe rezultata možemo predvidjeti što bi se dogodilo kada bismo učetverostručili sve četiri frekvencije, a zadržali iste postotke. Bi li hi-kvadrat ostao isti i bi li se jednako ponašalo Cramérovo V? Ovdje mijenjamo brojnosti zamišljene tablice radi usporedbe. Kopiranje zapisa stvarnog istraživanja ne bi stvorilo dodatna neovisna opažanja.
Isti relativni pomak daje veće ukupno odstupanje kada imamo više opažanja. Pri pomaku od 20 % i povećanju rubnog zbroja svake skupine s 20 na 80 hi-kvadrat raste s 1,6 na 6,4, a Cramérovo V ostaje 0,20. Relativna jačina veze nije se promijenila. Promijenila se količina podataka s kojom uspoređujemo opaženi obrazac i model nezavisnosti. Pri učetverostručenju frekvencija i očekivanja svaka razlika postaje četiri puta veća. Njezin kvadrat postaje šesnaest puta veći, a očekivanje u nazivniku četiri puta veće, pa se svaki doprinos i njihov zbroj učetverostručuju. U računu za V hi-kvadrat i broj osoba rastu zajedno, zato V ostaje isti.
Hi-kvadrat i njegova referentna raspodjela
Doprinose ćelija računamo tako da oduzmemo očekivanu frekvenciju od opažene, razliku kvadriramo i podijelimo očekivanom frekvencijom. Kvadriranjem sprječavamo poništavanje pozitivnih i negativnih odstupanja. Zbroj doprinosa sažima odstupanje cijele tablice.
Definicija 3 Hi-kvadrat statistika je zbroj kvadriranih odstupanja opaženih od očekivanih frekvencija, pri čemu je svako odstupanje podijeljeno očekivanom frekvencijom svoje ćelije.
Zbroj označujemo s \(\chi^2\). Oznaka \(O_{ij}\) predstavlja opaženu, a \(E_{ij}\) očekivanu frekvenciju u i-tom retku i j-tom stupcu.
\[\chi^2 = \sum_{i,j} \frac{(O_{ij} - E_{ij})^2}{E_{ij}}\]
Za našu tablicu statistika iznosi 149,8, uz 12 stupnjeva slobode. Približna p-vrijednost iz hi-kvadrat referentne raspodjele iznosi <0,001. Stupnjeve slobode računamo množenjem broja redaka umanjenog za jedan i broja stupaca umanjenog za jedan.
Stupnjevi slobode proizlaze iz ograničenja rubnih zbrojeva. U tablici dva puta dva, uz zadane rubove, odabir jedne ćelije određuje preostale tri. U našoj tablici s četiri retka i pet stupaca možemo slobodno zadati 12 ćelija. Ostalih osam određuju rubovi. Broj stupnjeva slobode zato utječe na referentnu raspodjelu odstupanja.
U poglavlju o testiranju opaženu smo statistiku uspoređivali s vrijednostima koje nastaju ponavljanjem pod nultim modelom. Ovdje istu ulogu ima teorijska hi-kvadrat raspodjela odgovarajućih stupnjeva slobode, kada je to približenje primjereno. Usporedbom naše statistike s tom raspodjelom dobivamo p-vrijednost. Za jedan stupanj slobode granica na razini 0,05 iznosi 3,84. S više stupnjeva slobode granica je viša.
Hi-kvadrat sažima odstupanje cijele tablice. Da bismo vidjeli gdje se ono pojavljuje, vraćamo se konkretnim dobnim skupinama i izvorima te računamo rezidual svake ćelije. Budući da rubne udjele procjenjujemo iz iste tablice, oni ograničavaju promjenjivost ćelija. Pri standardiziranju odstupanja zato uz očekivanu frekvenciju uzimamo u obzir i udjele retka i stupca. Ako u tablici 2 × 2 uz zadane rubove povećamo jednu ćeliju, preostale tri moraju se odgovarajuće promijeniti. Odstupanja su stoga međusobno vezana zadanim rubnim zbrojevima.
Definicija 4 Prilagođeni standardizirani rezidual ćelije je razlika opažene i očekivane frekvencije podijeljena procijenjenom standardnom devijacijom te razlike, koja uzima u obzir rubne udjele retka i stupca.
Oznaka \(e\) označuje ostatak, \(p_{i\cdot}\) rubni udio retka, a \(p_{\cdot j}\) rubni udio stupca. Slovo \(r\) u knjizi zadržavamo za korelaciju.
\[e_{ij} = \frac{O_{ij} - E_{ij}} {\sqrt{E_{ij}(1-p_{i\cdot})(1-p_{\cdot j})}}\]
Pozitivan rezidual pokazuje više opažanja nego što model očekuje, a negativan manje. Kada je aproksimacija primjerena, apsolutna vrijednost oko dva može upozoriti na neuobičajeno odstupanje. To je orijentir za čitanje. Pregled mnogo reziduala nakon ukupnog testa zahtijeva oprez zbog višestrukih usporedbi.
Najveći pozitivan rezidual pripada televiziji među osobama od 60 i više godina i iznosi 6,67. Najveći negativan pripada društvenim mrežama u istoj skupini i iznosi -6,63. Među najmlađima predznaci su obrnuti, s 6,57 za mreže i -4,20 za televiziju. Tako ukupno odstupanje možemo povezati s konkretnim skupinama i izvorima.
Značajno nije isto što i snažno
Hi-kvadrat raste s veličinom uzorka. Uz iste postotke tablica na osam tisuća osoba daje deset puta veću statistiku nego tablica na osamsto. Zato p-vrijednost ne može mjeriti jačinu veze. Mijenja se i kada relativni obrazac ostane isti.
Cramérovo V prilagođava hi-kvadrat veličini uzorka i dimenzijama tablice. Kreće se između nule i jedinice. Nula označuje nezavisnost u tablici, a jedinica najjaču povezanost koju ta mjera može prikazati.
Definicija 5 Cramérovo V je korijen hi-kvadrat statistike podijeljene umnoškom veličine uzorka i manje dimenzije tablice umanjene za jedan.
Oznakom \(V\) označujemo tu mjeru. U formuli je \(n\) ukupan broj jedinica, a \(k\) manji od broja redaka i broja stupaca.
\[V = \sqrt{\frac{\chi^2}{n\,(k-1)}}\]
U našoj tablici V iznosi 0,25. Jednaka vrijednost V-a ne nosi univerzalnu oznaku male ili velike veze za tablice različitih dimenzija. Važnost veze trebamo procijeniti prema pitanju i ranijim nalazima iz istog područja.
Za odluku su često jasniji postoci. Televiziju bira 12,2 % najmlađih i 45,2 % najstarijih ispitanika. Uredništvo može tu razliku povezati s raspodjelom resursa. Uz V kao sažetak jačine veze čitamo pojedine udjele kako bismo razumjeli obrazac.
Referentna raspodjela je istraživačka odluka
Dosad smo uspoređivali dob i izvor vijesti. Na istom uzorku od 800 osoba možemo postaviti drukčije pitanje, odgovara li sastav uzorka prema obrazovanju poznatom sastavu naše simulirane populacije. Zadržavamo osobe, ali sada brojimo samo razine obrazovanja. Za svaku razinu očekivani broj dobivamo množenjem 800 s njezinim udjelom u populaciji. U tablici je uz taj broj i druga moguća referenca, 200 osoba po razini, koja bi slijedila iz pretpostavke o četiri jednako zastupljene kategorije.
| Obrazovanje | Opaženo | Prema populaciji | Jednaki udjeli |
|---|---|---|---|
| osnovna | 157 | 142,9 | 200 |
| srednja | 366 | 377,5 | 200 |
| viša | 188 | 189,4 | 200 |
| diplomska | 89 | 90,2 | 200 |
Prvi redak sada možemo usporediti s dvama različitim očekivanjima, a zatim isti račun ponoviti za preostale razine. Taj postupak zovemo testom prilagodbe. Zbrajanje kvadriranih odstupanja podijeljenih očekivanim brojevima ostaje isto kao prije. Uz četiri izvana zadane kategorijske vjerojatnosti raspodjela ima tri stupnja slobode, jedan manje od broja kategorija. Očekivanja ovdje zadajemo izvana, umjesto da ih računamo iz rubnih zbrojeva tablice dviju varijabli.
Ako pretpostavimo jednaku zastupljenost četiriju razina obrazovanja, statistika iznosi 209,3, uz p-vrijednost manju od 0,001. To pokazuje velik nesklad. Ako koristimo poznate udjele simulirane populacije, statistika iznosi 1,77, uz p-vrijednost 0,62. Drugi test ne pokazuje jasan nesklad, ali ne dokazuje jednakost. Najveća opažena razlika jednog udjela prema populacijskom iznosi 1,8 postotnih bodova.
Oba računa mogu biti točna jer ispituju različite tvrdnje. Jednaki udjeli ovdje nemaju sadržajno opravdanje, dok poznata populacijska raspodjela ima. U stvarnom istraživanju referenca obično nije tako sigurno poznata. Trebamo je odabrati i obrazložiti prije testa.
Ista pitanja o kategorijama i nazivnicima pojavljuju se kada brojimo kodirane tekstove. Jedinica tada može biti dokument, objava ili govor. Prije tablice navodimo tko je odredio kodnu knjigu i pravila razvrstavanja, a nazivnik usklađujemo s jedinicama koje zadovoljavaju uvjete za kodiranje. Posebno prikazujemo nekodirane jedinice i one kojima je dodijeljeno više oznaka.
Ako retci predstavljaju izvor teksta, a stupci kodiranu kategoriju, nalaz ovisi i o tekstovima i o pravilima kodiranja. U poglavlju o algoritmima istu ćemo logiku primijeniti na tablicu zabune. I ondje moramo znati kako su kategorije nastale i koji je nazivnik svakog udjela.
Kad je aproksimacija tanka
U uzorku od 800 osoba najmanja očekivana frekvencija iznosi 14,3 pa nijedna ćelija nije osobito rijetka. Da bismo vidjeli što se događa kada očekivani brojevi postanu mali, privremeno napuštamo taj uzorak i pojednostavljujemo pitanje. U zasebnom nastavnom pokusu imamo dvije hipotetske dobne skupine i samo odgovor koristi li osoba određenu društvenu mrežu. To nisu novi podaci o Hrvatskoj niti podskup prethodnih 800 zapisa.
Najprije nas zanima koliko često test prijavljuje vezu koje u modelu nema. Svakoj zamišljenoj osobi neovisno dodjeljujemo odgovor „da” s unaprijed zadanom vjerojatnošću, a inače odgovor „ne”. Jednake vjerojatnosti u objema skupinama stvaraju nulti model. U većem uzorku generiramo po 200 osoba, a u manjem po 20. Donja dva retka tablice mijenjaju pitanje i poslužit će poslije za procjenu snage, kada je veza ugrađena u model.
| Svrha i uzorak | Osoba po skupini | „Da” među mlađima | „Da” među starijima |
|---|---|---|---|
| Nula, veći | 200 | 50 % | 50 % |
| Nula, manji | 20 | 10 % | 10 % |
| Snaga, veći | 200 | 60 % | 40 % |
| Snaga, manji | 20 | 16 % | 4 % |
Prema prvom nultom modelu u svakoj skupini očekujemo \(200 \times 0,50 = 100\) odgovora „da” i 100 odgovora „ne”. U manjem modelu očekujemo \(20 \times 0,10 = 2\) odgovora „da” i 18 odgovora „ne”. To su očekivanja iz pravila generatora. U pojedinoj izvučenoj tablici ukupan broj korisnika mreže varira, pa test očekivane frekvencije ponovno računa iz njezinih ostvarenih rubnih zbrojeva.
Jedno ponavljanje manjega pokusa znači generirati svih 40 odgovora, prebrojiti ih u tablici i izračunati jednu Pearsonovu statistiku i njezinu p-vrijednost. Sljedeću smo moguću tablicu namjerno odabrali radi preglednog računa. Ona nije nasumično izdvojeno ponavljanje iz simulacije.
| Dobna skupina | Koristi mrežu | Ne koristi mrežu | Ukupno |
|---|---|---|---|
| Mlađi | 4 | 16 | 20 |
| Stariji | 0 | 20 | 20 |
| Ukupno | 4 | 36 | 40 |
Mrežu koristi 4 od 20 mlađih, odnosno 20 %, i 0 od 20 starijih. Pod nezavisnošću primjenjujemo zajednički udio \(4/40\) na svaku skupinu od 20 osoba. Očekivani brojevi zato su 2 i 18 u oba retka. Ovdje se slučajno podudaraju s očekivanjima generatora. Da smo dobili ukupno šest korisnika, test bi očekivao po tri u svakoj skupini. Za prikazanu tablicu četiri doprinosa Pearsonovoj statistici iznose \(4/2\), \(4/18\), \(4/2\) i \(4/18\), jer je svako opažanje od svoga očekivanja udaljeno za dva. Njihov je zbroj 4,44.
Učestalost pogrešaka procjenjujemo ponavljanjem cijelog postupka, pa svaki scenarij ponavljamo 4 000 puta. Veličine skupina i vjerojatnosti ostaju zadane, a svaki put generiramo nove neovisne odgovore. Brojimo koliko puta Pearsonov test, odnosno test sa zbrojem (opaženo − očekivano)²/očekivano, bez korekcije kontinuiteta daje p-vrijednost manju od 0,05. Broj odbacivanja dijelimo s 4 000, uključujući ponavljanja bez ijednog korisnika mreže ili bez ijednog nekorisnika. U njima test nije definiran i ovdje ih računamo kao neodbacivanja. Tablica ih pokazuje zasebno kako bi nazivnik ostao vidljiv.
| Scenarij | Odbacivanja | Postotak | Neprimjenjiva |
|---|---|---|---|
| Nula, veći uzorak | 218 | 5,4 % | 0 |
| Nula, manji uzorak | 162 | 4,0 % | 66 |
| Veza, veći uzorak | 3928 | 98,2 % | 0 |
| Veza, manji uzorak | 819 | 20,5 % | 64 |
Prva dva retka procjenjuju lažna odbacivanja jer u njihovim modelima nema veze. Dobivenih 5,4 % i 4,0 % treba čitati uz slučajnu promjenjivost simulacije. Oko stope od 5 % standardna pogreška na 4 000 ponavljanja iznosi oko 0,34 postotna boda. Male razlike u postocima zato nisu same po sebi dokaz razlike u ponašanju postupaka. Rezultat manjega scenarija odnosi se i na naše pravilo o neprimjenjivim tablicama. U ovom scenariju s malim očekivanim frekvencijama stopa je ispod 5 %, pa je postupak konzervativan. Ovaj pokus zato ne pokazuje povećanu pogrešku prve vrste. Male očekivane frekvencije upozoravaju na nepouzdanu aproksimaciju, ali ne određuju unaprijed smjer odstupanja.
Vratimo se tablici s četiri korisnika među mlađima i nijednim među starijima. Želimo provjeriti koliko je taj raspored neobičan bez oslanjanja na glatku hi-kvadrat krivulju. Zadržimo po 20 osoba u skupinama i ukupno četiri korisnika mreže. Tada su mogući samo sljedeći rasporedi korisnika, dok brojeve nekorisnika dobivamo oduzimanjem od 20.
| Među mlađima | Među starijima | Uvjetna vjerojatnost |
|---|---|---|
| 0 | 4 | 5,30 % |
| 1 | 3 | 24,95 % |
| 2 | 2 | 39,50 % |
| 3 | 1 | 24,95 % |
| 4 | 0 | 5,30 % |
Tablice nisu jednako vjerojatne. Dva korisnika u svakoj skupini mogu nastati na više načina nego sva četiri u jednoj, kada svaki izbor četiriju osoba među njih 40 ima jednaku vjerojatnost. Primjerice, vjerojatnost posljednjeg retka dobivamo dijeljenjem broja izbora četiriju među 20 mlađih brojem izbora četiriju među svih 40 osoba. Za srednji redak biramo dvije među 20 mlađih i dvije među 20 starijih. Tako nastaju uvjetne vjerojatnosti u tablici.
Na tom računu počiva Fisherov egzaktni test. Za dvostranu p-vrijednost ovdje zbrajamo vjerojatnosti svih tablica čija je uvjetna vjerojatnost manja ili jednaka vjerojatnosti opažene tablice. Posljednjem retku zato pridružujemo prvi i dobivamo približno 0,106. Pearsonov račun bez korekcije za istu tablicu daje približno 0,035. Razlika pokazuje da način računanja referentne vjerojatnosti može promijeniti odluku pri pragu 0,05. Ne pokazuje da je Fisherova p-vrijednost uvijek veća, niti jedna odabrana tablica utvrđuje opće ponašanje tih testova. Egzaktnost se odnosi na račun uz zadane rubove, a ne uklanja nesigurnost malog uzorka, pogreške mjerenja ili ograničenja nacrta.
Preostaje drugo pitanje, koliko često otkrivamo vezu koja postoji u modelu. Za snagu zato trebamo promijeniti pravila generiranja. Donja dva retka nacrta daju mlađima i starijima različite vjerojatnosti odgovora „da”. Uz jednako velike skupine obje razlike odgovaraju populacijskom Cramérovu V od 0,20. U većem scenariju razlika udjela iznosi 0,20 uz zajednički udio 0,50, a u manjem 0,12 uz zajednički udio 0,10. Standardiziranje tih razlika daje istu vrijednost V, iako su apsolutne razlike različite. Za dvije jednako velike skupine vrijedi \(V=|p_1-p_2|/[2\sqrt{\bar p(1-\bar p)}]\). Zato su računi \(0,20/[2\sqrt{0,50\cdot0,50}]=0,20\) i \(0,12/[2\sqrt{0,10\cdot0,90}]=0,20\).
Sada svaki odbačeni nulti model znači otkrivenu ugrađenu vezu. Od po 4 000 ponavljanja odbacujemo u 98,2 % većih i 20,5 % manjih uzoraka. Između scenarija mijenjaju se i broj osoba i učestalost korištenja mreže, pa cijelu razliku u snazi ne možemo pripisati samo veličini uzorka. Ta dva retka ne procjenjuju pogrešku prve vrste niti pouzdanost pojedine odluke.
U početnoj analizi dobi i izvora vijesti ove provjere usmjeravaju čitanje tablice. Najprije provjeravamo brojanja i očekivane frekvencije, zatim primjerenost referentnog računa, a uz test i dalje navodimo udjele, njihovu razliku i nesigurnost. Uz pouzdaniji račun p-vrijednosti i dalje trebamo obrazložiti značenje kategorija i doseg uzorka.
Odluka o spajanju kategorija traži i sadržajno opravdanje. Sljedeći primjer pokazuje što se pritom može izgubiti iz istraživačkog pitanja.
Tri odgovora u jednoj kategoriji. Pew Research Center u izvještaju o odraslim stanovnicima SAD-a bez religijske pripadnosti zajedno prikazuje ateiste, agnostike i osobe koje na pitanje o svojoj religiji biraju odgovor „ništa posebno” (Pew Research Center 2024.). Zajednička kategorija omogućuje usporedbu s osobama koje navode neku religiju. Izvorni odgovori pokazuju i razlike unutar nje. Prema procjeni s težinama iz ankete provedene 2023., u Boga ili neku višu silu vjeruje 67 % agnostika, uz objavljenu 95-postotnu marginu uzoračke pogreške za tu skupinu od ±6,0 postotnih bodova (Pew Research Center 2024.). Za osobe s odgovorom „ništa posebno” procjena iznosi 83 %, a odgovarajuća margina za tu skupinu ±3,5 postotnih bodova (Pew Research Center 2024.). Svaki se postotak odnosi na vlastitu skupinu. Jedan zajednički udio prikrio bi tu razliku.
Pew Research Center. 2024. Religious ’Nones’ in America: Who They Are and What They Believe. Pew Research Center. https://www.pewresearch.org/religion/wp-content/uploads/sites/7/2024/01/PR_2024.01.24_religious-nones_REPORT.pdf.
Ako nas zanimaju uvjerenja agnostika i osoba koje su odabrale odgovor „ništa posebno”, trebamo sačuvati zasebne kategorije i podatak o vjerovanju. Izbor podjele određuje koje ćemo razlike moći opisati. O tome vodimo računa i kada u hi-kvadrat analizi razmatramo spajanje rijetkih kategorija. Veći očekivani brojevi mogu poboljšati hi-kvadrat aproksimaciju, ali ne vraćaju razlike koje smo spajanjem uklonili. Zato uz provjeru prikladnosti postupka čuvamo izvorne frekvencije i udjele te objašnjavamo na koje pitanje odgovara spojena tablica.
Može li ovaj zaključak u izvještaj?
Upravo smo vidjeli da pri tumačenju testa trebamo provjeriti očekivane frekvencije i razlikovati statističku značajnost od jačine povezanosti. Vratimo se sada uzorku od 800 zamišljenih osoba i pogledajmo kako se te provjere koriste pri pisanju izvještaja.
Kolegica je analizirala povezanost dobne skupine i glavnog izvora vijesti. Prije predaje rada zamolila vas je da pregledate njezin zaključak. Poslala vam je sažetak rezultata.
| Što je provjereno ili izračunano | Rezultat |
|---|---|
| Broj osoba u simuliranom uzorku | 800 |
| Broj dobnih skupina i izvora vijesti | 4 skupine i 5 izvora |
| Najmanja očekivana frekvencija | 14,3 |
| Hi-kvadrat statistika | 149,8 |
| Stupnjevi slobode | 12 |
| p-vrijednost | < 0,001 |
| Cramérovo V | 0,25 |
U izvještaju je zadržala i dio opisa koji čitatelju pokazuje kako se skupine razlikuju.
| Dobna skupina | Televizija kao glavni izvor | Društvene mreže kao glavni izvor |
|---|---|---|
| Od 18 do 29 godina | 12,2 % | 42,1 % |
| 60 i više godina | 45,2 % | 2,2 % |
Postoci su izračunani unutar svake dobne skupine. Prikazana su dva od pet izvora, pa se postoci u retku ne zbrajaju do sto.
Ispod tablica napisala je sljedeće.
Sve očekivane frekvencije veće su od pet. Hi-kvadrat test daje p-vrijednost manju od 0,001, pa podaci snažno odstupaju od modela nezavisnosti. Budući da je p-vrijednost tako mala, povezanost dobi i izvora vijesti vrlo je snažna.
Prije nego što joj odgovorite, povežite svaku rečenicu s rezultatom na koji se oslanja.
- Koja rečenica izvodi zaključak koji navedeni pokazatelj ne opravdava?
- Koji rezultat trebate koristiti za opis jačine povezanosti, a koji dio prikaza pomaže objasniti njezino praktično značenje?
- Prepravite završnu rečenicu. Zadržite ono što rezultati pokazuju, ali nemojte veličinu povezanosti zaključivati iz p-vrijednosti.
Razrađeni primjer
Spajanje kategorija možemo razmotriti na pitanju koje smo sadržajno odredili prije računa. Umjesto razlika među svih pet izvora sada nas zanima razlikuje li se izbor digitalnih i tradicionalnih izvora među dobnim skupinama. Portal i društvene mreže svrstavamo u digitalne, a televiziju, tisak i radio u tradicionalne izvore. Ta podjela odgovara novom pitanju i stvara novu varijablu. Najprije ćemo pročitati njezine udjele, a zatim ukupno odstupanje od nezavisnosti.
Vraćamo se istom uzorku od 800 osoba, a zasebni pokus s dvjema skupinama ovdje završava. Sve osobe ostaju uključene. Primjerice, u najmlađem retku zbrajamo 66 korisnika portala i 83 korisnika mreža, što daje 149 digitalnih korisnika. Preostali izvori daju 48 tradicionalnih korisnika. Nazivnik retka ostaje 197.
| Dob | Digitalni | Tradicionalni | Ukupno |
|---|---|---|---|
| 18 do 29 | 149 | 48 | 197 |
| 30 do 44 | 179 | 117 | 296 |
| 45 do 59 | 76 | 96 | 172 |
| 60 i više | 26 | 109 | 135 |
Za konkretnu usporedbu najmlađih i najstarijih čitamo udjele digitalnih izvora. Bira ih 75,6 % najmlađih i 19,3 % najstarijih. Razlika iznosi 56,4 postotnih bodova, uz 95-postotni interval od 47,4 do 65,3. Ukupni test, koji obuhvaća sve dobne skupine, odgovara na šire pitanje o povezanosti u cijeloj tablici. Hi-kvadrat iznosi 114,3, uz 3 stupnja slobode, a V iznosi 0,38. Za pet kategorija V je bio 0,25. Prikladnost podjele prosuđujemo prema pitanju na koje želimo odgovoriti. Prva čuva razlike među pojedinačnim izvorima, a druga opisuje digitalno-tradicionalnu podjelu. Usporedba pokazuje koliko zaključak ovisi o operacionalizaciji. Interval razlike udjela računan je normalnom aproksimacijom s odvojenim procjenama varijance dvaju udjela, bez korekcije kontinuiteta. Pretpostavlja neovisne osobe i skupine te dovoljno velike brojnosti u svakoj od četiriju ćelija.
Tablica opisuje povezanost dobi i izbora izvora. Među mogućim objašnjenjima jesu ranije stečene navike, dostupnost uređaja i životno razdoblje. Za njihovo razdvajanje trebali bismo dodatne varijable i prikladan nacrt. U poglavlju o regresiji naučit ćemo zajedno razmatrati više varijabli.
Iz dobivenih rezultata sada možemo sastaviti kratak izvještaj.
U slučajnom uzorku od 800 osoba iz nastavne simulacije usporedili smo izbor digitalnih i tradicionalnih izvora među dobnim skupinama. Digitalne izvore bira 75,6 % osoba od 18 do 29 godina i 19,3 % osoba od 60 i više godina. Razlika iznosi 56,4 postotnih bodova uz 95-postotni interval od 47,4 do 65,3. Za cijelu tablicu hi-kvadrat iznosi 114,3, uz 3 stupnja slobode i p-vrijednost manju od 0,001, a Cramérovo V 0,38. Rezultat opisuje zamišljene osobe i ne daje procjenu medijskih navika stanovnika Hrvatske niti dokaz da dob uzrokuje izbor izvora.
Prva rečenica određuje pitanje i podatke. Sljedeće daju opaženi obrazac i preciznost usporedbe najmlađih s najstarijima. Ukupni test i V odnose se na sve četiri dobne skupine, pa ne zamjenjuju taj konkretni kontrast. Završna rečenica određuje doseg nalaza. Za uredničku publiku mogli bismo u prvi plan staviti razliku u postotnim bodovima, a tehničke pokazatelje ostaviti u pratećoj tablici. Oznaka simulacije, nazivnici i granice zaključka moraju ostati i u kraćoj verziji.
Za dodatnu provjeru slijedi programski račun prethodne analize.
Prikaži kod
uzorak <- s13_uzorak |>
  mutate(skupina_medija = if_else(
    izvor_vijesti %in% c("portal", "društvene mreže"),
    "digitalni",
    "tradicionalni"
  ))

tablica <- table(uzorak$dobna_skupina, uzorak$skupina_medija)

round(prop.table(tablica, 1) * 100, 1)
chisq.test(tablica)
Kod preuzima uzorak i učitane pakete iz već pripremljene analize poglavlja. U računu pratimo isti put kojim smo čitali prethodnu tablicu. Poziv table prebroji kombinacije dobne skupine i nove podjele izvora, a prop.table pretvori frekvencije u udjele prema zadanom smjeru. Tek potom chisq.test sažima odstupanje od nezavisnosti u hi-kvadrat, određuje stupnjeve slobode i računa p-vrijednost prema referentnoj raspodjeli. Za tablicu 2 × 2 R zadano primjenjuje korekciju kontinuiteta, koja ublažava prijelaz s diskretnih brojanja na kontinuiranu krivulju. Za ovdje opisani nekorigirani račun treba navesti correct = FALSE.
Vratimo se istim berkeleyjskim prijavama. Zbirna tablica pokazivala je povezanost spola i ishoda prijave (Bickel i sur. 1975.). Hi-kvadrat, V i reziduali mogli bi opisati taj obrazac, ali ne i objasniti ga. Nedostajao je odjel prijave. Muškarci i žene nisu se jednako raspoređivali po odjelima, a odjeli su imali različite stope prijma. U poglavlju Zašto statistika vidjeli smo Berkeleyjev primjer, a u poglavlju o povezanosti pokazali smo kako dodavanje takva sloja može promijeniti zbirni obrazac (Simpson 1951.). Statistički opis dviju varijabli zato treba razlikovati od objašnjenja mehanizma.
Simpson, E. H. 1951. „The Interpretation of Interaction in Contingency Tables“. Journal of the Royal Statistical Society, Series B 13 (2): 238–41. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x.
Sažetak
Od brojanja kategorija prelazimo na usporedbu tek kada odredimo nazivnik svakog udjela. Model nezavisnosti tada iz rubnih zbrojeva daje očekivane frekvencije s kojima uspoređujemo opaženu tablicu. Hi-kvadrat sažima ukupno odstupanje, reziduali ga vraćaju konkretnim ćelijama, a Cramérovo V pomaže odvojiti jačinu veze od količine podataka. Ako umjesto nezavisnosti provjeravamo podudaranje sa zadanom raspodjelom, trebamo obrazložiti tu referencu. Male očekivane frekvencije mogu oslabiti aproksimaciju, pa razmatramo Fisherov postupak ili sadržajno opravdanu novu podjelu kategorija, svjesni da potonjom mijenjamo pitanje. U sljedećem poglavlju zadržat ćemo usporedbu skupina, ali ćemo umjesto rasporeda kategorija promatrati brojčani ishod.
Nazivi neovisnost i nezavisnost u ovom probabilističkom značenju označavaju isti odnos. Neovisnost znači da zajedničku vjerojatnost možemo dobiti množenjem pojedinačnih vjerojatnosti. Zato očekivane frekvencije u tablici nastaju umnoškom rubnih udjela i ukupnog broja osoba.
Pojmovi
- stupnjevi slobode
- degrees of freedom
- doprinos ćelije
- cell contribution
- kontingencijska tablica
- contingency table
- uvjetni nazivnik
- conditional denominator
- očekivana frekvencija
- expected frequency
- hi-kvadrat statistika
- chi-squared statistic
- prilagođeni standardizirani rezidual
- adjusted standardized residual
- test prilagodbe
- goodness-of-fit test
- referentna raspodjela
- reference distribution
- Cramérovo V
- Cramér’s V
- Fisherov egzaktni test
- Fisher’s exact test
Zadaci
Nakon vlastitog pokušaja otvorite naznake i provjere rješenja.
Konceptualni
Objasnite razliku između testa nezavisnosti i mjere jačine veze tako da napišete dvije rečenice koje bi se mogle pojaviti u istom izvještaju, jednu o tome što test kaže i jednu o tome što V kaže.
Zatim izvještaj iz razrađenog primjera preoblikujte u tri rečenice za novinara. Zadržite oznaku simulacije, dobne skupine, nazivnike postotaka, razliku s intervalom i granicu zaključka. Obrazložite koji biste tehnički pokazatelj ostavili u pratećoj tablici i zašto njegovo izostavljanje iz glavnog teksta ne mijenja značenje nalaza.
Računski
Tablica ima dva retka s po sto ispitanika i dva stupca s rubnim zbrojevima stodvadeset i osamdeset. Izračunajte sve četiri očekivane frekvencije, a zatim za opaženu tablicu sa sedamdeset u prvoj ćeliji izračunajte doprinos svake ćelije i njihov zbroj. Usporedite ga s graničnom vrijednošću 3,84.
Kritički
Vratite se na Simpsonov paradoks iz poglavlja Zašto statistika i na Berkeleyjev slučaj (Bickel i sur. 1975.). Skicirajte zbirnu tablicu spola i ishoda prijave te skup odjelskih tablica koje vraćaju izostavljeni sloj. Objasnite zašto hi-kvadrat test prve tablice ne može razlikovati razliku u sastavu prijava od razlike u odlučivanju unutar odjela. Predajte obje sheme, jedan odlomak usporedbe i naziv varijable bez koje se ta dva objašnjenja ne mogu razdvojiti.
Bickel, P. J., E. A. Hammel, i J. W. O’Connell. 1975. „Sex Bias in Graduate Admissions: Data from Berkeley“. Science 187 (4175): 398–404. https://doi.org/10.1126/science.187.4175.398.
Revizija modela
Vratite se izvještaju iz okvira o pogrešci. Izdvojite dijagnostičke korake koji su provedeni ispravno i jedan pogrešan zaključak. Napišite zamjenski odlomak koji rabi već navedeno Cramérovo V i uspoređuje udjele unutar dobnih skupina. Objasnite što provjera očekivanih frekvencija potvrđuje, a koje pretpostavke njome još nisu provjerene. Ne dodjeljujte jačini univerzalnu oznaku bez sadržajnog obrazloženja.