| Redak | Povjerenje | Izvor |
|---|---|---|
| 1 | 6 | radio |
| 2 | 7 | TV |
| 3 | 6 | tisak |
| 4 | 3 | društvene mreže |
| 5 | 3 | portal |
Uzorkovanje
Jedan uzorak skriva raspodjelu mogućih rezultata
Kad uz internetsku anketu vidimo velik broj odgovora, lako joj pripišemo veću uvjerljivost. Zamislimo dvije prognoze istih izbora, jednu s nekoliko stotina sudionika i drugu s milijunima. Prije nego što pročitamo kako su prikupljene, koja nam ulijeva više povjerenja?
Časopis Literary Digest pred američke predsjedničke izbore 1936. poslao je milijune probnih listića i iz vraćenih odgovora predvidio pobjedu Alfa Landona. Pobijedio je Franklin Roosevelt (Squire 1988.). Pogrešna prognoza imala je iza sebe golemu količinu odgovora stvarnih ljudi.
Kako toliki broj odgovora može promašiti čak i pobjednika, a znatno manji uzorak ipak pružiti korisnu procjenu?
Da bismo razumjeli taj promašaj, trebamo odvojiti dvije stvari. Jedna je koliko bi se rezultat mijenjao pri ponavljanju odabira, a druga kamo nas sam postupak odabira sustavno usmjerava. Slučajnost iz prethodnog poglavlja sada ulazi u sam odabir ljudi koje promatramo. Ako iz iste populacije uzmemo drugi uzorak, promijenit će se sastav sudionika, a s njime i izračunati prosjek. Uz razlike među ljudima sada istražujemo koliko bi se mijenjao naš odgovor na istraživačko pitanje kada bismo odabir mogli ponavljati.
Za tu ćemo provjeru iskoristiti prednost nastavne simulacije. Skup populacija_medija sadrži 50.000 računalno stvorenih odraslih osoba i omogućuje nam da poznajemo cijelu populaciju. Jedan redak predstavlja jednu osobu, a pratit ćemo povjerenje u medije, dnevno praćenje medija, izvor vijesti i spremnost na plaćanje. To je ista zamišljena populacija kojom smo se već služili, odvojena od manje ankete anketa_mreze. Iz nje možemo izvlačiti uzorke i njihove rezultate uspoređivati s poznatom ciljnom vrijednošću. Ti zapisi ne opisuju stvarne stanovnike. U stvarnom istraživanju ciljnu vrijednost obično ne vidimo.
Ponavljanjem odabira dobit ćemo raspodjelu uzoračkih rezultata, čije ćemo središte i širinu opisati sredinom i standardnom devijacijom. Standardnu pogrešku procjene pritom ćemo razlikovati od raspršenosti pojedinačnih odgovora. Mijenjanjem veličine uzorka i oblika populacije ispitat ćemo kada raspodjela sredina postaje približno zvonasta i zašto se njezina širina smanjuje sporije nego što raste broj sudionika.
Ta promjenjivost samo je dio problema ankete. Vratit ćemo se okviru uzorkovanja, odazivu i istraživačkom nacrtu iz poglavlja o mjerenju te provjeriti što veći uzorak može popraviti, a što ostaje izvan računa. Ista pitanja postavit ćemo i izboru tekstova u korpus. Pri procjeni uvjerljivosti istraživanja moći ćemo razlikovati slučajnu nesigurnost od sustavnog izostavljanja jedinica. Za to najprije trebamo jasno odvojiti populaciju koju želimo opisati od uzorka koji nam je dostupan.
Populacija, uzorak i pogreška uzorkovanja
Populacija je skup jedinica o kojima želimo zaključivati, a uzorak dio koji smo promatrali. Postupak odabira povezuje ih tako što određuje koje populacijske jedinice mogu ući u uzorak i s kojim izgledima.
Parametar je vrijednost koja opisuje populaciju. Populacijsku sredinu označujemo s \(\mu\), a standardnu devijaciju s \(\sigma\). Statistika je vrijednost izračunata iz uzorka, primjerice sredina \(\bar{x}\) ili standardna devijacija \(s\). Veličine uzorka i populacije označujemo s \(n\) i \(N\). Statistiku koristimo za procjenu parametra, uz očekivanje da se mogu razlikovati.
Prije izvlačenja uzoraka izračunajmo parametre cijele populacija_medija. Te će nam vrijednosti služiti kao cilj s kojim uspoređujemo svaku uzoračku procjenu.
Prosječno povjerenje u medije je 4,88 na ljestvici od 1 do 10, uz standardnu devijaciju 1,98. Prosječno dnevno praćenje medija iznosi 174,5 minuta, a portal kao glavni izvor bira 30,2 % osoba. To su svojstva naše simulirane populacije, bez tvrdnje o stvarnom gradu.
Za jedan od tih računa nasumično odabiremo 100 različitih osoba bez vraćanja. Početak izvučenog uzorka prikazan je u tablici. Prvi odgovor povjerenja iznosi 6, ali se sredina računa iz svih 100 odgovora. Njihov zbroj 500 dijelimo sa 100. Za udio portala umjesto zbroja ocjena brojimo 32 osoba s tom oznakom izvora, uz isti nazivnik.
U jednom uzorku od stotinu osoba prosječno povjerenje iznosi 5,00, a udio korisnika portala 32,0 %. Vrijednosti su bliske populacijskima, ali nisu jednake.
Definicija 1 Pogreška uzorkovanja je razlika između vrijednosti izračunate na uzorku i vrijednosti koju ima cijela populacija, a nastaje zato što je izmjeren dio umjesto cjeline.
Pogreška ovdje označuje razliku koja nastaje zato što promatramo samo dio populacije. Moguća je i uz potpuno ispravan unos podataka i postavljanje pitanja. Tu slučajnu promjenjivost treba razlikovati od sustavnog odstupanja zbog pristranog odabira.
Pri novom odabiru ponovno je dostupna cijela populacija. Unutar jednog uzorka osoba ulazi najviše jednom, ali može ući u više različitih uzoraka. Svako novo izvlačenje ponovno kreće iz cijele populacije, a prethodnih 100 zapisa čini samo jedan od mogućih uzoraka. Populacija i pravilo odabira ostaju fiksni, mijenjaju se odabrane osobe. Tri neovisna uzorka od po stotinu osoba daju sredine 4,57, 4,47 i 4,84. Dobivene su iz iste populacije istim postupkom, uz raspon od 0,37 boda.
Nakon tri tisuće ponavljanja sredine možemo prikazati kao raspodjelu. Ona pokazuje gdje se procjene skupljaju i koliko se međusobno razlikuju. Njezine jedinice su procjene iz uzoraka.
Definicija 2 Distribucija uzorkovanja je raspodjela vrijednosti koje bi neka statistika poprimila kroz mnogo ponovljenih uzoraka iste veličine iz iste populacije.
Dvije raspodjele odgovaraju na različita pitanja. Raspodjela opažanja pokazuje koliko se ljudi razlikuju. Distribucija uzorkovanja pokazuje koliko se mijenja procjena kroz različite uzorke. Obje imaju sredinu i standardnu devijaciju, pa je važno svaki put navesti što raspodjela opisuje.
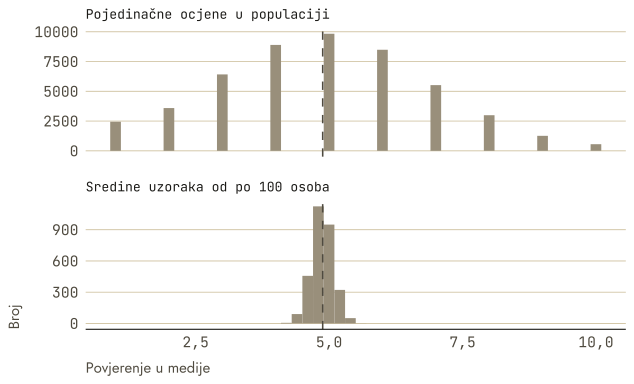
Uzoračke sredine ovdje su raspoređene oko populacijske sredine. Procjenitelj zato dugoročno ne promašuje sustavno naviše ili naniže i nazivamo ga nepristranim. Uži donji panel pokazuje manju promjenjivost sredina uzoraka. Pojedinačne ocjene ljudi ostaju jednako raspršene.
Standardna pogreška
Uži donji panel sada želimo opisati brojem. Raspršenost procjena također mjerimo standardnom devijacijom. Da bismo je razlikovali od raspršenosti pojedinačnih opažanja, nazivamo je standardnom pogreškom.
Definicija 3 Standardna pogreška je standardna devijacija distribucije uzorkovanja, pa opisuje koliko bi tipično varirala procjena kroz ponovljene uzorke.
Pojedinačne ocjene imaju standardnu devijaciju 1,98, dok standardna devijacija sredina iz tri tisuće uzoraka iznosi 0,198. Potonja je standardna pogreška, a prva je od nje 10,0 puta veća. Uzorci imaju po stotinu osoba, a korijen iz sto jest deset. U rezultatima se tako već nazire odnos koji će opisati formula.
U sredini malog uzorka svaka osoba ima veću težinu. Jedan odgovor u uzorku od deset ljudi čini desetinu računa, a u uzorku od tisuću ljudi tisućinu. U većem se uzorku neovisna pozitivna i negativna odstupanja više poništavaju. Zato sredina manje varira. Dobitak u preciznosti raste s korijenom broja opažanja.
Dosad koristimo jednostavni slučajni uzorak (simple random sample), u kojem svaki mogući skup od \(n\) jedinica ima jednaku vjerojatnost odabira. Jedinice iz konačne populacije biramo bez vraćanja. Sljedeća formula točna je za neovisne odabire s vraćanjem, a dobra je aproksimacija za odabir bez vraćanja ako je \(n\) malen prema \(N\). Za druge nacrte slučajnog uzorkovanja može trebati drukčiji račun.
\[ SE_{\bar{x}} = \frac{\sigma}{\sqrt{n}} \]
Oznaka \(SE_{\bar{x}}\) znači standardnu pogrešku sredine, \(\sigma\) populacijsku standardnu devijaciju, a \(n\) veličinu uzorka. Formula ovdje daje 0,1984, dok iz ponavljanja dobivamo 0,1981. Rezultati se slažu na tri decimale, iako su dobiveni različitim postupcima.
Odabir bez vraćanja dodatno smanjuje nesigurnost. Ako uključimo cijelu populaciju, pogreške uzorkovanja više nema. Korekcija za konačnu populaciju (finite-population correction) uzima u obzir taj dobitak množenjem početnog izraza korijenskim faktorom.
\[ SE_{\bar{x}} = \frac{\sigma}{\sqrt{n}} \sqrt{\frac{N-n}{N-1}} \]
Kada je uzorkovan malen dio populacije, drugi korijen blizu je jedan i malo mijenja rezultat. Kako se \(n\) približava \(N\), faktor se smanjuje do nule. Simulacija bez vraćanja već uključuje taj učinak. U sljedećoj tablici stupac s formulom koristi aproksimaciju za veliku populaciju, bez te korekcije.
Svaka simulacijska standardna pogreška u tablici ispod nastaje iz 1 500 uzoračkih sredina za navedeni broj osoba. Računamo standardnu devijaciju tih 1 500 brojeva, bez izostavljenih ponavljanja. To mjeri preciznost, dok udaljenost njihova prosjeka od poznate populacijske sredine služi provjeri pristranosti. Konačan broj ponavljanja donosi i malo simulacijsko kolebanje, pa sitne razlike prema formuli ne tumačimo kao dokaz sustavnoga odstupanja.
U praksi nepoznatu \(\sigma\) procjenjujemo uzoračkom standardnom devijacijom \(s\). Sada možemo provjeriti i raniji izbor djelitelja \(n-1\) za varijancu. U četiri tisuće uzoraka od po deset osoba dijeljenje kvadriranih odstupanja s deset daje prosječno 3,55, dok je populacijska varijanca 3,94. Dijeljenje s devet daje 3,94. Djelitelj \(n\) sustavno podcjenjuje varijancu jer odstupanja računamo od sredine istog uzorka, koja tim vrijednostima pristaje bliže od populacijske sredine.
Tablica pokazuje kako preciznost raste s veličinom uzorka. Za svako dodatno smanjenje standardne pogreške trebamo sve više opažanja.
| Veličina uzorka | Formula | Simulacija | Raspon ±1,96 SE |
|---|---|---|---|
| 10 | 0,627 | 0,617 | ±1,23 |
| 25 | 0,397 | 0,405 | ±0,78 |
| 50 | 0,281 | 0,282 | ±0,55 |
| 100 | 0,198 | 0,194 | ±0,39 |
| 200 | 0,140 | 0,141 | ±0,27 |
| 500 | 0,089 | 0,088 | ±0,17 |
| 1 000 | 0,063 | 0,065 | ±0,12 |
| 2 000 | 0,044 | 0,043 | ±0,09 |
Svako deseterostruko povećanje uzorka smanjuje standardnu pogrešku za faktor \(\sqrt{10}\), približno 3,16. Da bi se standardna pogreška prepolovila, uzorak se mora učetverostručiti. Za svako daljnje smanjenje slučajne raspršenosti zato treba prikupiti sve više opažanja.
Oblik koji se pojavljuje
Zadržavamo istu populaciju osoba, ali povjerenje zamjenjujemo iznosom spremnosti na plaćanje. Za svaku od veličina 5, 15, 30 i 100 izvučemo 4 000 novih uzoraka bez vraćanja i za svaki spremimo jednu sredinu. Nule su valjani odgovori i ostaju u svim računima. Tako promjena oblika koju ćemo gledati nastaje usrednjavanjem, bez uklanjanja neplatitelja.
Uz širinu treba pogledati i oblik distribucije uzorkovanja. Spremnost na plaćanje u populaciji ima 76,1 % nula i dug desni rep, uz asimetriju 3,2. Izvorne vrijednosti izrazito odstupaju od normalne raspodjele.
Za uzorke od pet osoba asimetrija raspodjele sredina je 1,47. Za petnaest pada na 0,76, za trideset na 0,52, a za sto na 0,32. Mijenja se raspodjela sredina, dok izvorna populacija ostaje ista.
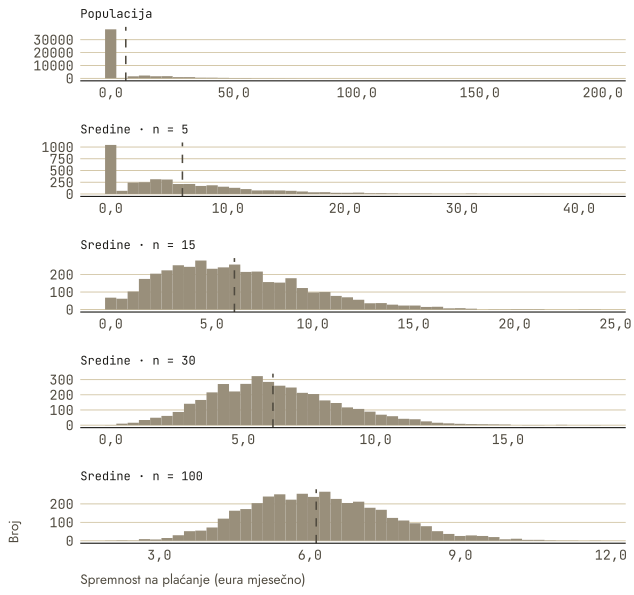
Središnji granični teorem (central limit theorem) u ovom modelu opisuje približavanje distribucije sredine normalnoj raspodjeli s rastom jednostavnog slučajnog uzorka. Potrebna je konačna varijanca i raspodjela u kojoj nekolicina jedinica ne nosi gotovo cijeli zbroj. Dovoljna veličina uzorka ovisi o obliku i repovima populacije. U našem je primjeru i pri trideset osoba ostalo dosta asimetrije, dok za gotovo simetričnu populaciju manji uzorak može biti dovoljan.
Mnogi se postupci zato oslanjaju na približnu normalnost raspodjele procjene, dok pojedinačna opažanja mogu imati drukčiji oblik. Primjena teorema i dalje zahtijeva odgovarajuće uvjete odabira i neovisnosti. Kod složenijeg uzorkovanja težine i zajednički odabir skupina mogu promijeniti i oblik i širinu raspodjele procjene. Račun mora pratiti taj nacrt.
Dva prikaza empirijske standardne pogreške potječu iz zasebnih simulacija. Raspodjela sredina pri stotinu osoba ima 3 000 ponavljanja, a usporedna tablica za svaku veličinu uzorka koristi 1 500 novih ponavljanja. Male razlike njihovih procjena SE-a zato odražavaju i konačan broj simulacija.
Interakcija — CLT stroj
Za interaktivni pokus napuštamo mjerne jedinice medijskih podataka i koristimo zasebne umjetne raspodjele. Tiskani prikaz polazi od 5 000 generiranih vrijednosti između nule i jedinice, s mnogo malih vrijednosti i sve manje velikih. Iz tog fiksnog skupa izvlačimo s vraćanjem, po 2 000 uzoraka veličine pet i četrdeset. Jedno izvlačenje daje jedan broj, a prosjek cijelog uzorka jednu vrijednost donjeg histograma. Ovdje je vraćanje dio zadanoga modela uzorkovanja iz poznate populacije.
Uz populacijsku raspodjelu prikazane su raspodjele uzoračkih sredina za dvije veličine uzorka. Populacija je u oba slučaja ista. Usporedba pokazuje kako veći uzorak mijenja oblik raspodjele sredina i smanjuje njezinu širinu. Pri fiksnoj populaciji standardna pogreška smanjuje se s korijenom veličine uzorka.
Što isprobati.
- Odaberite simetričnu populaciju i uzorak veličine dva pa usporedite širine dvaju histograma.
- Promijenite populaciju u desno asimetričnu bez povećanja uzorka.
- Povećajte uzorak na četrdeset i odvojeno opišite promjenu oblika i širine raspodjele sredina.
- Odaberite dvovršnu populaciju i pronađite veličinu uzorka pri kojoj se dvije populacijske skupine više ne vide u sredinama.
Preciznost ankete od osamsto ljudi
U anketi često želimo procijeniti udio, primjerice koliko ljudi bira portal, umjesto prosječne ocjene povjerenja. Za to možemo iskoristiti poznati račun. Izbor portala označimo jedinicom, a ostale izbore nulom, pa sredina tih vrijednosti daje uzorački udio, označen s \(\hat{p}\). Njime procjenjujemo populacijski udio, uz istu logiku uzorkovanja sredine koju smo upravo upoznali. Raspršenost binarne varijable određena je njezinim udjelom. Najveća je kada je populacija podijeljena napola, a manja blizu nule ili jedan.
Standardnu pogrešku ukupnog udjela u velikoj populaciji procjenjujemo sljedećim izrazom za jednostavni slučajni uzorak. Nepoznati populacijski udio zamjenjujemo procjenom \(\hat{p}\), pa je i standardna pogreška procijenjena.
\[ SE_{\hat{p}} = \sqrt{\frac{\hat{p}\,(1 - \hat{p})}{n}} \]
Kod jednostavnoga slučajnog uzorka bez vraćanja izraz se množi istom korekcijom za konačnu populaciju kao i standardna pogreška sredine. Kod nejednakih vjerojatnosti odabira ili grupnog uzorkovanja ne smije se prenijeti bez prilagodbe nacrtu.
Margina pogreške (margin of error) polovica je širine intervala oko procjene. U prikazanom računu najveća je za udio od 50 %, jer je tada raspršenost najveća. Za razinu od 95 % i veliku populaciju približno iznosi jedan podijeljen korijenom veličine uzorka.
U sljedećem računu marginu dobivamo množenjem procijenjene standardne pogreške s 1,96. Obrnutim računom određujemo potreban uzorak za željenu marginu. Vrijede pretpostavke jednostavnog slučajnog uzorka i velike populacije te razumna normalna aproksimacija. Ona može biti neprikladna ako je očekivan broj jedne kategorije malen.
| Veličina uzorka | Margina pogreške | Ciljana margina | Potreban uzorak |
|---|---|---|---|
| 400 | ±4,9 % | ±5 % | 385 |
| 800 | ±3,5 % | ±4 % | 601 |
| 1 000 | ±3,1 % | ±3 % | 1 068 |
| 2 000 | ±2,2 % | ±2 % | 2 401 |
Tablica se odnosi na jedan ukupni udio, jednostavni slučajni uzorak i razinu od 95 %, bez korekcije za konačnu populaciju. Za osamsto ljudi najveća margina je približno ±3,5 %. Takva procjena razlikuje veličine udaljene desetak postotnih bodova bolje nego one udaljene dva ili tri. Drugi cilj procjene, nacrt ili zahtjev za preciznošću traži novi račun.
Kada izvještaj navodi da prva opcija ima 32 %, a druga 29 %, same dvije procjene i njihove pojedinačne margine nisu dovoljne za tvrdnju da je prva opcija ispred druge. Razlika dvaju udjela ima vlastitu nesigurnost, koju treba izračunati iz zajedničkoga nacrta.
Veličina populacije izostaje iz jednostavne formule jer smo zanemarili korekciju za konačnu populaciju. To je opravdano kada uzimamo malen dio populacije. Manju populaciju čini slučajno izdvojenih 5000 vrijednosti povjerenja iz iste populacije populacija_medija. Iz tako određenih cjelina zasebno izvlačimo uzorke. U simulaciji uzorak od osamsto osoba iz cijele populacije daje standardnu pogrešku 0,0700, a iz deset puta manje populacije 0,0640. Uzorak u drugom slučaju obuhvaća veći dio cjeline, pa je precizniji. Populacijske devijacije iznose 1,984 i 1,967. Formula s korekcijom uzima u obzir i tu malu razliku te daje 0,0696 i 0,0637, blizu simuliranim rezultatima.
Dovoljnu veličinu uzorka određujemo prema pitanju koje istražujemo. Trebamo znati procjenjujemo li ukupni udio, sredinu, rijetku pojavu ili razliku skupina. Trebamo i nacrt, način odabira i odaziva te željenu preciznost. Preciznost za podskupinu ovisi o broju njezinih članova. Oko tisuću može biti korisna orijentacija za jedan ukupni udio u jednostavnom nacrtu. Za ostale ciljeve veličinu određujemo zasebno.
Margina pogreške opisuje promjenjivost zbog slučajnog odabira. Ne uključuje ljude izvan okvira, neodaziv ni učinak formulacije i redoslijeda pitanja. Oznaka ±3 % u tom kontekstu znači tri postotna boda margine za uzorkovnu promjenjivost. Tvrdnja da je razlika unutar margine zato ne potvrđuje kvalitetu svih ostalih dijelova istraživanja.
Nacrt uzorka i pristranost odabira
Dosadašnji račun polazio je od jednakih izgleda za odabir. U stvarnoj anketi neke osobe mogu imati veće izglede od drugih, pa njihov doprinos procjeni trebamo prilagoditi. U vjerojatnosnom uzorkovanju svaka jedinica ima poznatu pozitivnu vjerojatnost uključivanja, ali ona ne mora biti jednaka za sve. Jedinici s upola manjom vjerojatnošću dajemo približno dvostruk doprinos procjeni. Početna težina uzorkovanja računa se kao obrnuta vjerojatnost uključivanja. Bez težina bismo previše zastupali češće birane jedinice. Ni pravilne težine, međutim, ne vraćaju ljude koji su potpuno izostali iz okvira.
Učinak težina prikazat ćemo na šest odabranih jedinica iz zasebne sintetičke populacije od šesnaest osoba. U svakom od dvaju slojeva ima osam osoba. Jedinica označuje potporu zamišljenoj mjeri, a nula izostanak potpore. Vjerojatnosti uključivanja su 0,50 u prvom i 0,25 u drugom sloju, pa su težine dva i četiri.
| Jedinica | Sloj | Vjerojatnost uključivanja | Odgovor | Težina uzorkovanja |
|---|---|---|---|---|
| A1 | češće uključeni | 0,50 | 1 | 2 |
| A2 | češće uključeni | 0,50 | 1 | 2 |
| A3 | češće uključeni | 0,50 | 1 | 2 |
| A4 | češće uključeni | 0,50 | 0 | 2 |
| B1 | rjeđe uključeni | 0,25 | 0 | 4 |
| B2 | rjeđe uključeni | 0,25 | 0 | 4 |
Bez težina dijelimo brojnik 3 nazivnikom 6 i dobivamo 50,0 %. S težinama dobivamo brojnik 6, nazivnik 16 i udio 37,5 %. Procjena pada jer dvije nule iz rjeđe biranog sloja više pridonose nazivniku. Dobivenih 37,5 % i dalje je procjena, s mogućom pogreškom uzorkovanja. Primjer provjerava račun na vidljivoj sintetičkoj tablici, bez tvrdnje o stvarnim ljudima.
Složeni uzorci traže dodatne prilagodbe. Kalibracija težina usklađuje ponderirane zbrojeve s poznatim obilježjima populacije. Pri grupnom uzorkovanju biramo skupine, primjerice škole, pa osobe unutar njih. Sličnost tih osoba može smanjiti količinu neovisne informacije. Učinak nacrta uspoređuje varijancu procjene s onom jednostavnoga slučajnog uzorka, a efektivna veličina uzorka izražava istu preciznost brojem jedinica takva uzorka.
Pri čitanju izvještaja provjeravamo uključuje li račun nesigurnosti težine, skupine i slojeve. Neodaziv i potpunost okvira zahtijevaju zasebnu provjeru i obrazložene prilagodbe. Neobvezni odjeljak praktikuma podrobnije objašnjava te prilagodbe.
Pokrivenost, odabir i odaziv
Težinama smo uzeli u obzir različite izglede uključenih jedinica. One ipak ne rješavaju problem ljudi koji uopće nisu mogli biti odabrani. Pogreška pokrivenosti nastaje kada okvir iz kojega se bira ne dopušta svim jedinicama ciljne populacije da uopće uđu u uzorak. Povećanje broja odabranih jedinica unutar istoga okvira ne doseže one koji u njemu nedostaju.
U prigodnom uzorku biramo dostupne ljude, bez poznatih vjerojatnosti odabira. U našoj populaciji mlađih od dvadeset pet godina s višim obrazovanjem ima 1 915. Njihovo prosječno povjerenje iznosi 4,09, dok je populacijsko 4,88. Razlika nadmašuje cijelu marginu ankete s tisuću ljudi. Uključivanjem svih članova te uske skupine točno bismo opisali upravo nju, uz istu razliku prema cijeloj populaciji.
U sljedećem modelu samoodabira ponovno razmatramo svih 50 000 osoba. Osobi mlađoj od 30 koja bira mreže dajemo 15 % izgleda za uključivanje, a ostalima te dobi 8 %. U dobi od 30 do 49 godina izgledi su 6 % za portal ili mreže i 3 % za ostale izvore. Od 50 godina naviše odgovarajući izgledi iznose 2 % i 0,5 %. Svakoj osobi zatim neovisno odredimo ulazi li u anketu. Ta smo pravila zadali za ovu ilustraciju samoodabira.
U dobrovoljnu mrežnu anketu ulaze ljudi koji su na internetu, vide poziv i odluče odgovoriti. Svaki korak može mijenjati sastav. Simulacija takvog odabira daje 2 676 odgovora, mnogo više od početnog slučajnog uzorka od sto osoba. Prosječna dob je 32,1, umjesto populacijskih 42,2 godina. Mreže bira 47,8 %, naspram 26,8 %, a povjerenje je 4,42, naspram 4,88.
Čak i uz dobar okvir i slučajni odabir dio pozvanih može izostati. Neodgovor smanjuje uzorak i preciznost, a može donijeti i pristranost. Ako se odazvani i neodazvani razlikuju u obilježju koje procjenjujemo, primjerice zbog interesa za temu ili povjerenja u istraživača, sam slučajni odabir nije dovoljan. Provjeravamo i odabir i odaziv.
Velik pristran uzorak može dati uzak interval oko sustavno pogrešne vrijednosti. Standardna pogreška prikazuje slučajnu promjenjivost pod nacrtom, ali ne i svu pristranost odabira. Povećanje uzorka uz isti pristrani postupak zato ne jamči točniju procjenu.
Sada možemo objasniti promašaj časopisa Literary Digest. Na temelju naknadne Gallupove ankete Squire je utvrdio da su pogrešnoj prognozi pridonijeli i sastav primatelja i njihov nejednak odaziv (Squire 1988.). Njegova analiza upućuje na to da bi potpuni odaziv izabranih primatelja, unatoč problemu njihova odabira, barem ispravno imenovao Roosevelta kao pobjednika (Squire 1988.). Zato popis onih kojima smo poslali pitanje i popis onih koji su odgovorili pregledavamo zasebno. Još odgovora prikupljenih na isti način može smanjiti slučajno kolebanje, dok sustavno odstupanje ostaje.
Zadržavamo sedam polja kartice za čitanje ankete iz poglavlja o mjerenju. Sada pitanja unutar tih polja preciziramo znanjem o procjeni i margini. Svako polje pokazuje dio postupka koji određuje na koga se rezultat može odnositi.
| Polje kartice | Pitanje nakon ovoga poglavlja |
|---|---|
| okvir i pozivanje | Koja je ciljna populacija, tko je mogao ući u uzorak i je li odabir vjerojatnosan? |
| odaziv i nedostajanje | Koliko je pozvanih odgovorilo i kako bi se neodazvani mogli razlikovati? |
| procjena s težinama | Kako su uključivanje i sastav prilagođeni težinama i što ostaje neprilagođeno? |
| mjerenje | Kako glasi pitanje i koji odgovor ulazi u brojnik i nazivnik? |
| provedba | Kada i kako je anketa provedena te tko ju je naručio? |
| doseg | Na koju se podskupinu procjena odnosi i koga okvir, odaziv ili filtri izostavljaju? |
| nesigurnost | Uvažava li račun težine, slojeve i skupine stvarnoga nacrta? |
Korpus kao uzorak
Iste granice odabira susrećemo kada umjesto ljudi prikupljamo njihove tekstove. I korpus tekstova zahtijeva ciljnu populaciju. Za opis političke rasprave trebamo navesti uključujemo li govore, intervjue ili objave, s kojih platformi ili arhiva, iz kojeg razdoblja, na kojim jezicima i od kojih govornika. Dostupnost tekstova tek je polazište. Populaciju određujemo prema sadržajnom pitanju i navedenom obuhvatu.
Obrisane i privatne objave mogu izostati iz arhiva, stariji sadržaj biti nedostupan, a odabrana ključna riječ propustiti relevantne tekstove. Veći broj riječi ne uklanja takve propuste ni činjenicu da su se neki govornici sami odlučili oglasiti. Zaključak zato ograničavamo na obuhvaćene vrste tekstova, platforme, datume, jezike i govornike.
Treba odrediti i jedinicu brojanja. Brojanje riječi daje više težine duljim tekstovima, a brojanje objava aktivnijim govornicima. Udio govornika odgovara na drugo pitanje. Uz zastupljenost zato navodimo brojimo li riječi, tekstove, istupe ili ljude, ponavljaju li se jedinice istog govornika i koji nazivnik koristimo.
Jedan dio korpusa možemo upotrijebiti za izradu pravila, a drugi sačuvati za provjeru na jedinicama koje pri izradi nismo vidjeli. Ista osoba ili gotovo isti tekst ne smije se naći s obiju strana takve provjere. Time provjeravamo predviđanje na novim jedinicama iz sličnog procesa prikupljanja. Ta podjela ne popravlja pokrivenost korpusa niti opravdava zaključak o izostavljenim tekstovima i govornicima. Prediktivna provjera i populacijsko uopćavanje zahtijevaju zasebna obrazloženja.
Isti upitnik, različiti putovi do sudionika. Usporedba Pew Research Centera, objavljena 2023., koristila je isti upitnik u šest internetskih uzoraka odraslih stanovnika SAD-a. Tri su nastala iz panela s vjerojatnosnim početnim odabirom, a tri dobrovoljnim pristupanjem. Procjene su uspoređene s vanjskim referentnim vrijednostima, među kojima su bili službeni izborni rezultati i podaci kvalitetnih državnih anketa (Mercer i Lau 2023.). Ispunjavanje obrasca na internetu bilo je zajedničko svima. Put kojim je osoba došla do obrasca razlikovao se.
Mercer, Andrew, i Arnold Lau. 2023. Comparing Two Types of Online Survey Samples. Pew Research Center. https://www.pewresearch.org/methods/2023/09/07/comparing-two-types-of-online-survey-samples/.
Procjene iz panela s vjerojatnosnim odabirom u toj su usporedbi u prosjeku manje odstupale od referentnih vrijednosti, uz isti postupak ponderiranja svih uzoraka (Mercer i Lau 2023.). Referentne vrijednosti također mogu imati pogrešku, pa ih čitamo kao najbolju dostupnu usporedbu (Mercer i Lau 2023.). Kad sljedeći put otvorimo mrežnu anketu, vrijedi pogledati kako smo dobili poziv i tko ga uopće može dobiti. Oznaka „internetska anketa” sama po sebi još ništa ne govori o tom odabiru.
Pri objašnjavanju koristi većeg uzorka brojčani rezultat treba povezati s onim što je u postupku uzorkovanja doista postalo preciznije.
Za objašnjenje standardne pogreške pripremamo nastavnu usporedbu dviju veličina uzorka. U zadanom modelu nasumično i neovisno izvlačimo osobe iz iste zamišljene populacije. Standardna devijacija njihova dnevnog vremena uz medije iznosi 20 minuta. Tablica sadrži teorijske vrijednosti prema tom modelu, a ne rezultate provedene ankete.
| Veličina uzorka | Standardna devijacija u populaciji | Standardna pogreška sredine |
|---|---|---|
| 25 osoba | 20 minuta | 4 minute |
| 100 osoba | 20 minuta | 2 minute |
Asistent je ispod usporedbe napisao objašnjenje.
Veći nasumični uzorak daje užu distribuciju uzoračkih sredina. Standardna pogreška pada s četiri na dvije minute, pa se i vremena pojedinaca u većem uzorku međusobno razlikuju upola manje.
Uz svaki od posljednjih dvaju stupaca dopišite čiju raspršenost opisuje. Provjerite račune standardne pogreške, a zatim preoblikujte drugu rečenicu objašnjenja tako da zadrži točan podatak iz tablice.
Razrađeni primjer
Za spremnost na plaćanje sada povezujemo dvije provjere koje smo dosad promatrali odvojeno. Želimo znati gdje su procjene usredotočene i koliko su raspršene, iako izvorna varijabla ima mnogo nula i dug desni rep. Odaberemo uzorak, izračunamo sredinu i postupak ponovimo mnogo puta. Mnoge kasnije formule opisivat će ili približno izražavati rezultat takvog ponavljanja unutar određenog modela.
Jedan korak možemo pratiti na zasebnoj, namjerno sastavljenoj ilustraciji s iznosima 0, 0, 10, 20 i 70 eura. Sredina je \(100/5 = 20\) eura. U ponavljanju zamjenjujemo cijeli uzorak, uključujući moguće nule, novim odabirom iz svih 50 000 osoba. Svaki novi uzorak ostavlja samo jednu sredinu u raspodjeli koju uspoređujemo.
Isti ćemo postupak provesti s dvjema veličinama uzorka. Ako veći uzorak daje užu raspodjelu sredina, provjerit ćemo smanjuje li se njezina širina onako kako predviđa odnos s korijenom veličine uzorka. Zasebno ćemo pregledati je li se promijenio i njezin oblik.
Prikaži kod
uzmi_sredinu <- function(n) {
  mean(sample(populacija_medija$spremnost_platiti, n))
}

sredine_5 <- replicate(4000, uzmi_sredinu(5))
sredine_60 <- replicate(4000, uzmi_sredinu(60))

c(
  populacija = mean(populacija_medija$spremnost_platiti),
  sredina_5 = mean(sredine_5),
  sredina_60 = mean(sredine_60),
  se_5 = sd(sredine_5),
  se_60 = sd(sredine_60)
)
populacija sredina_5 sredina_60 se_5 se_60
6,126660 6,100150 6,144362 6,185099 1,790483 replicate ponavlja izraz i sprema rezultate. Prosjek četiri tisuće sredina iz uzoraka od pet osoba je 6,10 eura, a iz uzoraka od šezdeset 6,14 eura. Populacijska sredina je 6,13 eura. Obje veličine uzorka daju procjene usredotočene blizu nje, u skladu s nepristranošću.
Standardna pogreška pada s 6,19 za pet osoba na 1,79 za šezdeset, odnosno 3,5 puta. To je približno korijen iz dvanaest, koliko smo puta povećali uzorak. Raspodjela sredina za pet osoba ipak ostaje vidljivo asimetrična. Nepristranost procjenitelja zato treba razlikovati od normalnog oblika njegove raspodjele.
Provjeru smo mogli napraviti jer poznajemo cijelu generiranu populacija_medija. U stvarnom istraživanju obično raspolažemo samo jednim uzorkom i ne možemo ponavljati odabir iz potpuno poznate cjeline. Zato svojstva distribucije uzorkovanja procjenjujemo iz tog uzorka, uz pretpostavke. U poglavlju o procjeni uzorak će privremeno preuzeti ulogu populacije i omogućiti novo ponavljanje postupka.
Za računsku provjeru pretpostavimo neovisna opažanja i standardnu devijaciju od 12 minuta. Pri 36 opažanja standardna pogreška sredine iznosi \(12/\sqrt{36}=2\) minute, a pri 144 opažanja jednu minutu. Raspršenost pojedinačnih odgovora ostaje 12 minuta. Četverostruko veći uzorak prepolovio je nesigurnost sredine, uz istu raspršenost odgovora pojedinačnih ljudi.
Približenje \(1/\sqrt{n}\) za 95-postotnu marginu udjela odnosi se na jednostavni slučajni uzorak, malu uzoračku frakciju i najnepovoljniji udio od 0,5. Nastaje iz \(1,96\sqrt{0,25/n}\) uz zaokruživanje 0,98 na jedan. Nije opća formula za svaki udio i svaki nacrt. Kalibracija težina usklađuje ponderirane zbrojeve s poznatim obilježjima populacije. Razlikuje se od kalibracije prognoze, koja uspoređuje najavljene vjerojatnosti s ishodima.
Sažetak
Ponavljanjem odabira dobili smo distribuciju uzorkovanja i razdvojili promjenjivost procjene od razlika među pojedinačnim osobama. Standardna devijacija te distribucije jest standardna pogreška, koja za sredinu u jednostavnom slučajnom uzorku pada približno s korijenom veličine uzorka, uz dodatnu korekciju kada obuhvaćamo znatan dio populacije. Kad nacrt uključuje težine, skupine i slojeve, račun mora pratiti te odluke, a njihove posljedice za preciznost opisujemo učinkom nacrta i efektivnom veličinom uzorka. Takav račun ne obuhvaća automatski probleme pokrivenosti, neodaziva ili samoodabira, koje ni veći uzorak ni kalibracija sami ne uklanjaju. I za korpus tekstova zato odvojeno obrazlažemo odabir i procijenjenu nesigurnost. U poglavlju o procjeni iz te nesigurnosti gradimo interval za nepoznatu populacijsku vrijednost.
Distribucija i raspodjela ovdje su sinonimi. Statistika kao broj iz uzorka razlikuje se od statistike kao znanstvene discipline. Ponderiranje znači primjenu težina. Neodaziv, nazvan i neodgovor, znači da za pozvane jedinice nedostaju odgovori.
Pojmovi
- populacija
- population
- uzorak
- sample
- parametar
- parameter
- statistika
- statistic
- pogreška uzorkovanja
- sampling error
- distribucija uzorkovanja
- sampling distribution
- nepristranost
- unbiasedness
- standardna pogreška
- standard error
- središnji granični teorem
- central limit theorem
- uzorački udio
- sample proportion
- margina pogreške
- margin of error
- jednostavni slučajni uzorak
- simple random sample
- korekcija za konačnu populaciju
- finite-population correction
- vjerojatnosno uzorkovanje
- probability sampling
- težina uzorkovanja
- sampling weight
- procjena s težinama
- weighted estimate
- kalibracija
- calibration
- grupno uzorkovanje
- cluster sampling
- učinak nacrta
- design effect
- efektivna veličina uzorka
- effective sample size
- pokrivenost
- coverage
- neodgovor
- nonresponse
- prigodni uzorak
- convenience sample
- samoodabir
- self-selection
Zadaci
Konceptualni
Razlikujte raspodjelu pojedinačnih opažanja od distribucije uzoračkih sredina. Za svaku navedite što joj je jedinica, što mjeri njezina širina i što se s njom događa kada uzorak naraste. Predajte skicu obiju raspodjela i dva popratna objašnjenja.
Računski
Upotrijebite tablicu opaženoga uzorka iz sintetičke konačne populacije. Bez programa izračunajte brojnik, nazivnik i postotak prvo bez težina, a zatim s težinama uzorkovanja. Objasnite zašto se procjena pomaknula prema dolje i navedite jednu pogrešku koju taj pomak ne može ispraviti. Predajte oba računa i dvije rečenice tumačenja.
U zasebnom jednostavnom slučajnom uzorku iz velike populacije standardna devijacija obilježja iznosi 12. Izračunajte standardnu pogrešku sredine za uzorke od 64 i 256 osoba. Koliko se puta mora povećati uzorak da se pogreška prepolovi? Za udio 0,5 u uzorku od 400 osoba procijenite 95-postotnu marginu pravilom \(1/\sqrt{n}\) i navedite pretpostavke toga pravila.
Za obje veličine uzorka izračunajte i 1,96 standardnih pogrešaka te navedite približan raspon odstupanja uzoračke sredine od populacijske sredine kada vrijedi normalno približenje. Riječima protumačite dobivenu marginu udjela.
Neobvezna nadogradnja dostupna je samo čitatelju s vlastitom službeno preuzetom kopijom ESS Round 11, edition 3.0. Slijedeći portalnu putovnicu iz kataloga, ograničite podatke na Hrvatsku, za vote primijenite njegov službeni valjani nazivnik te usporedite procjenu bez težina s procjenom uz zadani anweight. Navedite i jednu pogrešku odabira ili mjerenja koju ta težina ne može ukloniti. Rezultat tumačite kao samoprijavu, ne kao provjeru službene izlaznosti. ESS mikropodaci i rezultat te provjere nisu dio knjige ni obveznoga zadatka.
Kritički
Vratite se na karticu za čitanje ankete iz poglavlja o mjerenju i dizajnu i primijenite je na slučaj časopisa Literary Digest (Squire 1988.). Za ciljnu populaciju, okvir, regrutiranje, broj pozvanih i odgovora, datume, formulaciju pitanja, težine, naručitelja i marginu pogreške označite što je iz prikazanoga slučaja poznato, a što nije. Zatim odvojite pogrešku pokrivenosti i neodgovor od slučajne promjenjivosti te objasnite zašto veći broj poslanih listića ne rješava prva dva problema. Ne dopunjujte nepoznata polja pretpostavkama. Predajte ispunjenu karticu i jedan odlomak zaključka.
Squire, Peverill. 1988. „Why the 1936 Literary Digest Poll Failed“. Public Opinion Quarterly 52 (1): 125–33. https://doi.org/10.1086/269085.
Revizija modela
Ocijenite analizu modela iz okvira o pogrešci. Izdvojite tvrdnju koja je točna, imenujte zamjenu dviju razina varijabilnosti i napišite ispravljenu verziju druge rečenice koja zadržava sve što je u njoj bilo točno.